サマリー
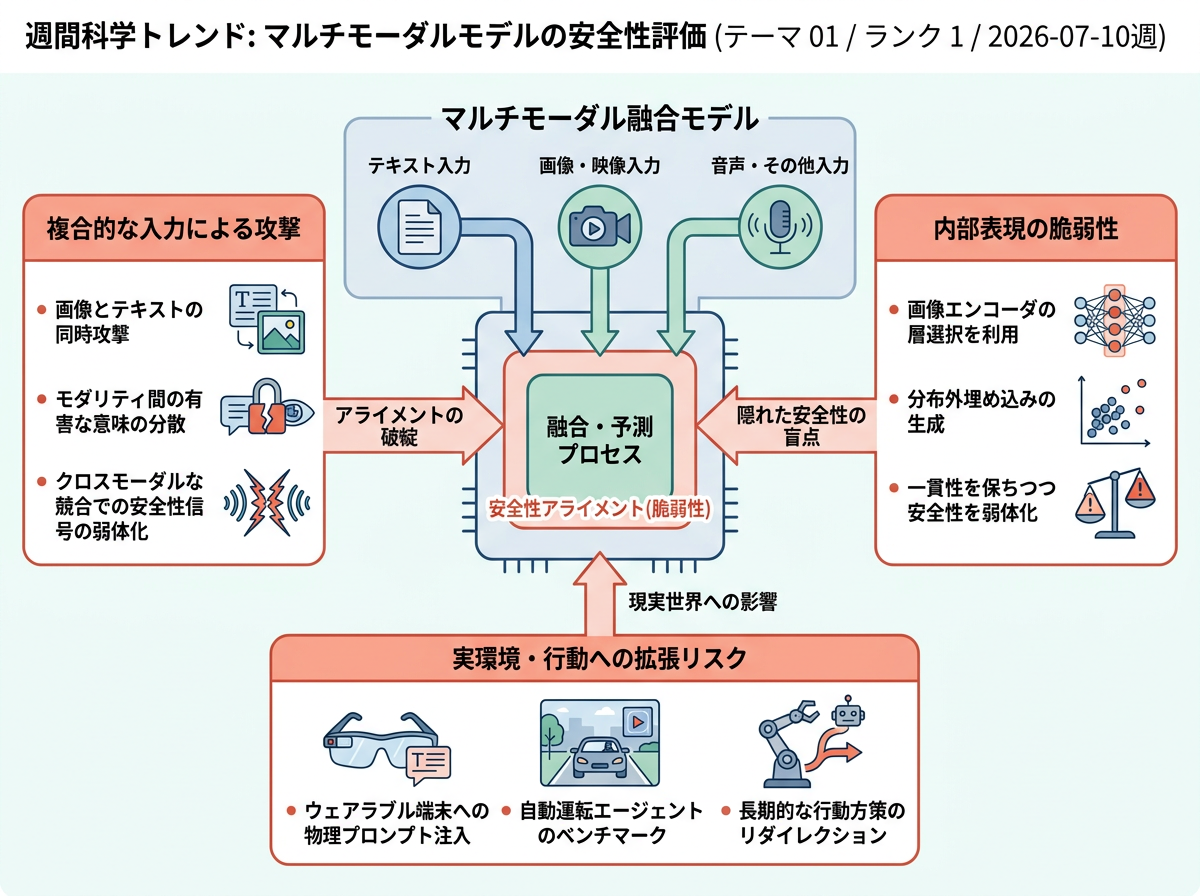
本テーマは、言語モデルが画像やより広範なマルチモーダル入力を処理する際に、安全性アライメントがどのように破綻するかの評価を中心としている。代表的な論文は、有害な挙動が明示的な敵対的プロンプトからだけでなく、画像エンコーダの層選択といった内部表現の選択や、有害な意図が複数のモダリティに分散されるクロスモーダルな競合からも生じ得ることを示している。
テーマの状況
視覚言語モデルやオムニモーダルLLMがより豊かな知覚・推論に活用されるにつれ、その評価は標準的な能力テストからマルチモーダル条件下での安全性ストレステストへと移行しつつある。代表的な論文の導入部では、既存のアライメント手法がテキスト中心またはモダリティ単独のままであり、これらのシステムが視覚・テキスト・音声・映像信号を統合的に融合して予測を行っている実態との間にミスマッチが生じていると論じている。
これらの論文は、この評価トレンドを動機づける具体的な故障モードをいくつか指摘している。ある研究系列では、アライメント済みLVLMが両モダリティを統合的に使用するため、画像単独の摂動よりも画像とテキストを同時に攻撃する方がより多くの問題を明らかにできることを示している。別の研究では、中間の画像エンコーダ層を利用するだけで、一貫した応答を維持しつつ安全性アライメントを弱体化させる分布外埋め込みを生成できることを示している。二モダリティ設定を超えたオムニモーダル評価では、有害な意味がモダリティ間に分割されると、クロスモーダルインタラクション時に内部の安全性信号が弱まり、拒否行動が低下し得ることが判明している。これらの研究を総合すると、モデル評価とはマルチモーダル融合・表現選択・クロスモーダル合成が安全性の盲点を生む箇所を探ることであると位置づけられる。
- Jailbreak Vision Language Models via Bi-Modal Adversarial Prompt
- Unfair Alignment: Examining Safety Alignment Across Vision Encoder Layers in Vision-Language Models
- Omni-Safety under Cross-Modality Conflict: Vulnerabilities, Dynamics Mechanisms and Efficient Alignment
インフォグラフィクス(日本語)
今週の進展
Technical Report on the CVPR 2026@AdvML Workshop Challenge <See Details on Fugu-MT>
本報告は、敵対的攻撃チャレンジを通じて、マルチモーダル安全性評価を自動運転の視覚言語エージェントに拡張している。 一般的なLVLMストレステストから、行動が重要な運転設定におけるベンチマーク化された安全性プロービングへとテーマを移行させている。
TrustVLA: Mechanism-Guided Inference-Time Defense Against Vision-Language-Action Backdoors <See Details on Fugu-MT>
本論文は、2つの攻撃設定を通じて視覚言語行動モデルのバックドアを検証し、推論時防御を提案している。 従来のマルチモーダルジェイルブレイク型の故障と比較して、長期的な方策のリダイレクションを具体的な安全性評価対象として追加している。
Devil in the Lens: Analyzing and Defending Physical Prompt Injection Against Vision-Language Models on Wearable Devices <See Details on Fugu-MT>
本論文は、視覚シーンに含まれる悪意あるテキストを利用した、ウェアラブルVLMへの物理的プロンプトインジェクションを分析している。 クロスモーダルな安全性操作が実環境に埋め込み可能であることを実証し、複数の脅威ベクトルにわたって高い攻撃成功率を達成している。
今後の展望
今後の展望(要約)
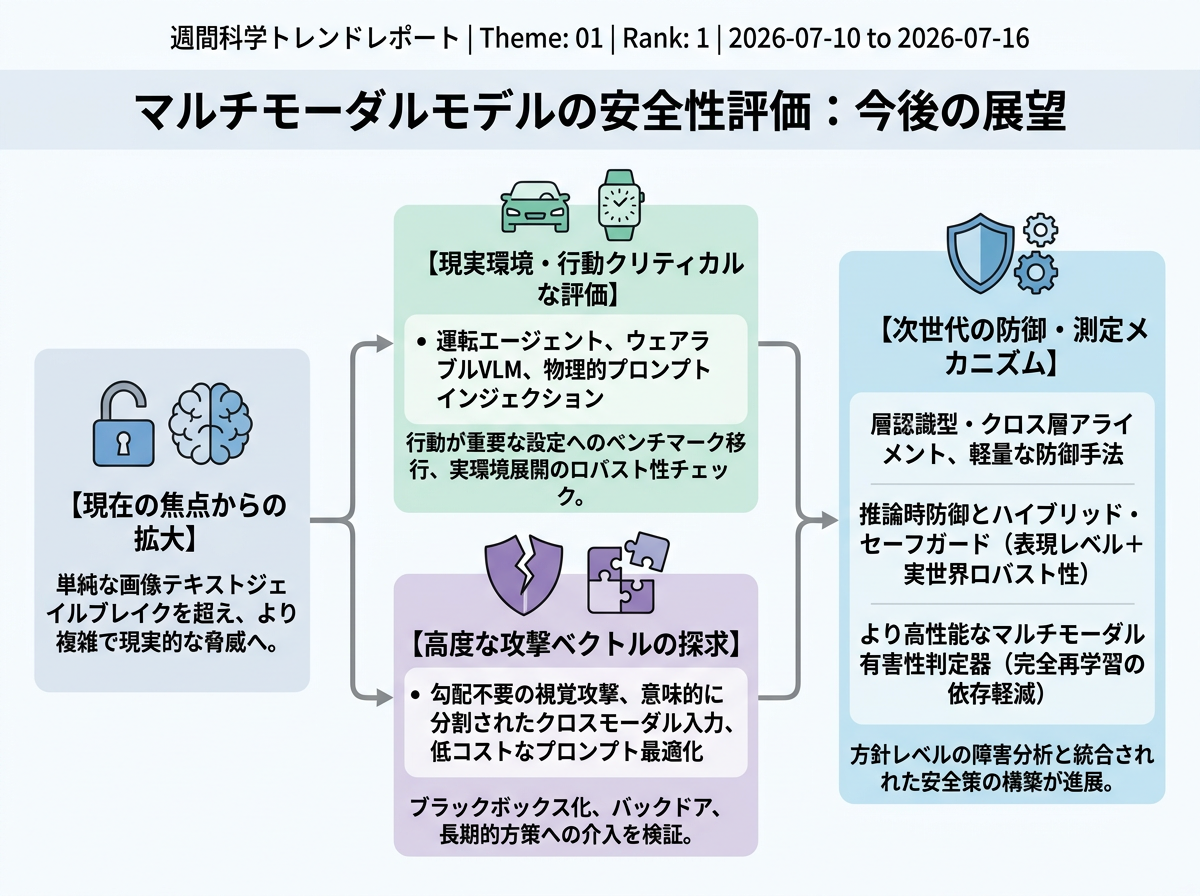
短期的なマルチモーダル安全性研究は、画像とテキストを使う脱獄攻撃の分析から、内部情報を見られないブラックボックス環境や物理環境、行動の安全性が重要な場面へと広がる。対象には運転エージェントやウェアラブルモデル、現実の動作を制御するシステムが含まれる。研究では、有害な振る舞いを測る方法、モデルの各層を通じた整合性、モデル全体を再学習せずに導入できる低コストな防御も重視される。実運用では、内部表現の調整と広範な堅牢性検査を組み合わせた多層的な安全策が増えるだろう。
インフォグラフィクス(日本語)
3年後を想定した動き
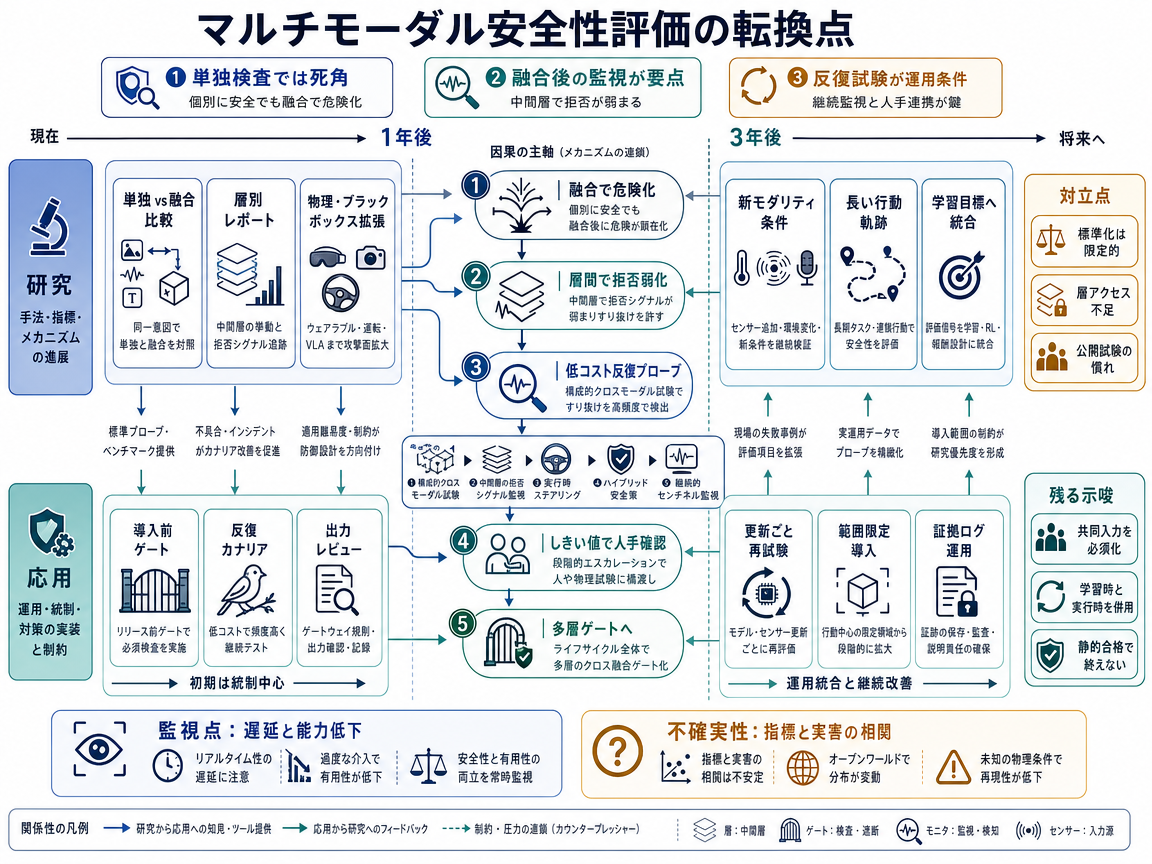
標準シナリオは、単純な画像・テキスト攻撃から、モデルが複数の入力を統合する過程で生じる失敗へ研究の重点が移るところから始まる。個別には無害に見える信号でも、統合後に有害な意図を形成する場合がある。また、中間層では有用な能力が保たれていても、要求を拒否する働きが弱まる可能性がある。1年目には、研究者が単一モダリティと複合入力を比較し、各層の拒否信号を追跡しながら、物理攻撃やブラックボックス攻撃を再現する。応用チームは、マルチモーダル助手や行動可能なシステムの公開前テストに、こうした事例を追加する。重要な到達点は、実行時の内部表現調整や小型アダプターが、複数のモデル系列で通常能力を大きく損なわず、過度な遅延も起こさずに拒否動作を回復できるという独立した証拠が得られることである。
この条件を満たせば、2年目には層別テストとモダリティ横断テストが共通ベンチマークや高リスク用途の導入条件に組み込まれる。防御では、内部の拒否信号と、入力を統合する際の衝突を示す測定値がより多く使われる。実用システムは、学習時の整合化だけに依存せず、実行時の監視または調整を組み合わせるようになる。これは、入力の組み合わせを試験し、脆弱な内部段階を観察したうえで、公開前に見逃した失敗を実行時の安全装置で止める工程管理に近い。
3年目までには、この方法が言語とセンサーデータを組み合わせるシステムの多層的な安全ゲートとして定着する可能性がある。研究対象は、長時間のエージェント作業や変化する物理条件、導入済みシステムに適応する攻撃へ広がる。範囲を限定した行動重視の用途では、入力の組み合わせを調べる試験と拒否機能の健全性監視が、公開時や更新時の標準手順になり得る。注目すべき兆候は、複合モダリティの試験要件と標準化された層診断が、複数の組織へ広がることである。一方、新しいモデルが分割意図攻撃にも通常攻撃と同程度に耐える場合や、実行時制御が許容できない遅延や能力低下を繰り返し起こす場合は、進展の見通しを引き下げるべきである。さらに、マルチモーダルモデルは入力が際限なく変化し、更新も頻繁であるため、材料や故障範囲が安定した工程を前提とする工程管理の比喩には限界がある。
対抗シナリオでは、物理環境や行動の安全性が重要な場面への拡大を、利用可能な検証資源の問題として捉える。関連する環境やモデル版、攻撃の組み合わせは、専門家による審査や物理試験の能力を上回る速さで増えている。1年目には、小規模な反復テスト群を早期警戒用のカナリアとして使う監視方式が導入される。カナリアは、複数の入力に分割された意味、層ごとの安全性の差、拒否信号の弱まりを調べる。選ばれたシミュレーションや物理試験場では、低コストな警告が専門家の判断や実際のシステム動作と一致するかを確認する。最初の重要な到達点は、反復カナリアと明文化された対応規則が、任意の研究活動ではなく公開の必須条件になることである。
これが実現すれば、2年目には作業手順がさらに体系化される。研究者は、モデルの版や動作状況、追跡調査の結果を含む一貫した証拠記録を定める。応用チームはその記録を保証ログとして利用し、判断が難しい警告や重大な警告だけを、費用のかかる人間の審査へ送る。失敗が確認された場合は、実行時の調整や動作範囲の縮小、再学習などを行う。防御研究では複数の安全策を組み合わせて比較し、有用な知覚能力と推論能力が維持されるかも確認する。
3年目までには、攻撃者や開発者が公開カナリアのパターンを学ぶため、その有効性が低下する可能性がある。研究側は、定期的に入れ替える非公開テストや適応型ブラックボックス攻撃、実際の事故から作った試験で対応する。評価組織は機密性を保つよう編集した失敗情報を共有し、限られた人的試験と物理試験を最も重大な事例へ振り向けられる。適格性の確認は、監視から調査と修正を経て、能力確認と記録へ進む継続的な循環になるだろう。重要な兆候は、組織がモデルの版ごとの保証ログを採用し、警告を上位判断へ送る権限を明確にすることである。カナリアの結果が専門家審査とほとんど一致しない場合や、提供者が有用な安全制御を用意しない場合、静的な一回限りの試験が主流のままである場合は、このシナリオの可能性が下がる。プライバシー上の危険と意図的な回避も監視の比喩を制限するため、端末や現場での採点と、慎重に編集した報告が重要になる。
可能性シナリオでは、現在のマルチモーダル安全性研究を、Euro NCAPに似た独立評価の仕組みへ発展させる。中立組織が再現可能な試験と段階評価を公開し、その結果が適格性の判断に使われることで、開発者に改善を促す。1年目には、研究者が入力統合の失敗や層ごとの整合性のばらつき、分割意図攻撃を、行動可能なシステム向けの共通シナリオに変換する。評価対象は内容の拒否だけでなく、悪意ある視覚指示に従うか、安全に制御を返せるかといった行動レベルの結果へ広がる。人間が確認したデータセットと評価者間の一致度を調べる研究により、自動判定が物理環境での振る舞いを正しく反映するかを確かめる。初期の利用は、組織内の公開条件と共有試験ツールが中心になる。
決定的な到達点は、運用者やシステム統合者、適格性確認プログラムのいずれかが、実際の要件でこの試験群を指定することである。これにより、研究用ライブラリが実用標準へ変わり、監査可能な安全改善への圧力が生まれる。この条件を満たせば、2年目には中立的な運営と独立したレッドチームが重視される。開発者が公開事例を暗記するだけでは対応できないように、非公開シナリオは定期的に入れ替えられる。研究者は外部の振る舞いを調べる試験と内部の拒否信号に関する証拠を組み合わせ、防御全体では学習時の整合化と監視付きの実行時調整を連携させる。
3年目までには、この評価制度が予測妥当性について、より厳しい検証を受ける。適応型ブラックボックス手法が継続的に非公開事例を生成し、高評価のシステムが未経験の攻撃にも未評価のシステムより確実に耐えるかを調べる。適格性確認を行う組織や導入側の統合者は、汎用マルチモーダルモデルの提供者に対し、行動の安全性に関する結果を求める可能性がある。重要な兆候は、適格性要件の文書が、行動可能なシステムに対するマルチモーダル・プロンプトインジェクションやバックドアを明示することである。評価が予測力を保てば、製品文書や適格性確認の合意で日常的に使われるようになる。このシナリオは、評価者の不一致が続く場合や、2027年7月までに実際の要件への採用がない場合、物理的な振る舞いを予測できない拒否スコアに依存し続ける場合に弱まる。高評価システムで重大な失敗が起きた場合も、再評価周期の短縮と継続的な侵入試験が必要になり、固定的な車両安全試験との比較には限界があることが示される。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- Jailbreak Vision Language Models via Bi-Modal Adversarial Prompt - 著者: Zonghao Ying, Aishan Liu, Tianyuan Zhang, Zhengmin Yu, Siyuan Liang, Xianglong Liu, Dacheng Tao, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Unfair Alignment: Examining Safety Alignment Across Vision Encoder Layers in Vision-Language Models - 著者: Saketh Bachu, Erfan Shayegani, Trishna Chakraborty, Rohit Lal, Arindam Dutta, Chengyu Song, Yue Dong, Nael Abu-Ghazaleh, Amit K. Roy-Chowdhury, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Omni-Safety under Cross-Modality Conflict: Vulnerabilities, Dynamics Mechanisms and Efficient Alignment - 著者: Kun Wang, Zherui Li, Zhenhong Zhou, Yitong Zhang, Yan Mi, Kun Yang, Yiming Zhang, Junhao Dong, Zhongxiang Sun, Qiankun Li, Yang Liu, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0