サマリー
今週のテーマは、身体性世界モデルをリアルな未来の生成だけでなく、ロボットポリシーの評価・監督・改善に活用することに焦点を当てている。代表的な論文は、大規模インタラクションデータからの行動条件付き予測が、より優れた物理推論、転移可能な表現の強化、合成データやモデルベース強化学習を通じたデータ効率の高いビジョン・言語・行動学習をもたらしうると主張している。
テーマの状況
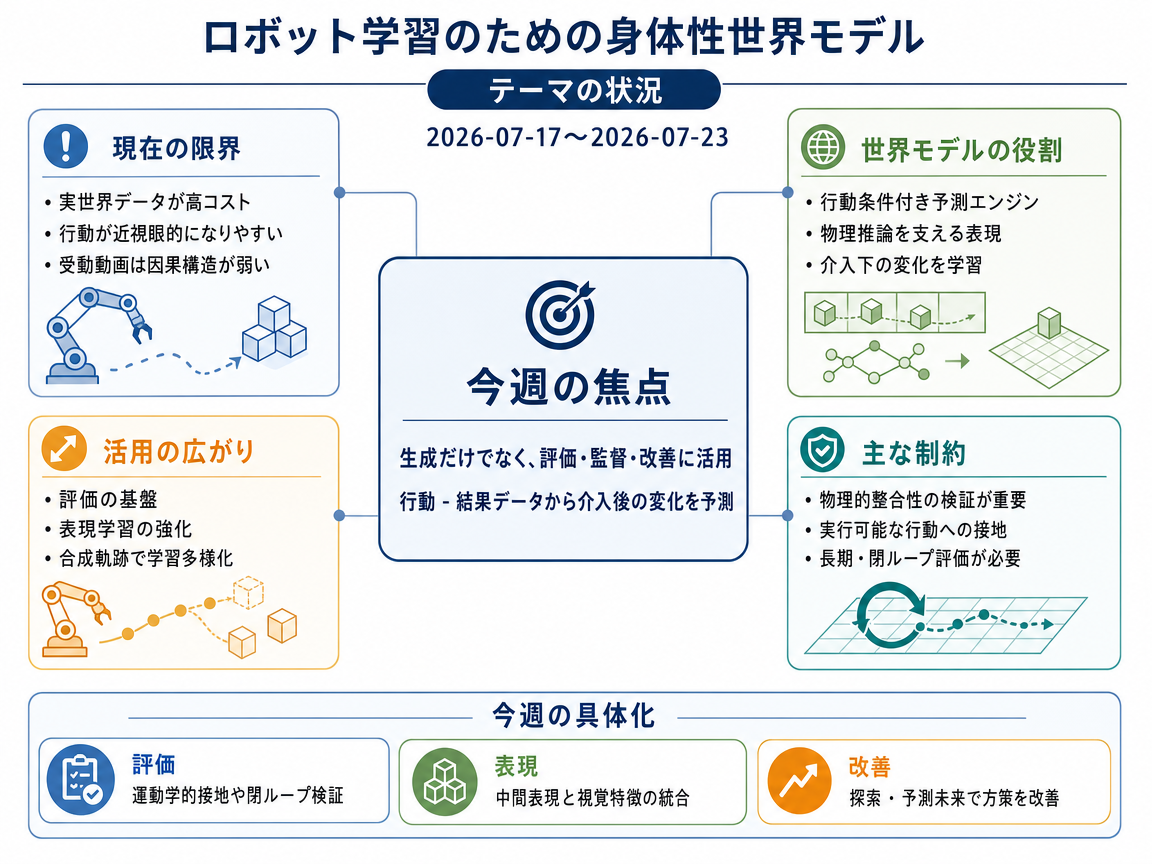
代表的な論文の導入部は、現在のロボット学習における共通の限界を描いている。強力なビジョン・言語・行動システムは依然として高コストな実世界インタラクションデータに大きく依存し、近視眼的に行動することが多い一方、受動的な動画モデルはリアルに見えても物理推論に必要な因果構造を捉えられない。これに対し、これらの論文は身体性世界モデルを行動-結果データで訓練された予測エンジンとして位置づけ、世界がどのように見えるかだけでなく、介入の下でどのように変化するかをモデルが学習できるようにしている。
この枠組みの中で、重点は純粋な生成から評価と表現の活用へと移行している。WoWは物理的整合性、因果推論、実行可能な行動の接地をテストするベンチマークを提唱し、自己教師あり視覚特徴を拡散ベースの世界モデルに統合して知覚表現を強化している。GigaBrain論文群はこの論理を拡張し、世界モデルが生成した軌跡を用いて訓練の多様性を拡大し、予測された未来や価値にポリシーを条件付けることで、世界モデルを単独のシミュレータとしてではなく、先見性・監督・反復的ポリシー改善の源泉として扱っている。
- WoW: Towards a World omniscient World model Through Embodied Interaction
- GigaBrain-0: A World Model-Powered Vision-Language-Action Model
- GigaBrain-0.5M*: a VLA That Learns From World Model-Based Reinforcement Learning
インフォグラフィクス(日本語)
今週の進展
RynnBrain 1.1: Towards More Capable and Generalizable Embodied Foundation Model <See Details on Fugu-MT>
RynnBrain 1.1は2B、9B、122B-A10Bスケールにまたがる基礎モデルであり、身体的知覚、空間推論の局在化、計画立案をサポートする。また、統一的なクロスエンボディメント行動空間とエンボディメント固有のマスキングを備えたRynnBrain-VLAを開発し、Unitree G1、Astribot-S1、Tianji-Wujiに展開している。 論文の具体的なタスク、手法、エビデンス、または応用設定を通じて、モデル評価・表現学習に関連している。
Agentic Real2Sim: Physics-based World Modeling with Vision-Language Agents <See Details on Fugu-MT>
Agentic Real2Simは、ビジョン・言語エージェントを用いて記録されたロボットインタラクションを、剛体・変形体・ヒューマノイド設定にわたる物理ベースのシミュレーション可能なデジタルツインへ自動変換する。 手動または部分的なReal2Simパイプラインと比較して、下流のポリシー学習と評価のために明示的に設計された、現実に整合したツインを生成するエンドツーエンドのエージェントフレームワークを提供する。
RoboInter1.5: A Holistic Intermediate Representation Suite for Embodied World Modeling and Robotic Manipulation <See Details on Fugu-MT>
RoboInter1.5は、身体性世界モデルにおけるマニピュレーション指向の中間表現のための統一的なデータ、ベンチマーク、モデルスイートを提供する。 生の世界モデル出力に焦点を当てた従来の研究と比較して、マニピュレーション構造を中心に訓練と評価を体系化するための明示的な中間表現層を追加している。
Masked Visual Actions for Unified World Modeling <See Details on Fugu-MT>
Masked Visual Actionsは行動を部分的に明かされた視覚軌跡としてエンコードし、単一の事前訓練済み動画モデルが順方向ダイナミクスモデルと行動復元のための逆方向モデルの両方として機能することを可能にする。 エンボディメント固有の入力を用いた従来の行動条件付き動画予測とは異なり、モデル本来の視覚表現内で順方向と逆方向の推論を統一するピクセル空間の制御インターフェースを導入している。
KineBench: Benchmarking Embodied World Models via IDM-Free Kinematic Grounding <See Details on Fugu-MT>
KineBenchは、行動抽出に逆ダイナミクスモデルに依存せずに物理的整合性を評価する、身体性世界モデルのための閉ループベンチマークを導入する。 別途訓練されたIDMに依存する従来のベンチマークと比較して、物理的妥当性のより直接的な尺度としてIDM不要の運動学的接地を提供する。
PAVXploreRL: Physical-Action-Visual World Model Reinforcement Learning with Action Exploration <See Details on Fugu-MT>
PAVXploreRLは、スケーラブルなポリシー評価のために事前訓練済み潜在世界モデル上に行動探索を組み込んだ強化学習フレームワークを構築する。 世界モデルを主に予測や合成データ生成に使用する従来のアプローチと比較して、世界モデルベースの探索を通じた直接的なポリシー改善を実証している。
ABot-World-0: Infinite Interactive World Rollout on a Single Desktop GPU <See Details on Fugu-MT>
ABot-World-0は、エージェント駆動のデータ収集パイプラインを備え、行動条件付き動画世界モデルから単一デスクトップGPU上でリアルタイムの長期閉ループインタラクティブロールアウトを可能にする。 オフラインまたは短期予測的なセットアップと比較して、同期された行動・テキストアノテーションと訓練データキュレーションのための決定論的品質チェックを備えたスケーラブルなロールアウトを追加している。
今後の展望
今後の展望(要約)
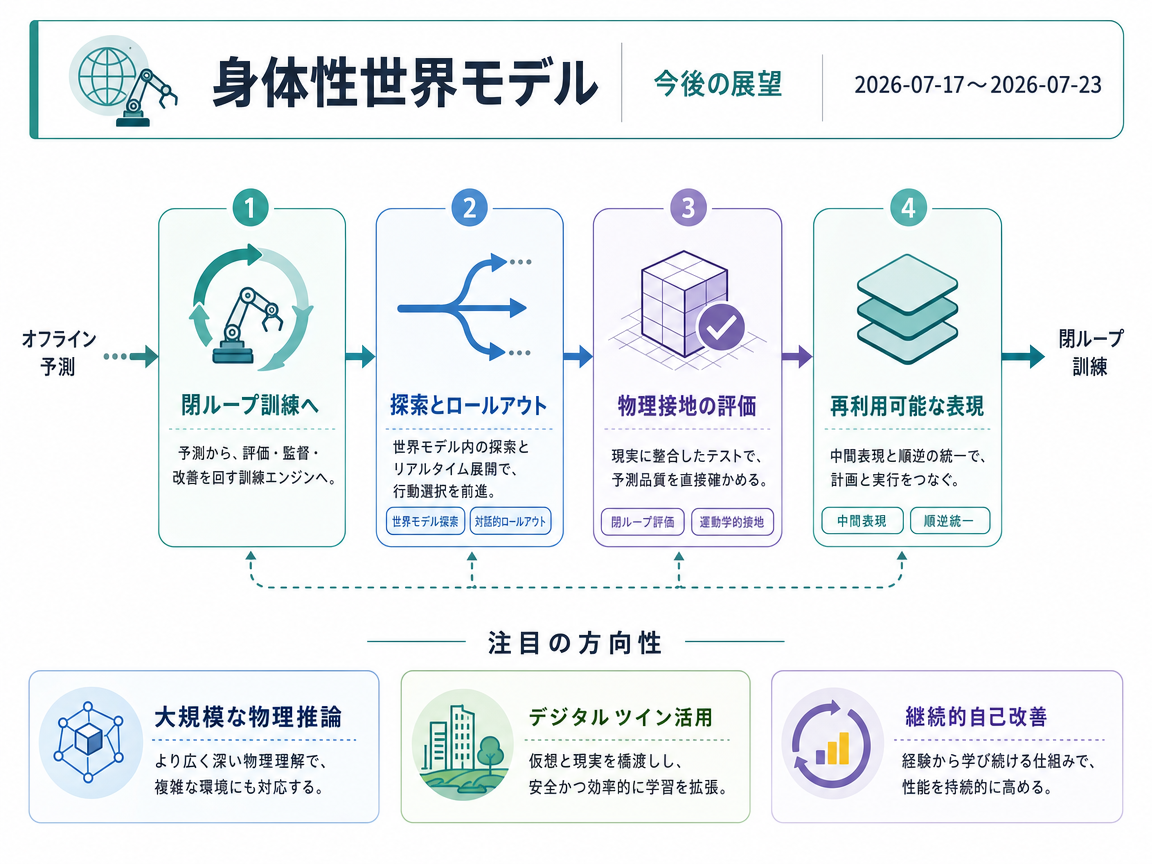
身体性を備えた世界モデルは、オフラインの予測システムではなく、実行結果を学習へ戻す閉ループ型の訓練基盤へ発展する可能性が高い。短期的には、想像した未来を強化学習、計画、行動選択へ直接結び付ける研究が進むだろう。今後の進歩には、物理法則に基づく表現と現実的な試験環境も必要であり、予測精度の向上がロボットの実行、評価、継続学習を本当に改善するかが問われる。
インフォグラフィクス(日本語)
3年後を想定した動き
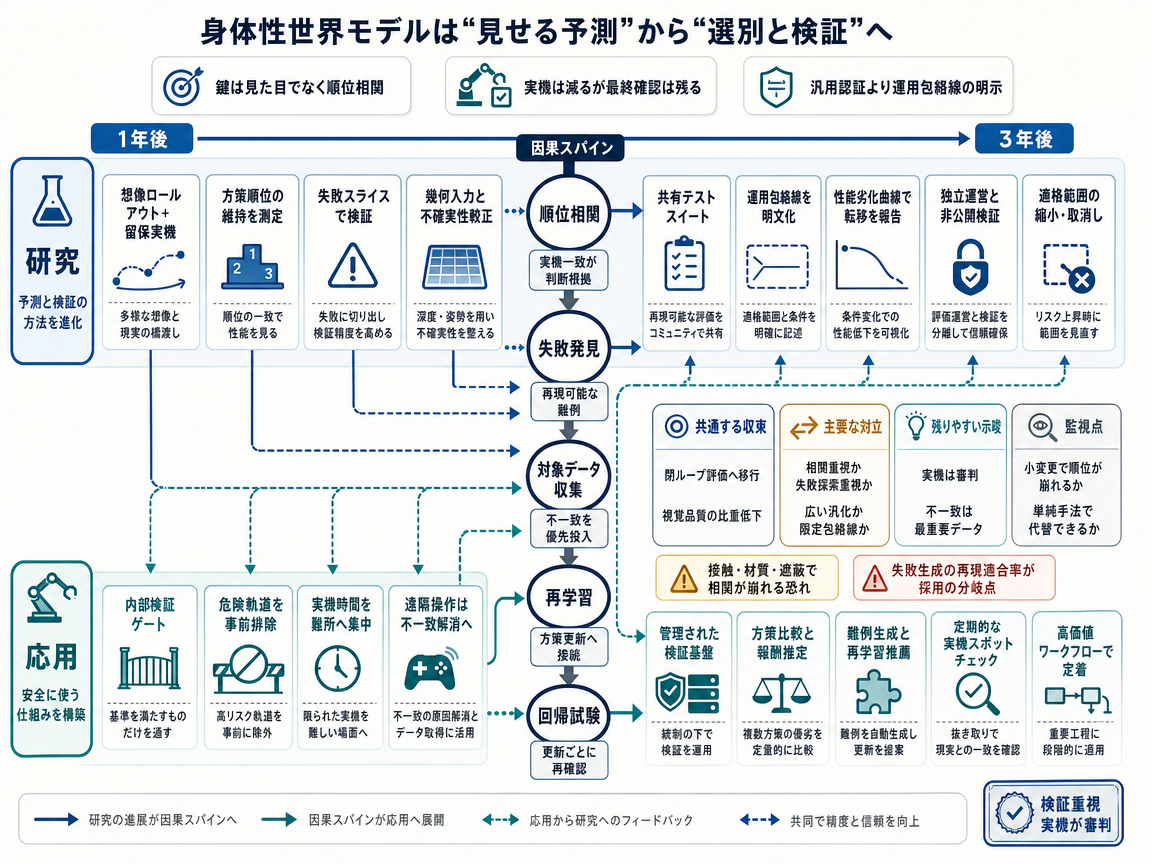
標準シナリオでは、身体性を備えた世界モデルが動画予測器からロボット学習の検証基盤へ変わる。中心となる仕組みは、想像上の結果と実機で有効な方策や軌道との相関である。候補行動の優劣を誤って判定するなら、見栄えのよい動画だけでは不十分である。
1年目には、シミュレーション上の展開と、学習に使っていない実機試験の結果を比較する。衝突、把持の失敗、長時間動作でのずれなどが重点的に調べられる。深度、特徴点、占有マップを使えば、写実的な予測に隠れた誤りを見つけやすくなる。重要な基準は、世界モデルによる事前選別が、同じ成功率に達するまでの実機試験を繰り返し削減できることである。
2年目には、成功した検証手順が、限られた範囲の操作ロボットや移動ロボットへ広がるだろう。各試験では、対象ロボット、センサー、作業環境を含む適用範囲を明確にする必要がある。モデルと実機の不一致は有用な学習事例となり、評価と方策更新の両方を改善する循環が生まれる。
3年目には、共通試験群が、用途を限定したロボットの比較や運用導入の判断に影響する可能性がある。統合システムは、模擬展開、行動提案、対象を絞った再学習を組み合わせつつ、実機での抜き取り確認を最終基準とする。注視すべき点は、機体や周辺環境が変わった後も、非公開の実機試験が方策の順位を裏付けるかどうかである。順位が別環境へ移らない場合や、小さなセンサー変更で効果が消える場合、このシナリオは弱まる。より単純な試験方法でも同程度に実機試験を減らせる場合も同様である。最終的には、ロボット能力の万能な認証ではなく、定義された機体と作業の組み合わせに対するシミュレーター型検証が実現する可能性が高い。
対抗シナリオでは、身体性を備えた世界モデルを、ロボット方策のカバレッジ指向テストに使う。これは、多様な入力を与えて不具合を探すソフトウェアのファジングに似ている。世界モデルは場面や行動列を変化させ、衝突、物体の落下、復旧の失敗といった事例を探す。実機での再現が最終確認となるため、モデルは世界全体を完全に再現する必要はなく、有用な端の事例を生成して優先順位を付けられればよい。
1年目には、行動を条件とする予測を、明確な失敗条件へ結び付ける研究が進む。深度や占有状態に基づく幾何学的検査により、明らかに不可能な事例を実機試験の前に除外できる。初期評価では、再現可能な失敗の発見数、実機での確認率、検証済み事例による方策改善を測る。主要な判断材料は、狙いを定めた失敗生成が、同量の広範な合成経験より有用な発見を生むという再現結果である。
2年目には、確認済みの失敗を蓄積する回帰テスト群が一般化するだろう。方策を更新するたびに過去の失敗を再試験し、モデルは関連する事例や、さらに難しい変種を探索する。研究チームは、どの作業状態や復旧経路を実際に試したかを表す行動カバレッジも測定する。共通インターフェースによって失敗事例集を複数の方策や機体で再利用できる可能性はあるが、異なる機体間の移行は難しいままである。
3年目には、この仕組みが特定のロボット運用を継続的に保証する層となる可能性がある。世界モデルが試験を提案して優先順位を付け、従来型シミュレーター、限定的な実機再現、人間の確認が結果の信頼性を判断する。回帰履歴は実環境での確認を置き換えずに、導入判断や問題分析を支えられる。重要な観測指標は実機での再現率であり、生成した失敗が試験工程を正当化できる頻度で確認される必要がある。難しい事例が再現されない場合や、特定環境だけに依存する場合、このシナリオは弱まる。一般的な合成データより方策改善が小さい場合も同様である。ロボットの接触動作にはばらつきがあり、試験自体が損害を起こす可能性もあるため、完全自動の承認より多層型の試験システムが現実的である。
可能性シナリオでは、身体性を備えた世界モデルが、範囲を限定したロボット作業の適格性評価基盤へ広がる。仕組みは監査可能な飛行シミュレーションに似ており、再現可能な模擬証拠によって、高コストまたは危険な実機試験の一部を減らす。独立した評価者が測定結果を信頼しなければならないため、これは社内訓練への利用より難しい制度的段階である。
1年目には、想像上の結果が実機の結果を一貫して予測できるかを研究機関が調べる。初期条件を固定した展開、反復実行、実機とモデルの比較により、結果の再現性を確認する。深度、特徴点、占有状態に基づく物理表現は、写実的な動画に隠れた幾何学的誤りを見つける助けになる。重要な基準は、複数の環境で、模擬結果が作業性能と安全性を予測するという独立した証拠が得られることである。
2年目の進展は、試験機関がその証拠を実務上どこまで重視するかに左右される。研究者は、見た目の現実性、物理的一貫性、実機との閉ループ一致を区別する忠実度区分を定める可能性がある。限定的な適格性研究では、構造化された移動作業や物体操作を対象とし、独立機関が開発者向けに再現可能な試験を実施できる。難題は、小さな更新のたびに評価全体を繰り返さず、変更部分だけを再評価する方法である。
3年目には、いくつかの限定的な作業群について、標準的な試験方法と自動再評価の工程が生まれる可能性がある。世界モデルの展開が一部の実機試験を置き換えても、実機確認と実行時の安全対策は必須のままである。測定可能な忠実度への需要が実世界での動作記録を改善し、次世代の評価モデルにも役立つだろう。注視すべき点は、合成された証拠によって、定義済みの実機試験部分を安全に削減した事例が正式に受け入れられるかである。研究機関ごとに結果が変わる場合や、小さな環境変化で結果が崩れる場合、このシナリオは弱まる。重大な実世界の失敗を見逃す場合も同様である。ロボットは変化する物体と不確実な接触に直面するため、主にシミュレーションへ依存する広範な適格性評価より、恒常的な混合試験の方が現実的である。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- WoW: Towards a World omniscient World model Through Embodied Interaction - 著者: Xiaowei Chi, Peidong Jia, Chun-Kai Fan, Xiaozhu Ju, Weishi Mi, Kevin Zhang, Zhiyuan Qin, Wanxin Tian, Kuangzhi Ge, Hao Li, Zezhong Qian, Anthony Chen, Qiang Zhou, Yueru Jia, Jiaming Liu, Yong Dai, Qingpo Wuwu, Chengyu Bai, Yu-Kai Wang, Ying Li, Lizhang Chen, Yong Bao, Zhiyuan Jiang, Jiacheng Zhu, Kai Tang, Ruichuan An, Yulin Luo, Qiuxuan Feng, Siyuan Zhou, Chi-min Chan, Chengkai Hou, Wei Xue, Sirui Han, Yike Guo, Shanghang Zhang, Jian Tang, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- GigaBrain-0: A World Model-Powered Vision-Language-Action Model - 著者: GigaBrain Team, Angen Ye, Boyuan Wang, Chaojun Ni, Guan Huang, Guosheng Zhao, Haoyun Li, Jie Li, Jiagang Zhu, Lv Feng, Peng Li, Qiuping Deng, Runqi Ouyang, Wenkang Qin, Xinze Chen, Xiaofeng Wang, Yang Wang, Yifan Li, Yilong Li, Yiran Ding, Yuan Xu, Yun Ye, Yukun Zhou, Zhehao Dong, Zhenan Wang, Zhichao Liu, Zheng Zhu, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- GigaBrain-0.5M*: a VLA That Learns From World Model-Based Reinforcement Learning - 著者: GigaBrain Team, Boyuan Wang, Chaojun Ni, Guan Huang, Guosheng Zhao, Hao Li, Jie Li, Jindi Lv, Jingyu Liu, Lv Feng, Mingming Yu, Peng Li, Qiuping Deng, Tianze Liu, Xinyu Zhou, Xinze Chen, Xiaofeng Wang, Yang Wang, Yifan Li, Yifei Nie, Yilong Li, Yukun Zhou, Yun Ye, Zhichao Liu, Zheng Zhu, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0