サマリー
今週の成果は、LLMエージェントを個々の回答精度にとどまらず、推論効率、頑健なツール使用、持続的なマルチモーダル推論まで含めて評価することを重視している。MOSAICはこの焦点を長期的な対話記憶へと広げ、テキスト・画像・動画・音声にわたる証拠の保存、検索、受け渡し、読み取りにおける失敗を切り分けた。また、他の新しい研究はエージェントの失敗がどこで生じるかを診断している。
テーマの状況
代表的な論文群は、有能で実用的なエージェントの評価における相補的な課題を浮き彫りにしている。M1は推論性能と推論コストを結びつけ、大きなバッチサイズでは、ハイブリッドMamba推論モデルが同規模のTransformerに比べて約3倍のスループットを示し、それをテスト時のサンプリング増加に振り向けられると報告している。Thinking with Programming Visionは、単純な回転や反転によって最先端のマルチモーダルモデルの性能が大きく低下しうることを示し、コードを介したマルチターンのツール合成とエラー回復の評価の必要性を示唆している。AMUSEは、話者識別、時間的一貫性、ターン間推論というもう一つの未開拓の側面を、ゼロショット、ガイド付き、エージェント型の評価モードで扱い、現在のマルチモーダルモデルが複数話者の設定で低い性能にとどまることを見出した。
今週のMOSAIC(2610.29249v1)の成果は、これらの懸念を持続的な対話エージェントへと拡張するもので、11〜24セッションにわたりテキスト・画像・動画・音声に証拠がまたがる923問を備える。その対応づけられた診断プロトコルは、書き込み、検索、受け渡し、読み取りの各段階を分離し、保存時の情報損失を、検索の取りこぼし、メディアのパッキングによる損失、完全な証拠を統合できない失敗から区別する。これらの研究は総じて、エージェントが成功するか否かだけでなく、そのリソース使用、ツールとのやり取り、マルチモーダル証拠の扱いが成功や失敗をどう説明するかを評価する方向を示している。
- M1: Towards Scalable Test-Time Compute with Mamba Reasoning Models
- Thinking with Programming Vision: Towards a Unified View for Thinking with Images
- AMUSE: Audio-Visual Benchmark and Alignment Framework for Agentic Multi-Speaker Understanding
- Muse Glimmer 30B: An On-Device Agentic Model
- OpenVLHarness: Real World Visual Agentic Tool-Use with Multimodal Memory
- A Mechanistic Study of Automated Failure Attribution in LLM-based Agentic Systems
- MOSAIC: An Omni-Modal Benchmark for Long-Term Memory and Cross-Modal Reasoning in Conversational Agents
インフォグラフィクス(日本語)
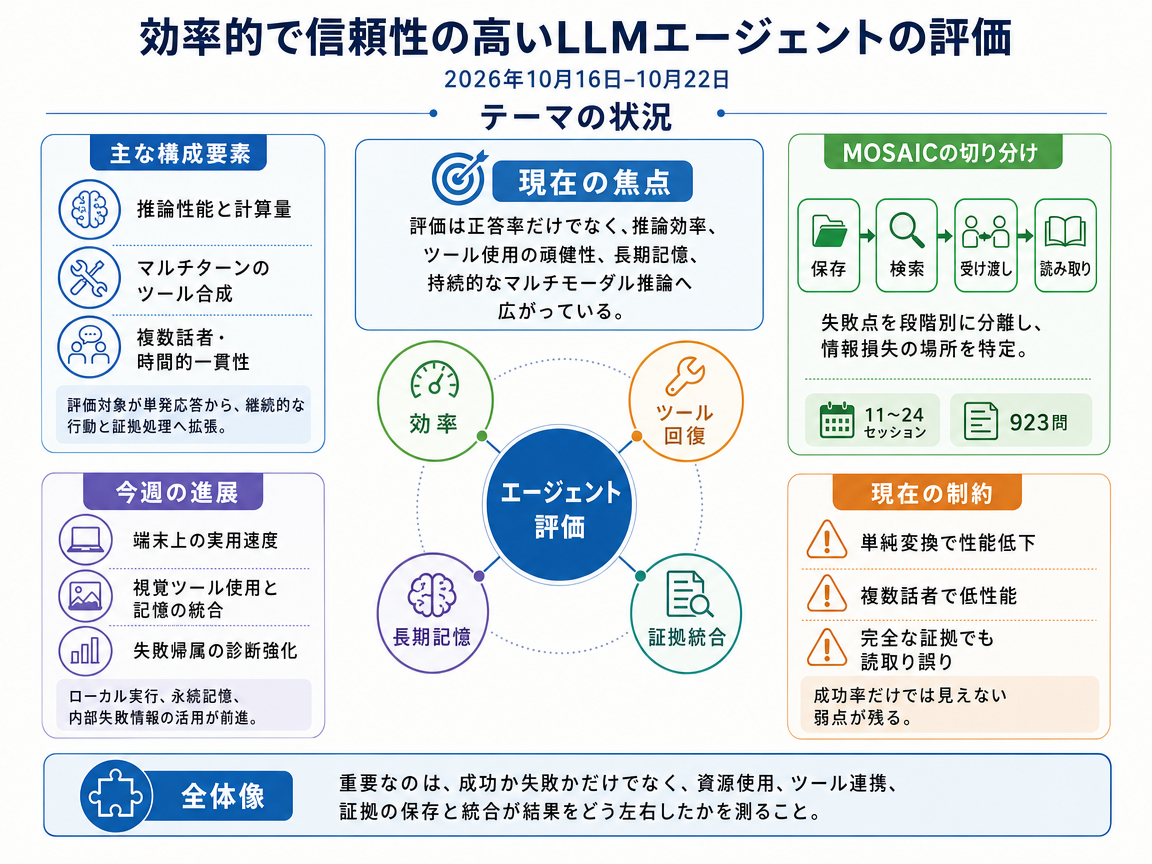
今週の進展
Muse Glimmer 30B: An On-Device Agentic Model <See Details on Fugu-MT>
Muse Glimmer 30Bは、民生用ハードウェア上での多段階推論、ツール使用、失敗からの回復のために構築された、蒸留済みのオープンウェイトモデルである。 4ビット量子化と投機的デコーディングによりエッジデバイスで実用的な速度を実現し、エージェント能力をローカル展開へと移行させる。
OpenVLHarness: Real World Visual Agentic Tool-Use with Multimodal Memory <See Details on Fugu-MT>
OpenVLHarnessは、タスクレベルのツールインターフェースと証拠レンダリングを、視覚エージェント向けの永続的なマルチモーダル記憶と組み合わせる。 22のベンチマークと8つのバックボーンにおいて、ベースモデル比で平均性能を9.7〜12.6ポイント向上させ、証拠の獲得が追加の推論努力を補完することを示唆している。
Steering Black-Box Large Language Model Agents with Pitfall Anticipation World Model <See Details on Fugu-MT>
PAWMは、エージェントの信頼性を、エラー後の回復から、ブラックボックスエージェントにおける差し迫った落とし穴の予測へと拡張する。 選択的介入により、Claude Sonnet 4.5の性能がScienceWorldで24.3%、WebArena-Liteで7.7%向上した。
MOSAIC: An Omni-Modal Benchmark for Long-Term Memory and Cross-Modal Reasoning in Conversational Agents <See Details on Fugu-MT>
MOSAICは、11〜24セッションの履歴にわたる923問で、長期的なオムニモーダル記憶を評価する。 段階別の分解により、モダリティに依存した表現の損失と、正解の証拠が与えられた場合でも相当な読み取りエラーが残ることが示された。
A Mechanistic Study of Automated Failure Attribution in LLM-based Agentic Systems <See Details on Fugu-MT>
メカニズム的研究により、LLMはエージェントの軌跡を判定する際、出力として表現する以上の失敗帰属情報を内部に符号化していることが判明した。 単純な手動介入であるGraftingは、この潜在情報を出力へと導き、直接プロンプトよりも帰属精度を向上させる。
Diagnostic Analysis for Large Language Model Reasoning <See Details on Fugu-MT>
2段階の診断評価により、オープンエンドなマルチホップ質問応答において推論構造が信頼性を保てるかを検証する。 生成エッジを用いた実験により、正解グラフの設定では隠れてしまう、上流のグラフ誤りへの感度が明らかになった。
今後の展望
今後の展望(要約)
マルチモーダルエージェントの評価は、答えの正しさだけでなく、証拠がどの段階で失われ、どのように誤解されたかを調べる、より広く診断的なものになる可能性が高い。CodeVisionの拡張案とOpenVLHarnessの知見は、より多様なツールや再利用可能な記憶を試し、役立つ場合にツール利用を評価する方向を支持している。AMUSEの内省的な最適化をMOSAICの段階別の失敗と照らし合わせれば、検索の改善と証拠統合の改善を区別できる。効率向上も引き続き重要であり、M1はカーネルの改良、注意機構の統合、長い系列の生成高速化を提案している。端末上の試験では、メモリ使用量や処理速度とともに信頼性を測り、対策が原因となった失敗段階を実際に修復するか確認する必要がある。
インフォグラフィクス(日本語)
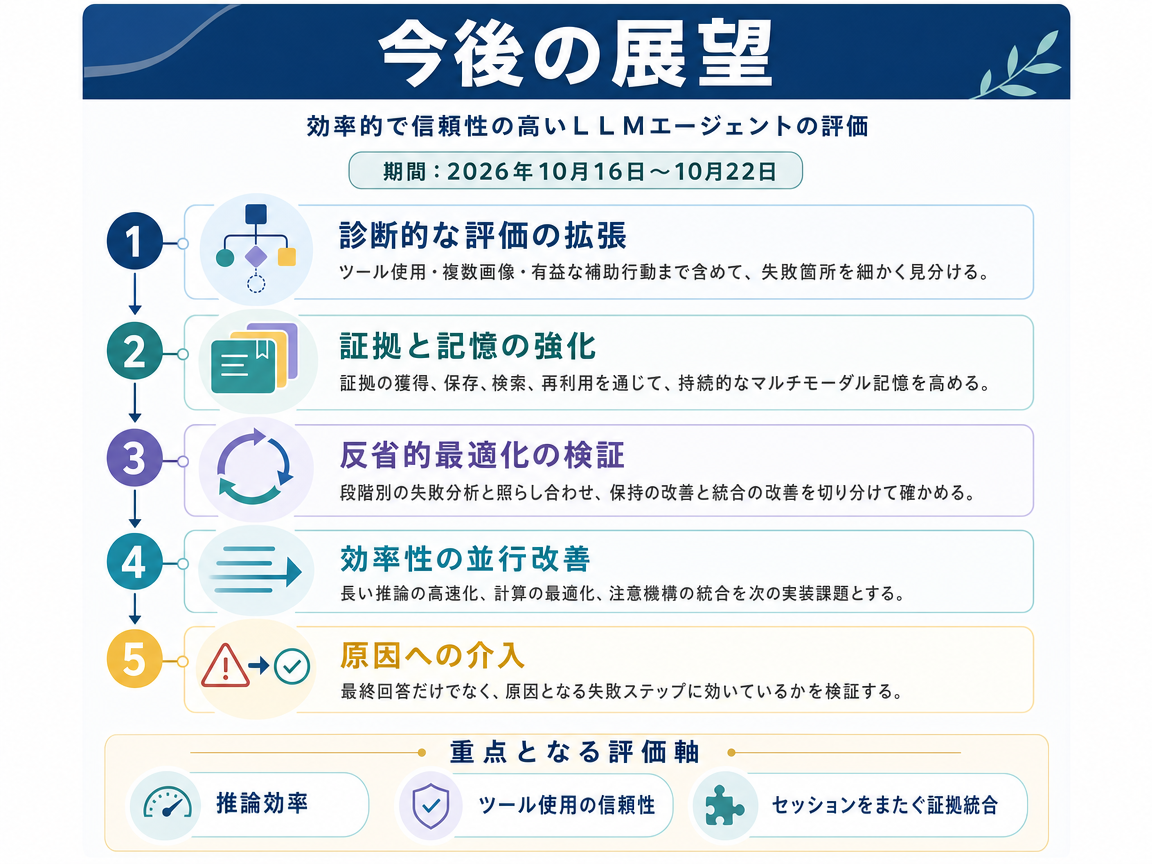
3年後を想定した動き
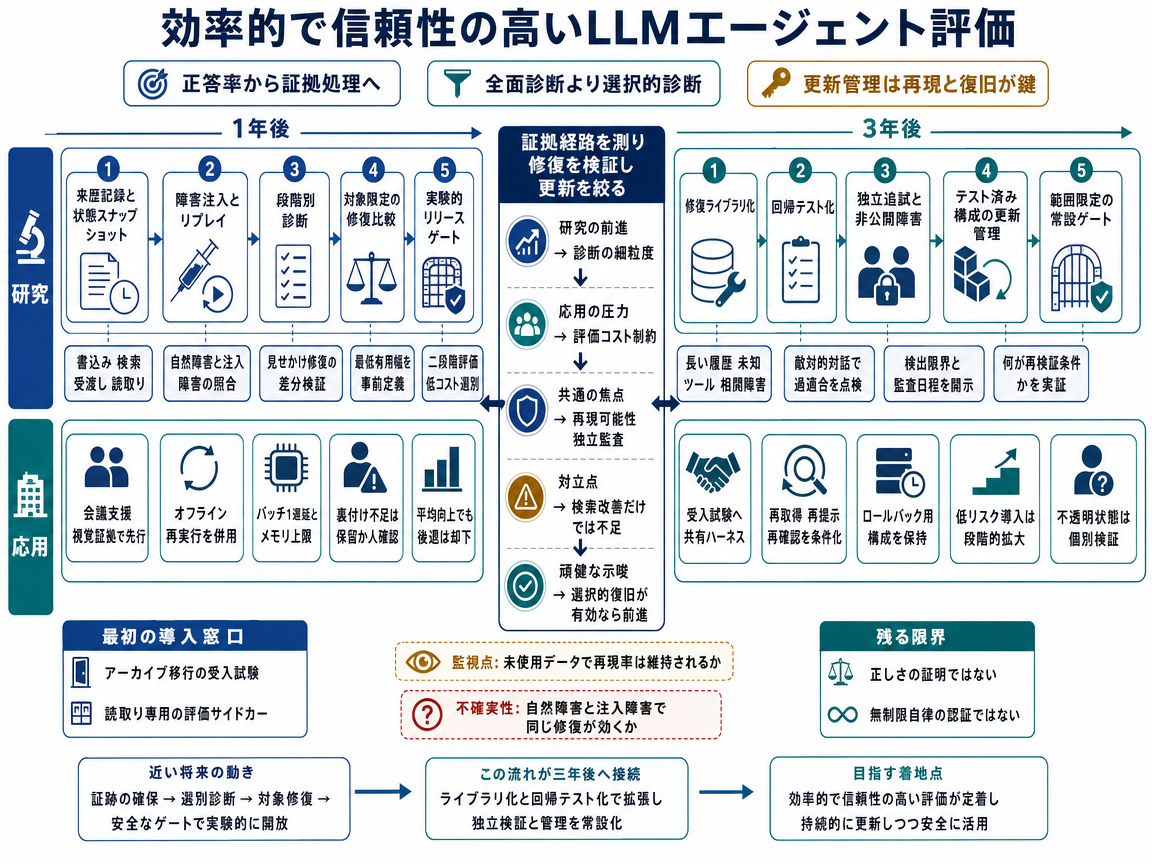
今後3年間で、この道筋は診断的評価を、マルチモーダルアシスタントの更新を受け入れるか判断するための、範囲を限定した検査へ発展させる可能性がある。初年度には、週次報告の知見を再現し、検索の改善だけで解決したと考えず、証拠が失われたり誤用されたりする段階を調べる。仕組みは信頼性工学に基づき、制御された不具合を加えて課題を再実行し、狙いを定めた修復で性能が戻るか確認する。研究者は証拠の履歴を保存し、対象を絞った修復を、同程度の計算資源を使う追加推論や原因に対応しない変更と比較する。
実用範囲を広げる前に、開発に使っていない自然発生の失敗も含め、異なる課題やモデルで修復効果を独立に確認する必要がある。その効果は、明示されたメモリ量と応答時間の上限内で得られなければならない。大量処理の高速化だけでは、個々の利用者への応答が速くなったとはいえないためである。2年目には、成功した修復を再利用可能なライブラリにまとめ、確認された失敗を回帰テストとして追加できる。試験段階のアシスタントは、費用に見合う効果がある場合に不足した証拠や限定的な検証を求め、不確かな事例は人が確認する。チームは検証済みのシステム状態を保存し、問題のある更新を作業全体の再構築なしで元に戻せるようにする。
3年目には、独立した評価者が、非公開の自然発生的な失敗や対話的な攻撃を使い、異なる評価環境で検査を試すことが考えられる。重要な監視の手掛かりは、平均正答率が上がっても、証拠の扱いや話者の一貫性を繰り返し損なう更新を拒否できることである。入れ替え式の非公開テストと人による監査により、処理上の負担をすべて含めても、修復効果が既知の事例以外で続くかを確認する。自然発生の失敗と意図的に加えた失敗で必要な修復が異なるなら、この手法は実験段階にとどめるべきである。検査が成功しても対象は特定の作業に限られ、生成の予測不能性によって再実行の結果が変わり得るため、エージェントが正しく推論していることまでは証明できない。
今後3年間で、この道筋は、エージェントの全段階と全構成を調べる費用が高すぎる場合に、選択的な診断を現実的な代替手段にする可能性がある。出発点は測定された費用であり、長い評価は常に高価だとも、短い検査だけで十分だとも決めつけない。初年度には、低費用の警告テストと詳しい段階別診断を比較し、見逃しを誤警報と同じ慎重さで測る。警告が出た事例は詳しく分析し、一見成功した事例も一部を監査して、初期検査をすり抜ける失敗がないか調べる。
この仕組みは健康状態の監視に似ており、安価な初期検査で高価な確認作業の対象を絞り、共有された評価環境で難しい問題を継続的に追跡する。大量処理が速くても一人の利用者への応答速度は分からないため、一般的な端末向けには別の試験が必要になる。2年目の拡大条件は、実際の失敗を検出できる割合を保ちながら、評価全体の費用を減らすことである。確認済みの失敗は初期検査の改善に使い、空いた評価能力は長い対話や複雑な視覚ツール利用の試験に回せる。試作チームは変更後に軽量な検査を行い、公開前には詳しい監査を実施できるが、初期検査への合格を信頼性の証明とはみなさない。
3年目には、参加チームが抽出率や検出限界を定期的に開示し、独立監査の予定も示すことが考えられる。これらの記録は、どの作業に監督付き試験導入を認められるだけの証拠があるかを判断する助けになる一方、影響の大きい用途では指定された敵対的テストを完全に実施する。中心となる監視指標は警告数の減少ではなく、未知の失敗を検出する能力を保ったまま総費用が下がることである。攻撃や未知のツール障害を繰り返し見逃す場合、特に一つの欠陥が多くの課題に広がるときは、該当領域の試験を広げる必要がある。安価な検査が新しい状況に対応できない場合や、包括的な再実行が日常的に行えるほど安くなった場合、この選択的評価の道筋は主な根拠を失う。
今後3年間で、この道筋は、資料保管システムの移行確認から、組織内アシスタントの変更を承認するための範囲を限定した手順へ発展する可能性がある。初年度には、アクセス権が管理された資料群で段階別の証拠テストを再現し、置換後の処理工程が単に多くのデータを残すだけでなく、利用可能な情報を保っているか調べる。その仕組みは水道網の区間を順に測る方法に似ており、損失が疑われる区間を切り分けて修復し、有用な機能が戻るか確認する。研究者は処理の異なる段階に検証済みの証拠を与え、人の評価者は、診断された不具合を直すことで回答が改善するか確認する。
読み取り専用の検査機能を使えば、既存サービスを止めずに旧工程と置換工程を比較でき、初期の適用を自律的な操作から切り離せる。対象を絞った修復は、同じ資源上限の下で単純な更新より良い結果を示し、評価と修正を合わせた費用も既存の受け入れ手順を下回る必要がある。次の移行でも同じ検査を再利用できれば、個別対応の技術作業ではなく、反復可能な方法になり得る。2年目には、処理工程の変更後に定期検査を行い、異なる形式やモデルにも診断が通用するか調べる。独立した評価者は、誤解を招く証拠やプロンプトインジェクションを使って検査を試し、承認要件には、合意した資源上限内で証拠に基づく回答を出すことを含められる。
3年目には、蓄積した失敗事例を使い、資料全体を再構築する代わりに、文字起こしの一部分だけを再処理するような選択的修復が可能になるかもしれない。開発に参加していない組織で効果が続くかを調べ、未解決の理解不良や危険な操作は引き続き人に引き継ぐ。重要な監視の手掛かりは、移行を重ねても検査が再利用され、情報源から回答までの記録と独立した受け入れ報告が残ることである。確認済みの修復を回帰テストに追加すれば、後の検査を安くし、変更の承認前に証拠経路の報告を求められる。ただし情報は水のように保存されるものではなく、証拠が完全でも誤解される場合があるため、診断が不安定な場合や、より安価で有効な方法がある場合には、この手法の利用範囲を制限すべきである。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- M1: Towards Scalable Test-Time Compute with Mamba Reasoning Models - 著者: Junxiong Wang, Wen-Ding Li, Daniele Paliotta, Daniel Ritter, Alexander M. Rush, Tri Dao / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Thinking with Programming Vision: Towards a Unified View for Thinking with Images - 著者: Zirun Guo, Minjie Hong, Feng Zhang, Kai Jia, Tao Jin / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- AMUSE: Audio-Visual Benchmark and Alignment Framework for Agentic Multi-Speaker Understanding - 著者: Sanjoy Chowdhury, Karren D. Yang, Xudong Liu, Fartash Faghri, Pavan Kumar Anasosalu Vasu, Oncel Tuzel, Dinesh Manocha, Chun-Liang Li, Raviteja Vemulapalli / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Muse Glimmer 30B: An On-Device Agentic Model - 著者: Arash Ebrahim Abtahizadeh, Muna Aghamelu, Adil Ahmed, Juan C. Angeles Acuna, Alexis Audran-Reiss, Asaf Avrahamy, Yoram Bachrach, Can Balioglu, Amar Budhiraja, Onur Çelebi, Gaurav Chaurasia, Joy Chen, Lynn Cherif, Lucia Cipolina-Kun, Gal Cohen, Timothée Darcet, Beto de Paola, Digant Desai, Sam Devlin, Derek Dunfield, Ivan Evtimov, Maryam Fazel-Zarandi, Rob Fergus, Jean-Christophe Gagnon-Audet, Grant Gardner, Bhavul Gauri, Paris Giampouras, Sujan Kumar Gonugondla, Antoine Grosnit, Young Han, Michael Hassid, Monuril Islam, Masoud Jalili Sabet, Songhao Jia, Narine Kokhlikyan, Svetlana Kurtsman, Sandra Lefdal, Chee Hau Leow, Noam Levi, Mike Lewis, Sanae Lotfi, Xiyang Luo, Despoina Magka, Saeed Mahloujifar, Neal Mangaokar, Ishita Mediratta, Alexander H. Miller, Hela Momand, Saba Nazir, Kelvin Niu, Mattia Opper, Parth Pathak, Alberto Pepe, Danielle Pintz, Mikhail Plekhanov, Sidhartha Reddy Potu, Anton Protopopov, Shengyi Qian, Shashank Rajput, Joseph Rocca, Scott Roy, Luca Sbordone, Amin Shakeri, Tatiana Shavrina, Michael Shvartsman, Ruan Silva, Anya Sims, Eric Michael Smith, Hugo Touvron, Mabel Ubong, Isabel Urrego, Yanzheng Xiang, Zhiyuan Yao, Alex Yarmula, He Ye, Jade Yu, Luke Zettlemoyer, Arman Zharmagambetov, Perpetua Fathima Ahlijah, Tremo Ahmed, Enrique Alfonseca, Pedram Bashiri, Nikolay Bashlykov, Aaron Berman, Rohith Bhatia, Siddharth Bhattacharya, Prashant Bhende, Chloe Bi, Shuchao Bi, Clement Anthonioz Blanc, Allen Bolourchi, Andrea Caciolai, Erica Cai, Xiang Tony Cao, Yue Cao, Andrew Caples, Jinzhao Chang, Lele Chen, Moya Chen, Weijie Chen, Wenhu Chen, Xiaobai Chen, Yinyin Chen, Zhengxing Chen, Wei Cheng, Pavel Chikulaev, Edward Chou, Sy Choudhury, Brian Clerkin, Marta R. Costa-jussà, Curtis Davis, Myra Deng, Dujian Ding, Hantian Ding, Shuangrui Ding, Jesse Dodge, Shweta Doshi, Shirin Eghtesadi, Faith Eischen, Athyu Eleti, Alex Fabbri, Han Fang, Paula Farani, Aiman Farooq, Christoph Feichtenhofer, Darius Feher, Amanda Felix, Carl Chengyan Fu, Sean Gahagan, Yifan Gao, Itai Gat, Akashdeep Goel, Ahuva Goldstand, Bo He, David Heineman, Dylan Herman, Irene Hjelt, Joonas Hjelt, Alexander Holz, Rui Hou, Annie Hu, Yuan-Ting Hu, Bernie Huang, Jing Huang, Kun Huang, Pere-Lluís Huguet Cabot, Ashley Hunter, Srinivasan Iyer, Somya Jain, Michael Jiang, Song Jiang, Wenwen Jiang, Lin Jin, Jacob Kahn, Melanie Kambadur, Yingxin Kang, Justine Kao, Stephane Kasriel, Hossein Kavianihamedani, Ameya Khandekar, Yash Khare, Gefen Kohavi, Kavya Kopparapu, Praveen Krishnan, Venu Kuchibhotla, Ananya Kumar, Leona Lan, Jack Lanchantin, Hunter Lang, Nikolay Pavlovich Laptev, Yuanzhi Li, Yunlu Li, Asad Liaqat, Johnson Lin, Runwei Lin, Zhichao Lin, Shaun Lindsay, Yaron Lipman, Frederick Liu, Mengchen Liu, Qiang Liu, Yinghai Lu, Yujie Lu, Christopher Luc, Faye Ma, Pingchuan Ma, Tengyu Ma, Wufei Ma, Xiaodong Ma, Damir Maksyutov, Josh Malone, Udeep Manchanda, Thomas Mann, Kalyani Marathe, Roberto-Rafael Maura-Rivero, Ruslan Mavlyutov, Thomas Mesnard, Julian Michael, Sagar Miglani, Todor Mihaylov, Naureen Mitha, Archi Mitra, Leo Mok, Naila Murray, Muthukumaravel Muthuraman, Mergen Nachin, Nese Demir Nalci, Saaketh Narayan, Alyssa Newcomb, Peter Ney, Joycelyn Ng, Devin Norder, Maxwell Nye, Rajvardhan Oak, Cody Ohlsen, Artidoro Pagnoni, Yi Pan, Nilesh Pandey, Guan Pang, Richard Yuanzhe Pang, Mahesh Pasupuleti, Parth Patel, Yash Patel, Vladan Petrovic, Norman Ponte, Yundi Qian, Zengyi Qin, Jack Rae, Emmanuel Ramirez, Ramya Raghavendra, Nikhila Ravi, Hongyu Ren, Riandy Riandy, Harrison Rudolph, Kalyan Saladi, Eduardo Sánchez, Karthik Abinav Sankararaman, Aman Shankar, Paresh Shenoy, Alana Shine, Hamid Shojanazeri, Iva Simon-Bubalo, Mitesh Kumar Singh, Tiffany Siqi, Pawan Sisodiya, Ali Sol, Sten Sootla, Leslie St. Pierre, DiJia Su, Suraj Subramanian, Brian Sun, Tony Sun, Zhiqing Sun, Natacha Supper, Jason Talpalar, Ellen Xiaoqing Tan, Liang Tan, Jean-Christophe Testud, Parth Thakkar, Joseph Tighe, Ty Toledano, T Tse, Igor Tufanov, Alex Vaughan, Josh Walters, Alex Wang, Bethany Wang, Meng Wang, Rocky Wang, Weiyue Wang, Xiaolan Wang, Xin Wang, Zijian Wang, Bram Wasti, Quentin Wellens, Yeming Wen, Mary Williamson, Yuncheng Wu, Fei Xia, Tian Xie, David Xu, Jacob Xu, Puxin Xu, Zheng Xu, Shen Yan, Megan Yang, Yining Yang, Nick Yannopoulos, Kevin Yao, Michihiro Yasunaga, Haoxuan You, Michael You, Dingli Yu, Tianhe Yu, Summer Yue, Xiang Yue, Shuwei Zeng, Hanwen Zha, Chen Zhang, Hongming Zhang, Kaiyu Zhang, Meng Zhang, Mingyang Zhang, Yi Zhang, Shengjia Zhao, Chao Zhou, Claire Zhou, Shuyan Zhou, Yanjun Zhou, Yaxuan Zhou, Rosalie Zhu, Yun Zhu / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- OpenVLHarness: Real World Visual Agentic Tool-Use with Multimodal Memory - 著者: Yu Zhou, Cheng-Fu Yang, Rui Sun, Di Wu, Sibo Peng, Mingyang Zhang, Zhen Yang, Ruiyi Zhang, Nanyun Peng, Zhe Gan, Kai-Wei Chang / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- A Mechanistic Study of Automated Failure Attribution in LLM-based Agentic Systems - 著者: Wendy Zheng, Liang Wu, Yinhan He, Mayank Darbari, Jundong Li, Liangjie Hong / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- MOSAIC: An Omni-Modal Benchmark for Long-Term Memory and Cross-Modal Reasoning in Conversational Agents - 著者: Hong Ting Tsang, Boyi Zhang, Haoyu Huang, Jiaxin Bai, Yufei Li, Yisen Gao, Zhongwei Xie, Hongyu Luo, Jeff Z. Pan, Yangqiu Song / <See Details on Fugu-MT> / ライセンス: CC BY 4.0