サマリー
本テーマは、LLMにとって高難度な評価設定としての科学的推論に焦点を当てている。モデルは表層的な知識の再現ではなく、専門家レベルの多段階問題で試される。現行モデルは厳密な検証、長期的な推論の統合、信頼性の高い分野固有の推論に依然として課題を抱えており、リフレクション、並列探索、構造化されたテスト時計算を追加する推論フレームワークの開発が動機づけられている。
テーマの状況
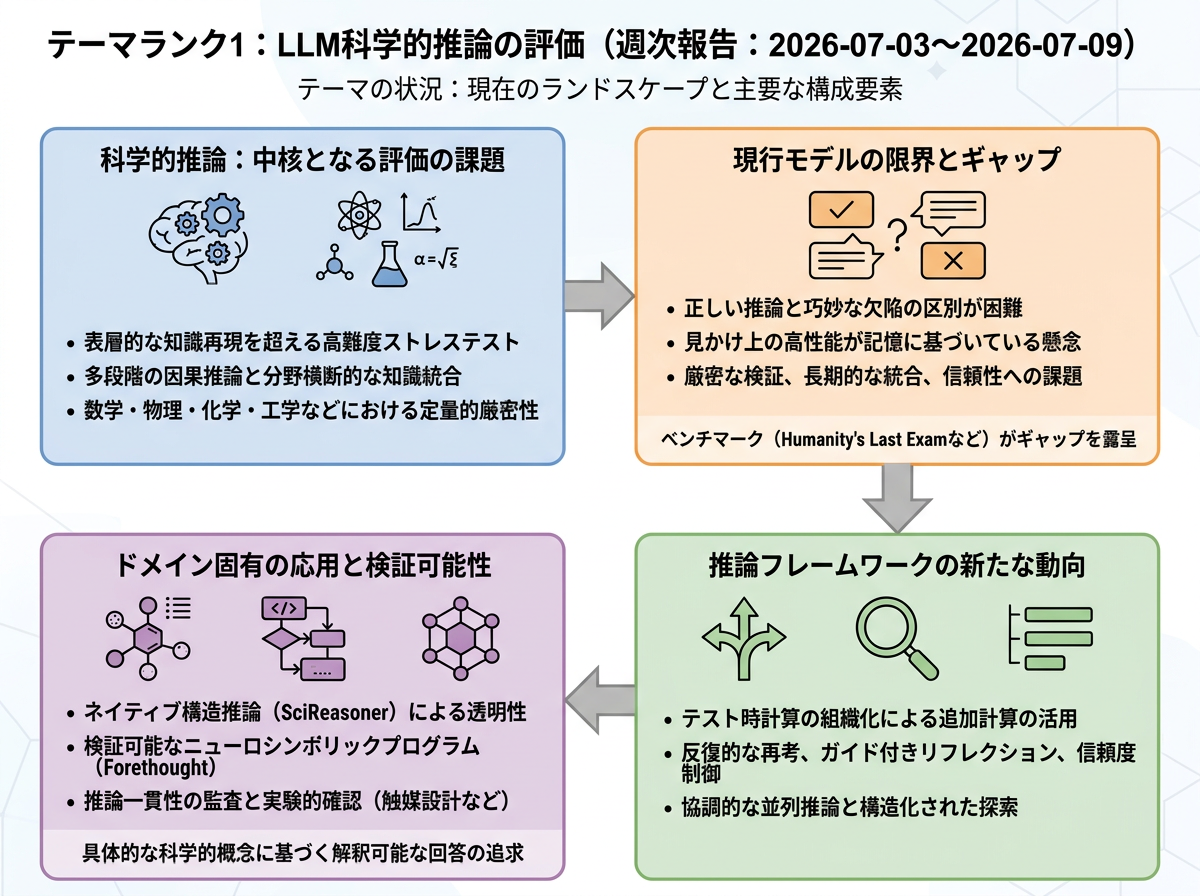
代表的な論文の導入部では、科学的推論がLLMの中核的なストレステストとして位置づけられている。これは、数学・物理学・化学・工学などの分野横断的な定量的厳密性、多段階の因果推論、ドメイン知識の統合が求められるためである。Humanity's Last Examのようなベンチマークは繰り返し浮上するギャップを明らかにしている:モデルは一見すると高性能に見えるが、正しい推論と巧妙に欠陥のある議論を区別できないことが多く、見かけ上の性能が原理的な演繹ではなく記憶に基づいている懸念が生じている。
第二の繰り返し現れるテーマは、より強力な評価がテスト時の推論の組織化方法にますます依存しているという点である。単一パスや純粋な逐次的連鎖はコンテキストウィンドウや弱い自己修正に制約されるため、反復的な再考、ガイド付きリフレクション、信頼度制御、協調的な並列推論により追加計算をより有効に活用することが動機づけられている。触媒設計などの応用志向の科学的設定では、同じ動機が別の形で現れる:探索的な科学的問題には組合せ探索、分野固有の制約、そして具体的で解釈可能かつ科学的概念に基づいた回答の必要性が伴う。
- Monte Carlo Thought Search: Large Language Model Querying for Complex Scientific Reasoning in Catalyst Design
- PaCoRe: Learning to Scale Test-Time Compute with Parallel Coordinated Reasoning
- ReThinker: Scientific Reasoning by Rethinking with Guided Reflection and Confidence Control
インフォグラフィクス(日本語)
今週の進展
Accurate, Interdisciplinary and Transparent Structure-property Understanding with Deep Native Structural Reasoning <See Details on Fugu-MT>
SciReasonerは、タンパク質・小分子・無機結晶にまたがるネイティブ構造推論のための科学基盤モデルである。座標、トポロジー、周期的接続性を統一された構造対応語彙に変換し、86のベンチマークのうち67タスクで最先端の性能を達成した。 論文の具体的なタスク、手法、エビデンス、または応用設定を通じて、モデル評価・LLMの文脈に接続している。
Forethought: Verifiable Reasoning from Neurosymbolic Primitive Programming <See Details on Fugu-MT>
Forethoughtは、中間ステップを明示的かつ検証可能なニューロシンボリックプログラムとして定式化することで、LLMの推論を前進させた。 従来のリフレクション型テスト時手法と比較して、ヒューリスティックな自己修正から直接検証可能な推論トレースへと移行し、ベースモデルに対して約30%の精度向上を報告している。
Reasoning Consistency Scanning: A Framework for Auditing Chain-of-Thought Validity in AI Safety Evaluations <See Details on Fugu-MT>
Reasoning Consistency Scanningは、連鎖思考トレースがタスクやモデル間で内部的に一貫しているかを監査する再利用可能な手法を提供した。 集約的なベンチマークスコアリングを超えて、6種類の不整合分類法と検証済みベンチマークを導入し、推論上の欠陥が検出可能であり、モデルやタスクの種類によって体系的に異なることを示した。
Reaction-network reasoning with frontier models for experimentally confirmed catalyst-selectivity hypotheses <See Details on Fugu-MT>
本研究は、反応ネットワークから実験的に検証可能な選択性仮説を抽出することで、最先端の言語モデルを触媒発見に応用した。 人間とAIの共同推論フレームワーク内でネットワーク不変量を強制し、モデル出力を実験的に確認された化学的結果に結びつけることで、従来のドメインに基づいた推論に関する一般的な議論を超えている。
今後の展望
今後の展望(要約)
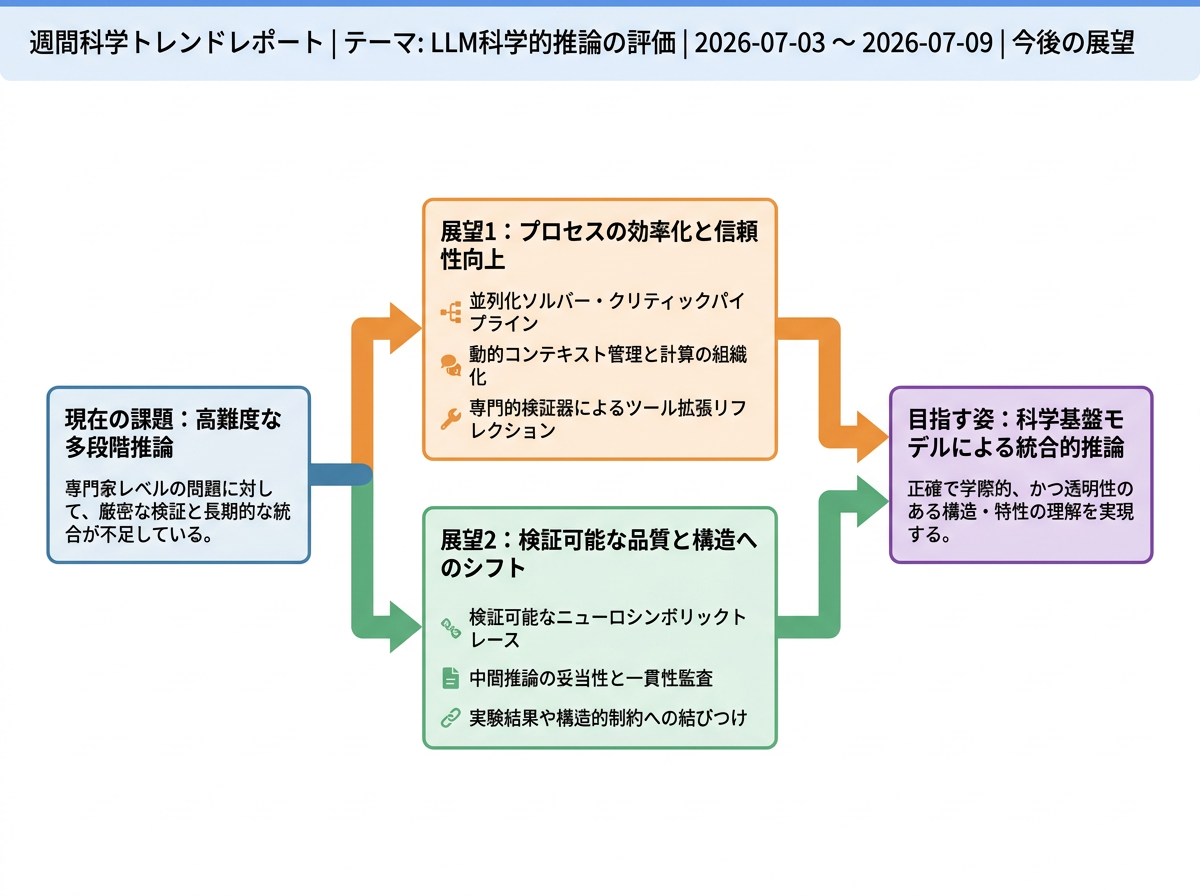
短期的な科学的推論の評価では、多段階の推論をより高速で信頼でき、確認しやすいものにすることが焦点となる。システムは、複数の解答器と批評器の並列動作、文脈の適切な管理、記号処理やプログラムによる専用検証器を通じて、実行時の計算を整理するようになる。評価も最終回答だけを見るのではなく、途中の推論が妥当で一貫しているかを調べ、出力を科学的な制約や検証可能な結果と結び付ける方向へ進む。
インフォグラフィクス(日本語)
3年後を想定した動き
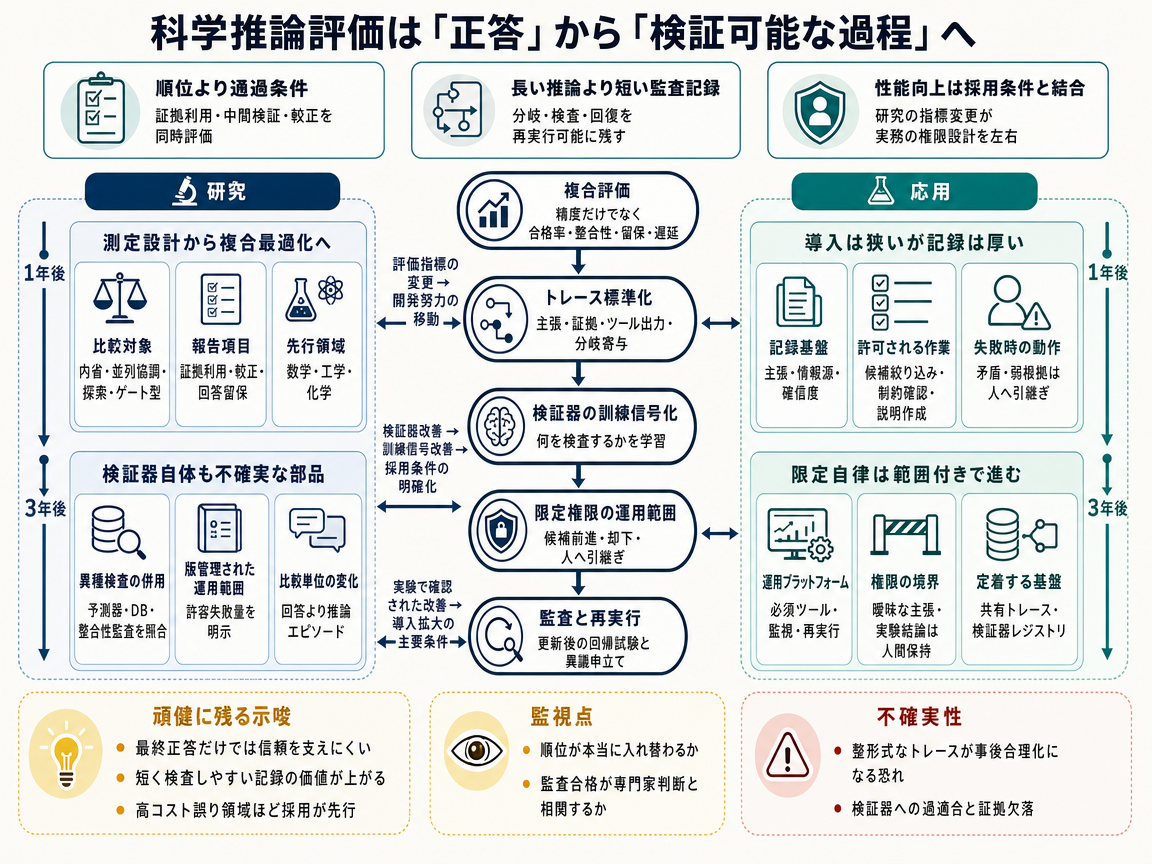
標準シナリオでは、科学的推論システムが実行時の作業を慎重に整理し、推論過程を確認しやすくすることから始まる。初年には、複合的な評価により、同程度の計算量という条件の下で精度、検証器の通過率、応答時間を比較する。研究支援システムは、主張やツールの結果、修正過程を記録し、回答がどのように作られたかをレビュー担当者が追跡できるようにする。初期の利用範囲は狭く、根拠が弱い事例や矛盾を含む事例は、自動処理せず科学者に回される。
二年目には、こうした評価が専門家の判断や実験結果と一致すれば、適用範囲が広がる。検証器の出力と、確信が足りない場合に回答を控える能力は、回答後の確認だけでなく学習用の信号にも使われる。共通の実行記録形式によってシステム間の比較が容易になり、敵対的テストでは証拠の捏造や検証器への過剰適応を調べる。組織は蓄積した記録から、特定の課題で信頼できる動作が実証された条件範囲、すなわち「証拠の有効範囲」を定める。
三年目には、データベースの不足や科学的予測の誤りを考慮し、検証器自体も不確実なものとして扱われる。システムは複数の検査を組み合わせ、意見の不一致を記録し、後から証拠が得られた場合には結論を修正する。ベンチマークは単一の総合点ではなく、版ごとの動作範囲と許容できる失敗の限度を示すようになる可能性がある。この仕組みは航空機の耐空性試験に似ており、良い結果に到達するだけでなく、重要な手順や障害時の対応も検査に合格する必要がある。重要な監視項目は、評価指標が専門家の判断と実際の実験結果を継続して予測できるかどうかである。予測できるなら、認定されたシステムは限定された工程内で事例を進めるか差し戻すかを判断し、曖昧な結論は人が決定する。順位がほとんど変わらない場合や監査記録が容易に操作できる場合、あるいは適切な回答保留が無視される場合には、このシナリオの可能性は低下する。成功したとしても、保証できるのは範囲を限定した過程であり、確立に時間がかかり議論も残る一般的な科学的真理ではない。
対抗シナリオの中心は、他のモデルやツールが読み取り、検査できる中間推論の限定的な記録である、標準化された「トレース容器」である。この仕組みは、作業が推論段階の間を移動するときに生じる費用と情報損失を減らすことを目指す。初年には、構成要素を異なるシステム間で交換できるか、圧縮されたトレースに決定的な証拠が残るかを検証する。また、トレースが実際の処理を忠実に表すのか、それとも回答決定後に作られた説明にすぎないのかも評価する。
こうした試験と並行して、再利用可能な検査基盤も整備される。共通インターフェースにより、コード検査器や記号処理ツール、科学的予測器を、システムごとの専用開発なしで接続できるようになる。学習では、回答の正しさだけでなく、トレースの妥当性や制約の順守も評価対象になる可能性がある。限定的な科学分野での試行では、検査済みの提案が、検査していない同等の提案よりも確認可能な改善を生むかが重要な監視項目となる。
二年目の進展は、主要なベンチマークが最終回答とともに途中過程の妥当性を採点するかどうかに左右される。これが実現すれば、互換性のある少数の形式へ集約が進み、異なるシステムが同じ記録を扱いやすくなる。対応する形式が広がれば検証器が増え、検証範囲の拡大によって形式自体の有用性も高まる。三年目には、交換可能な推論モジュール、専門検証器の登録基盤、再実行できるツール記録から成る階層型の構成が形成されると考えられる。研究は初期に成果が出た分野から材料科学や工学へ広がるが、機械的に確認できない主張には引き続き人のレビューが必要である。厳密な科学評価では、最終回答だけを報告する方法は不十分と見なされるようになる可能性がある。
ただし、推論トレースは単なる受動的な記録ではない。モデルは検査規則に適応して、形式上は整っていても誤解を招く記録を作ることがあり、圧縮によって重要な証拠が気付かれないまま失われることもある。システム間で部品を交換すると一体型設計より性能が下がる場合や、主要評価がトレース採点を採用しない場合、あるいは監査結果が科学的な正しさと一致しない場合には、このシナリオの可能性は低下する。
可能性シナリオでは、整理され検査可能な推論が、管理された品質保証サービスへ発展する。研究計算部門や専門事業者が、単独のモデルではなく処理工程全体を運用する。初年には、時間や文脈量、計算量の上限を固定し、完全な作業工程同士を比較する。初期サービスは、定量的な導出や反応分析、工学計算など、作業の少なくとも一部を検査できる限定的な課題を対象とする。
各サービスは、対応範囲と検証方法、人が介入する条件を説明するタスクカードを定める。再現性を確保する一式の記録によって、出力が情報源や実行コード、検証結果と結び付けられる。この基盤により、システム更新の監査が容易になり、不要な専門家レビューも減ると期待される。重要な監視項目は、無効な提案が高コストの実験に進むのを防げるか、または運用費を上回るだけの確認時間を節約できるかである。
二年目には、成果を上げた組織が、共通のタスク定義と証拠形式を用いてサービスを比較するようになる。内容を事前に公開しない能力試験により、モデルやデータベース、検証器を変更した後も作業工程が信頼できるかを調べる。この仕組みは試験所の認定に似ており、使用ツールを追跡し、有効な動作範囲を定め、例外事例を責任ある専門家に割り当てる。処理した各事例から失敗データも得られるため、その後の振り分けを改善し、レビューの負担を減らせる。
三年目には、認定されたサービスが実験設備や科学データベース、安全な計算環境へ直接接続される可能性がある。限定的なタスクカードの条件を満たす定型的な出力は自動的に次へ進み、不一致や根拠不足の問題は専門家の確認待ちに入る。保証水準を分けることで探索的な作業と重要な用途向けの出力を区別し、持ち運び可能な記録によって独立したレビューを支える。監視では、能力試験の結果が実験結果を予測できるか、更新後のシステムを過度な遅れなく再認定できるかを確認する。利用者が汎用的な利用方法を好み続ける場合や、形式的に妥当なトレースが判断改善につながらない場合、あるいは保証費用に見合う誤り削減が得られない場合には、このシナリオの可能性は低下する。根本的な限界は、すぐに確認できる正解が存在しない独創的な仮説について、工程管理だけでは真偽を確定できないことであり、専門家の判断と実証試験は引き続き不可欠である。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- Monte Carlo Thought Search: Large Language Model Querying for Complex Scientific Reasoning in Catalyst Design - 著者: Henry W. Sprueill, Carl Edwards, Mariefel V. Olarte, Udishnu Sanyal, Heng Ji, Sutanay Choudhury / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- PaCoRe: Learning to Scale Test-Time Compute with Parallel Coordinated Reasoning - 著者: Jingcheng Hu, Yinmin Zhang, Shijie Shang, Xiaobo Yang, Yue Peng, Zhewei Huang, Hebin Zhou, Xin Wu, Jie Cheng, Fanqi Wan, Xiangwen Kong, Chengyuan Yao, Kaiwen Yan, Ailin Huang, Hongyu Zhou, Qi Han, Zheng Ge, Daxin Jiang, Xiangyu Zhang, Heung-Yeung Shum, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- ReThinker: Scientific Reasoning by Rethinking with Guided Reflection and Confidence Control - 著者: Zhentao Tang, Yuqi Cui, Shixiong Kai, Wenqian Zhao, Ke Ye, Xing Li, Anxin Tian, Zehua Pei, Hui-Ling Zhen, Shoubo Hu, Xiaoguang Li, Yunhe Wang, Mingxuan Yuan, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0