サマリー
今週の感情AIにおけるベンチマーク研究は、人間の感情の複雑さをより適切に反映する評価リソースの必要性に取り組んでいる。代表的な論文は、現行の評価が浅すぎる、規模が小さすぎる、あるいはモダリティが狭すぎると指摘し、認知的に基盤づけられたベンチマークや、感情推論・遠隔生理計測・微表情認識のためのより大規模なマルチモーダルデータセットを導入することで対応している。
テーマの状況
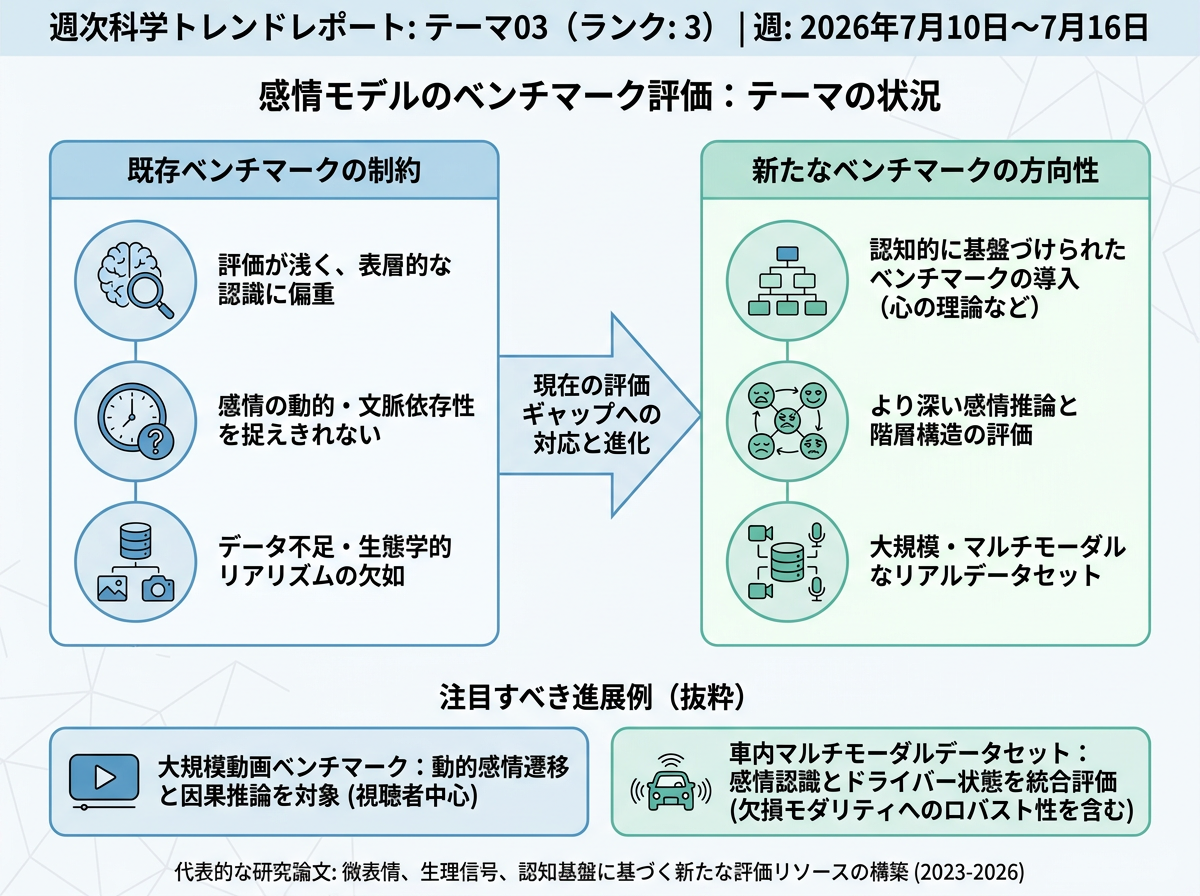
代表的な研究の序論では、感情コンピューティングにおける共通の評価ギャップが述べられている。モデルは改善されてきたが、その評価に用いられるベンチマークは、感情のダイナミックで文脈依存的かつマルチモーダルな性質を捉えきれていないことが多い。マルチモーダル大規模言語モデルにおいて、既存の感情評価は表層的な認識に偏重し、粗いスコアしか提供しないため、信念・意図・矛盾する手がかりに関するより深い推論の失敗を診断することが困難である。これが、感情推論がどこで破綻するかを特定するための心の理論に基づく階層構造など、より構造化されたベンチマーク設計の動機となっている。
並行して、ベンチマーク構築におけるデータ不足と生態学的リアリズムからの圧力も存在する。データセット論文は、特に遠隔生理計測や自発的微表情において、収集とアノテーションが困難であるため、感情認識が小規模または不完全な公開リソースによって制約されていることを強調している。そのため、現在のベンチマーク評価は、より強力なベースライン比較と実世界の感情環境におけるロバスト性のより忠実な評価を支えうる、大規模で同期されたマルチモーダルかつよりリアルなデータセットへと拡大しつつある。
- More is Better: A Database for Spontaneous Micro-Expression with High Frame Rates
- CAST-Phys: Contactless Affective States Through Physiological signals Database
- Unveiling the Cognitive Compass: Theory-of-Mind-Guided Multimodal Emotion Reasoning
インフォグラフィクス(日本語)
今週の進展
Benchmarking Dynamic Affective Reasoning: A Viewer-Centric Video Emotion Dataset <See Details on Fugu-MT>
27カテゴリにわたる動的な感情遷移と因果推論を対象とした、視聴者中心の大規模動画ベンチマークを導入した。 従来の粗い静的評価とは異なり、時間的局在化と感情推論の両タスクに対応するアノテーション付き感情セグメントを提供する。
InCarEmo: A Multimodal Dataset for In-Cabin Emotion Recognition and Driver State Monitoring <See Details on Fugu-MT>
RGB・赤外線映像・音声・対話テキストを組み合わせた車内マルチモーダルデータセットを提示し、感情認識とドライバー状態モニタリングに対応する。 より小規模またはモダリティが限定された既存ベンチマークと比較して、欠損モダリティに対するロバスト性テストを含むベースライン結果付きの統合的な評価を提供する。
今後の展望
今後の展望(要約)
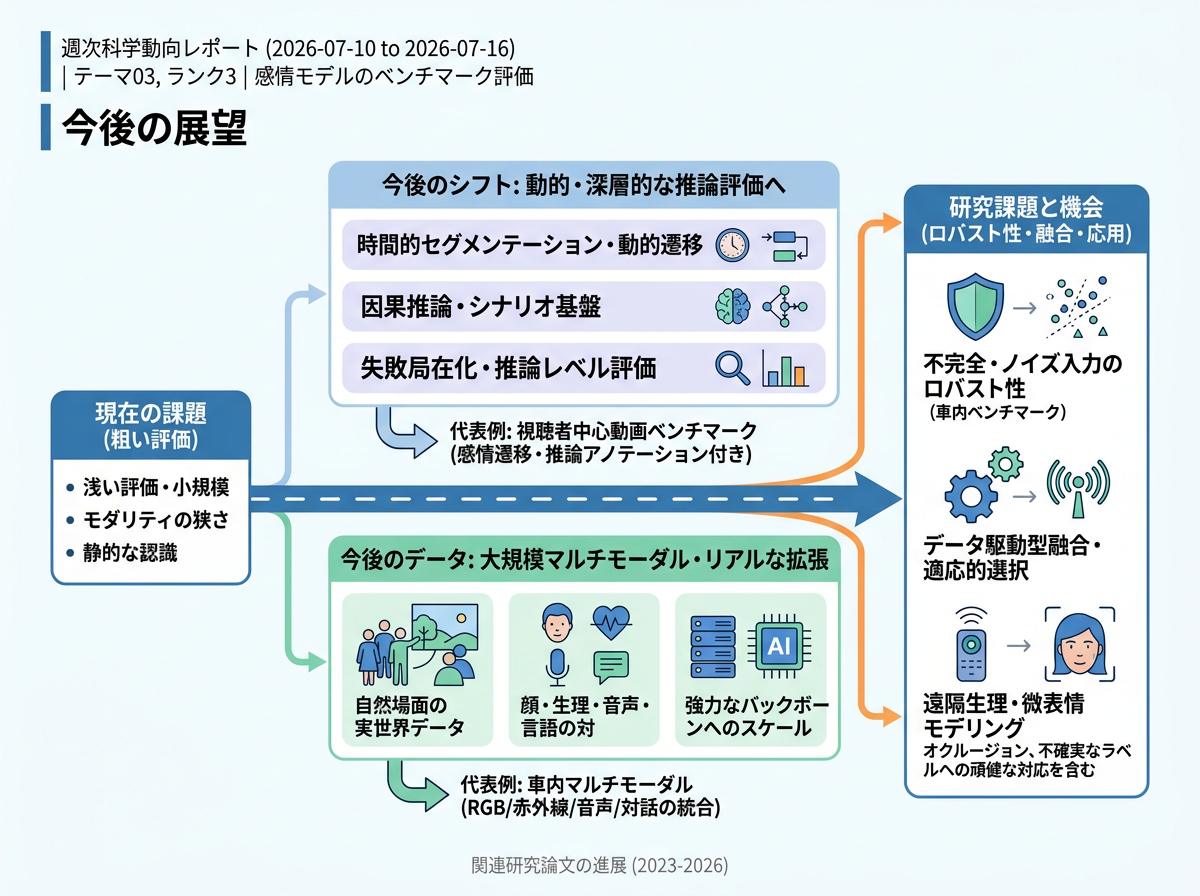
今後は、時間とともに変化する行動、複数の情報形式、より深い認知を扱う感情推論の評価が進むと考えられる。ベンチマークでは、静的な感情認識だけでなく、時間的変化や因果関係の解釈、現実に近い状況を検証する必要がある。自然な環境で収集される大規模データセットには、行動信号と生理信号が組み合わされ、動きや遮蔽がある場合の遠隔計測と信号統合も改善されるだろう。欠損や雑音、不確実性を含む入力への頑健性も、標準的な要件になる可能性が高い。
インフォグラフィクス(日本語)
3年後を想定した動き
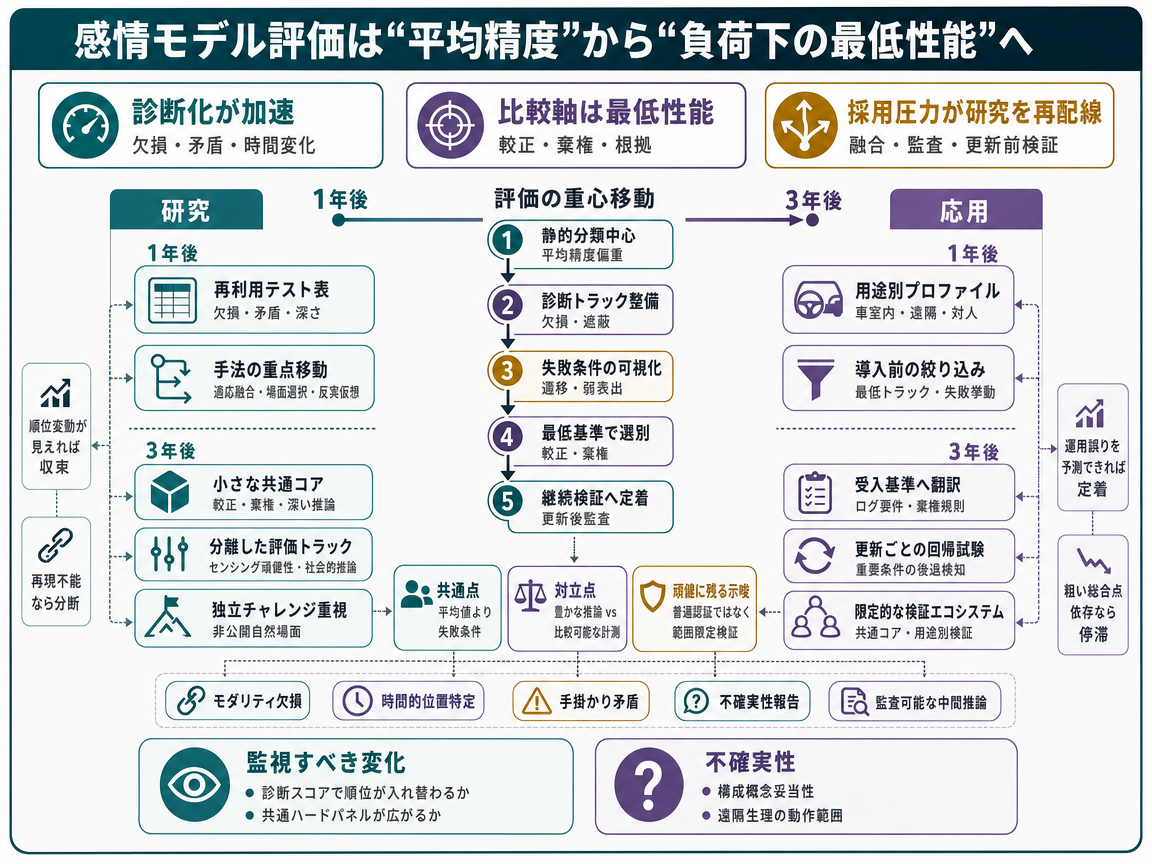
この分野は、静的な感情分類から、動的な行動や複数形式の証拠、より深い社会的推論を測る評価へ移りつつある。1年目には、ベンチマーク開発者が認知的な難しさ、時間的変化、劣化した入力を組み合わせ、再利用可能なテスト設計を整える可能性が高い。さらに、結果が異なるデータセットにも適用できるか、まれで難しい事例でも統計的な信頼性を保てるかを調べるだろう。手法側では、利用可能な信号のうち信頼性が高いものを選ぶ適応的統合や、重要な瞬間に注目する時間選択が発展すると考えられる。証拠が弱い場合に不確実性を示したり回答を控えたりするため、確率の較正と回答辞退も重要になる。
2年目には、有効性が確認された診断テストが、小規模な共通評価項目へまとまる可能性がある。この共通部分は、推論の深さや入力の破損、少数の難しい事例に対する挙動を測り、非公開の自然場面によって公開テストへの過剰な調整を抑える。遠隔から得る生理信号は、動きや照明、機器差について条件を明示した場合に限って評価されるだろう。独立した評価者は安全な実行環境を使い、同期された機微な記録を広く配布せずに検証できる。
3年目には、さまざまな負荷条件を含む評価が、モデル開発と公開前検証の継続的な工程になる可能性がある。中心となる考え方は、平均精度だけでなく、重要条件のうち最も弱い部分の性能によって合否を決めることである。これにより、開発者には入力欠損や難しい推論課題で表面化した失敗を修正する直接的な動機が生まれる。重要な観測点は、診断スコアによって主要モデルの順位が入れ替わり、その結果が実際の試験導入での選定に使われるかどうかである。計測の信頼性と社会的推論は別の評価区分になり、共通の報告基盤の上に用途別の評価条件が構築されるかもしれない。ただし、表情行動や生理的覚醒は解釈を支える証拠にはなっても、本人の内面を直接示すものではない。順位が変わらず、結果を再現できない場合や、根拠のない流暢な説明が高く評価され続ける場合、この展開の可能性は低下する。
短期的には、動的な変化や複数形式の情報、より深い認知を扱う感情推論を細かく評価する方向へ進むと考えられる。1年目には、研究者は豊かなベンチマークを作るだけでなく、その測定結果が異なるテスト群にも移せるかを検証する。共通ツールは、入力の意図的な除去や信頼できない生理推定の検出を行い、条件ごとの確信度を報告できるようになるだろう。小規模で難しい評価群には、ラベルが曖昧な自然な出来事や、手掛かりが互いに矛盾する事例が含まれる。モデルが元のベンチマークから共通評価群へ移るたびに順位が繰り返し変わるかどうかが、重要な観測点となる。
こうした差が安定して確認されれば、2年目には複数拠点による定期的な共同評価が始まる可能性がある。複数の研究組織が同じ基準事例を独立に評価し、測定結果がどこで食い違うかを比較する。データセットの公開時には、ラベルの説明や時間的注釈の規則、信号品質の管理方法がより明確になるだろう。実用評価では劣化した入力と不確実な自然行動を重視し、研究向け評価では因果推論や社会的推論の難しい課題を維持する。応用チームは、すべての感情予測を同程度に信頼するのではなく、限定的な通知機能と失敗時の代替動作を検証できる。
3年目には、音声・映像・テキストを扱うモデルに対し、知覚と理解と推論を分けた多段階の報告が導入される可能性がある。評価パッケージには、不確実性の許容範囲や再確認可能な事例、異なる環境への転移テストが含まれるかもしれない。この展開を動かす仕組みは、技術が急速に積み重なる前に標準化を進めることであり、目に見える不一致が再利用可能な較正ツールへの需要を生む。広く使われるツールは他のベンチマークにも比較可能性の改善を促し、実運用テストは信号統合や確信度の基準、証拠不足時の回答辞退を導く。互換性のある報告は、用途が明確に限定されている場合に限り、品質確認の手順を支えられる。ただし、感情には単一の外部正解がなく、本人の申告と観察者の解釈が正当に異なる場合もある。較正なしでも順位が変わらない場合や、共通評価への参加が少ない場合、または不完全な入力を試さない粗いスコアが受け入れられ続ける場合、この展開は弱まる。
当面の機会は、新しいマルチモーダル資源を、車内の限定された課題に対する再現可能なテストへ変えることにある。一般的な感情理解を主張するのではなく、適用条件を明確にすることが重要である。1年目には、直接的な知覚、信号統合、高次の推論を別々のテストとして評価する。カメラが遮られた場合や音声が欠けた場合、行動上の手掛かりが矛盾する場合の性能も調べる。生理状態の推定や微細な表情は、あらゆる環境で信頼できる情報ではなく、補助的な証拠として扱われる。非公開のテスト事例と明確な回答辞退の指標により、センサーや収集場所、注釈方法が変わってもモデル順位が保たれるかを確認できる。
初期の応用は、組織内部でシステムを比較するツールが中心になるだろう。チームは劣化したセンサー条件を再現し、出力を利用できる条件範囲を「頑健性の範囲」として定義できる。機器やモデルを変更した際には、関連する回帰テストを選んで再実行する。この仕組みでは、複数のセンサーに依存する重要なシステムへ部品を組み込む前に、明示された障害条件のテストへ合格する必要がある。試験導入で起きた失敗を非公開の評価事例に変えれば、その後の修正と受け入れ試験に反映できる。
2年目には、研究者とシステム統合担当者が、用語や報告形式、一般的な障害条件の定義をそろえる可能性がある。独立した研究機関や運用サービスが非公開の課題群を管理し、条件ごとに追跡可能な記録を作成するかもしれない。3年目まで主要な利用組織の連携が続けば、頑健性や不確実性、再試験を扱う共通の導入要件へ発展しうる。計測、統合、社会的推論に別々の合格基準を設けることで、説得力のある説明が弱い知覚性能を覆い隠す事態を防げる。
重要な観測点は、少なくとも二つの主要組織が互換性のある評価表を採用し、独立した提供者が再現可能なテストを実施するかどうかである。条件が整えば、この評価群は車内向けの感情対応部品に関する事実上の共通規則となり、他のマルチモーダルシステムにも限定的に応用される可能性がある。ただし、感情ラベルには物理現象のような不変の基準がないため、合格が示すのは明示された条件下で挙動を再現できることに限られる。1年目の終わりまでに入力欠損テストを運用できない場合や順位が安定しない場合、または機微情報の保護が制御された再現を妨げる場合、この展開の見込みは引き下げるべきである。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- More is Better: A Database for Spontaneous Micro-Expression with High Frame Rates - 著者: Sirui Zhao, Huaying Tang, Xinglong Mao, Shifeng Liu, Hanqing Tao, Hao Wang, Tong Xu and Enhong Chen / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- CAST-Phys: Contactless Affective States Through Physiological signals Database - 著者: Joaquim Comas, Alexander Joel Vera, Xavier Vives, Eleonora De Filippi, Alexandre Pereda, Federico Sukno, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Unveiling the Cognitive Compass: Theory-of-Mind-Guided Multimodal Emotion Reasoning - 著者: Meng Luo, Bobo Li, Shanqing Xu, Shize Zhang, Qiuchan Chen, Menglu Han, Wenhao Chen, Yanxiang Huang, Hao Fei, Mong-Li Lee, Wynne Hsu, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0