サマリー
本テーマは、現実的なソフトウェアエンジニアリングタスク、特にリポジトリレベルのイシュー解決におけるLLMベースコーディングエージェントの評価に焦点を当てている。代表的な研究は、ベンチマークの進展が最終パッチのテスト合否だけでなく、エージェントがコンテキストをどのように取得し、実行フィードバックを通じてどのように反復し、候補をどのように選択し、解決過程で蓄積されたエラーや不要な編集をどのように処理するかにも依存すると主張している。
テーマの状況
LLMベースのソフトウェアエンジニアリングは、単純な関数生成を超え、リポジトリ・ツール・実行環境と対話して実際のGitHubイシューを解決するエージェントシステムへと進展している。代表的な研究はSWE-benchスタイルのタスクをより現実的な評価設定として位置づけ、コードベースのコンテキスト取得、反復的な編集・テスト生成、候補パッチからの最終選択といった中核的なステージを強調している。
同時に、最終出力のみに基づく評価ではエージェントの能力の全体像が得られないと文献は指摘している。解決過程の軌跡やテストログから得られるプロセス指向のエビデンスの重要性が高まっている。これは、エージェントが繰り返しのデバッグ・適応・エラー回復を通じて成功または失敗することが多く、テストに合格したパッチであっても不要な探索的編集が残存し、レビューや保守を困難にする場合があるためである。
- CodeMonkeys: Scaling Test-Time Compute for Software Engineering
- Unveiling Pitfalls: Understanding Why AI-driven Code Agents Fail at GitHub Issue Resolution
- Magellan: Autonomous Discovery of Novel Compiler Optimization Heuristics with AlphaEvolve
インフォグラフィクス(日本語)
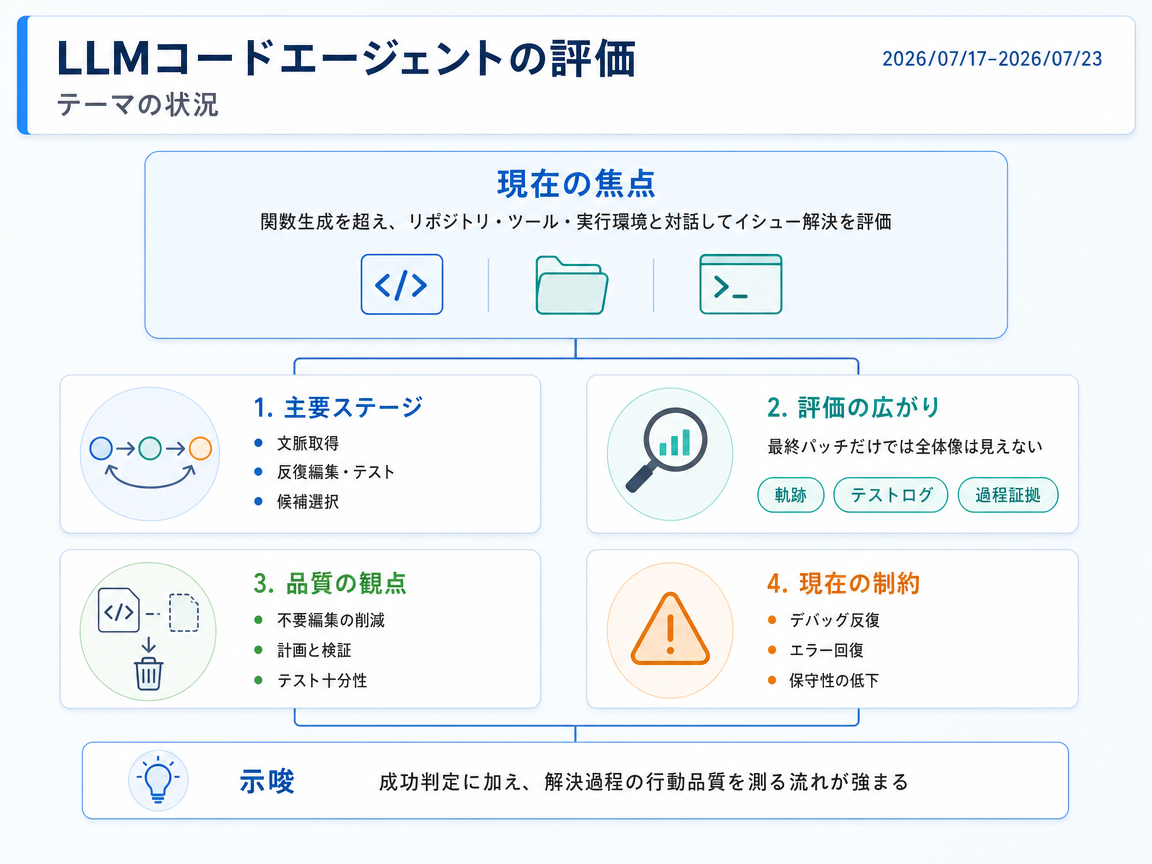
今週の進展
TRIM: Reducing AI-Generated CodeSlop via Agent Trajectory Minimization <See Details on Fugu-MT>
TRIMは、エージェントが生成した過大なパッチを探索軌跡そのものに遡り、階層的反事実的最小化を適用して冗長な編集を除去する。 最終パッチのみを評価する手法と比較して、軌跡レベルのコード肥大化をコーディングエージェントの具体的かつ測定可能な品質目標として提示している。
Agentic Code Review in the Terminal: A Trajectory-Level Analysis of Behavior, Cost, and Human-Alignment <See Details on Fugu-MT>
本研究は、ターミナルベースのコードレビューエージェントを軌跡レベルで評価し、レビュー品質を行動・コスト・人間との整合性に関連づけている。 性能のみの評価と比較して、成功するレビューにはより強力な計画策定と下流の検証が必要である一方、調査オーバーヘッドが発生することを示している。
Otap:Structure-Aware Optimal Transport for Evaluating Planning and Execution in Agent Trajectories <See Details on Fugu-MT>
OTAPは、最適輸送に基づく軌跡メトリクスを導入し、有効な解グラフまでの距離によってエージェントの計画と実行を評価する。 二値の成功フラグや完全一致評価と比較して、依存関係を考慮し順序変更に不変な形でプロセス品質を捉えている。
Test Coverage Analysis of Agentic Pull Requests <See Details on Fugu-MT>
本研究は、5つのコーディングエージェントが生成した4,882件のプルリクエストのテストカバレッジを分析し、生成コードが十分にテストされているかを評価している。 パッチレベルの成功指標と比較して、エージェント出力のレビューにおける実用的な品質次元としてテストカバレッジの十分性を追加している。
今後の展望
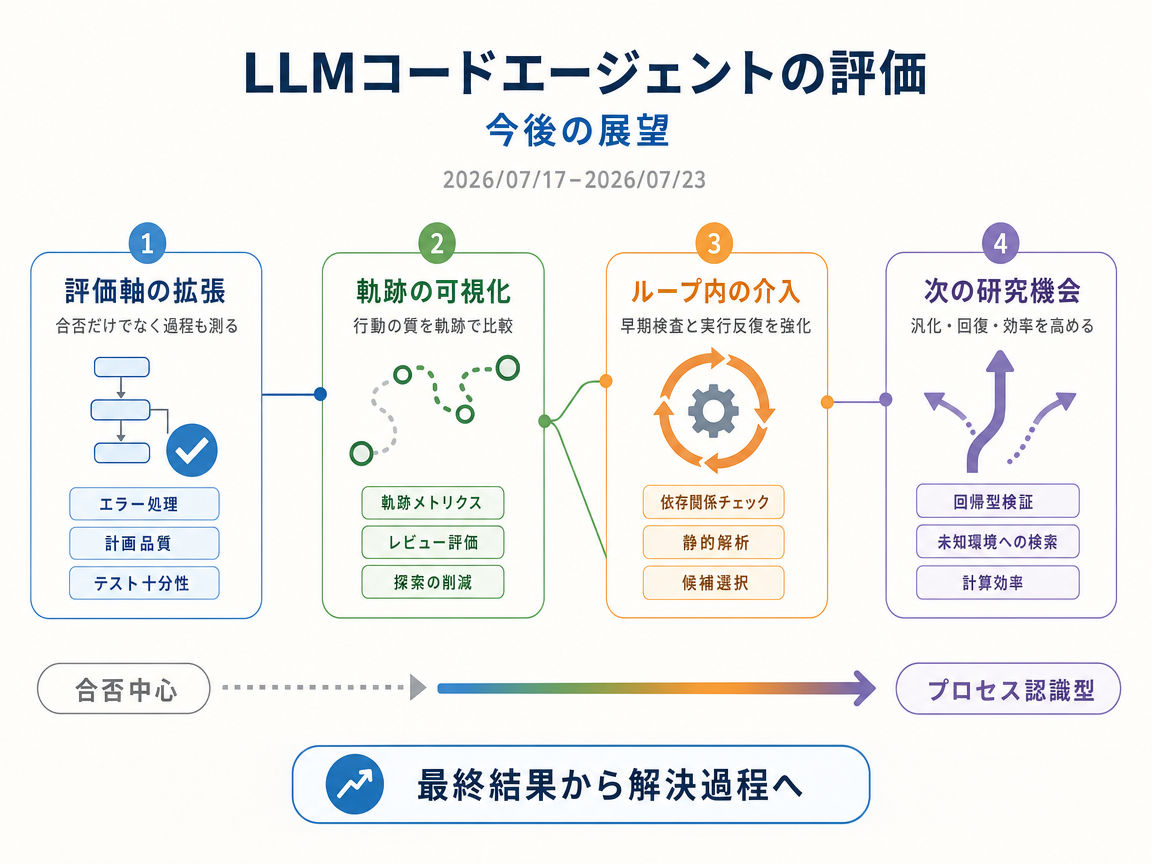
今後の展望(要約)
LLMコードエージェントの評価は、最終的な合否だけでなく、作業過程も見るベンチマークへ進む可能性が高い。今後は、エラー対応、計画の質、テストの十分さを測り、不要なパッチ変更も検出するようになる。最近の研究では、実行履歴、レビュー行動、プルリクエストの検証範囲が重視されており、この変化を後押ししている。評価は結果を判定するだけでなく、早い段階での技術確認や強力な回帰テストを促し、実行結果に基づく候補選択によって作業中のエージェントを導く役割も持つだろう。進展の鍵は、未知のリポジトリにも適応できる検索手法と、限られた計算資源を有効に使うデバッグ手法である。
インフォグラフィクス(日本語)
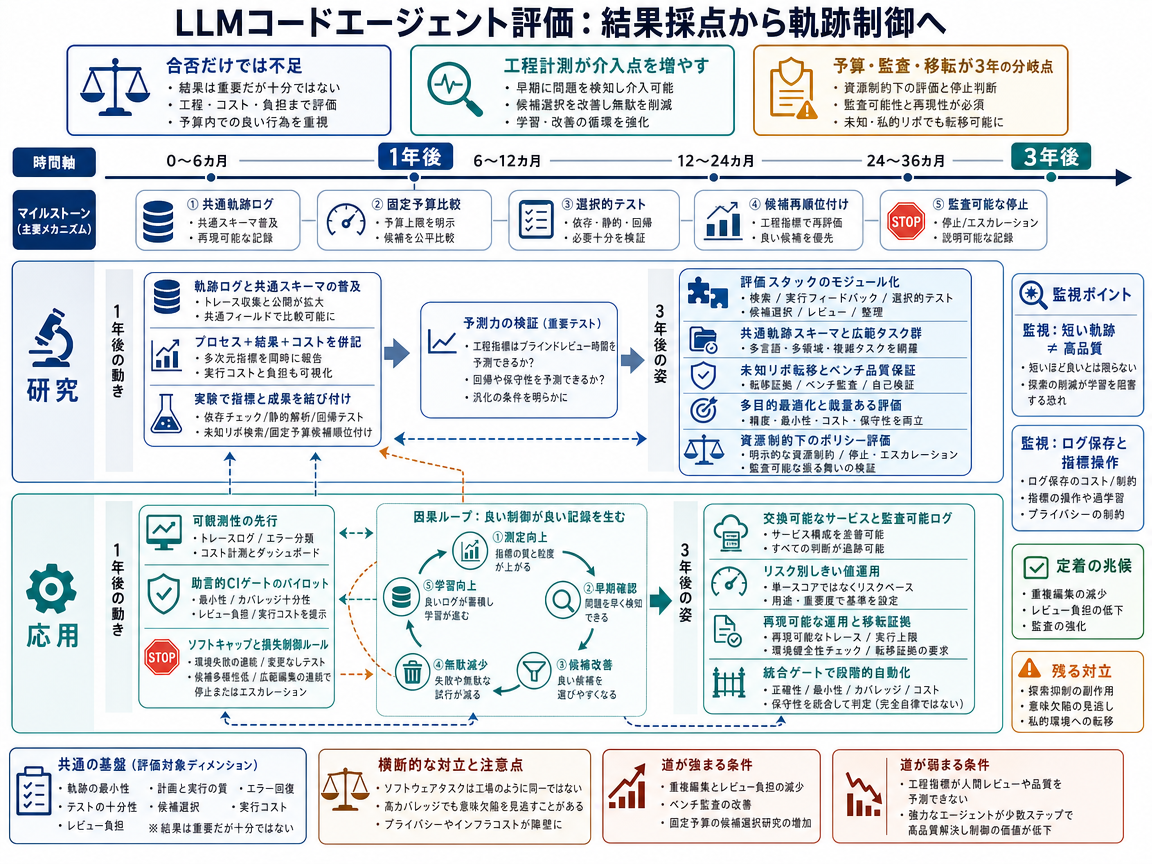
3年後を想定した動き
今後3年間で、コードエージェント評価は、無駄の少ない統計的工程管理へ発展する可能性がある。評価者は最終パッチだけでなく、計画、実行エラーからの回復、テストの十分さも測るようになる。さらに、無駄な手順や不要な変更も見つける。この仕組みでは、実行履歴を生産経路、実行失敗を欠陥、候補選択を品質ゲートとして捉えられる。
1年目には、実行履歴の記録が広まり、異なる研究間で比較しやすくなるだろう。研究では、作業過程の質、最終結果、資源使用量をまとめて報告するようになる。依存関係の確認や静的解析などの早期介入が、後の失敗を防げるか検証される。より厳密な実験では、複数の課題群と固定された実行上限を使い、生成するテストを増やせば常に品質が上がるという前提を避ける。重要なのは、課題の難しさを考慮した後でも、これらの指標が将来の回帰不具合や人間のレビュー負担を予測できるかである。
2年目には、再現可能な測定法を基礎として、エージェントの処理ループが部品化される可能性がある。検索、実行からのフィードバック、選択的なテスト生成が、共通の履歴記録を介して連携する。3年目には、これらの部品が、ソフトウェア品質と運用効率を保ちながら人間の負担を抑える成熟した制御基盤になり得る。再現可能な履歴、上限のある実行、信頼できる実行環境を求める内部規則も整備されるだろう。
主要な評価が作業過程の質、結果、資源使用量を同じ報告で示すようになれば、強い進展の兆候となる。重複編集やレビュー負担の減少も、この展開を支持する証拠になる。一方、履歴スコアが実際の回帰不具合を予測できない場合や、記録を安全に保持できない場合には、このシナリオの可能性は低下する。
今後3年間で、コードエージェント評価は、資源使用を考慮した制御手法へ発展する可能性がある。最終パッチの成功は引き続き重要だが、リポジトリ検索、エラー対応、レビュー負担も測定対象になる。この仕組みは、需要の変動に応じて消費量を調整する電力網の制御に似ている。エージェントの実行を変動する負荷と捉え、容量が限られるときには評価システムが価値の低い作業を減らす。
1年目には、ベンチマーク結果に資源利用の計測情報が加わるだろう。代表的な指標には、経過時間、実行環境の起動回数、テスト実行回数が含まれる。研究では、再試行や候補の追加が、作業継続に見合う改善を生むかを調べる。リポジトリの構造把握や事前確認なども、成果のない長時間実行を防ぐ方法として評価される。初期の実用システムは強制停止よりも可視化と推奨上限を重視し、同じ失敗が続く場合には実行を一時停止するだろう。
2年目には、固定された資源上限の下で再現可能な比較が進み、共通の計測規則が作られる可能性がある。研究者は、再利用した情報、環境構築の失敗、共有基盤の利用を一貫した方法で扱う必要がある。共通の履歴形式が整えば、モデル単体ではなく、エージェントシステム全体を比較しやすくなる。3年目には、定められた上限の下で、エージェントが開始、継続、担当者への引き継ぎのどれを選ぶべきか評価できるようになる。定型的な課題には少ない資源を割り当て、複雑な変更には大きな上限か人間による対応を用意する運用も考えられる。
主要な評価が、追加のテストや再試行によって得られる価値を示し始めれば、重要な進展の兆候となる。その証拠は、対象を絞った検証と適切な停止規則の普及を促すだろう。一方、比較可能な計測情報が広まらない場合や、作業過程の指標が保守しやすさを予測できない場合には、このシナリオの可能性は低下する。
今後3年間で、コードエージェントの作業過程を示す指標は、管理されたソフトウェア開発に残す保証記録になる可能性がある。評価ではパッチが動くかを確認するだけでなく、検索、エラー回復、検証に関する証拠も保存する。この仕組みは、完成品だけでなく、生産工程の重要な段階を監視する危害分析重要管理点方式に似ている。エージェントでは作業履歴が監査記録となり、問題を早期に発見するために使われる。
1年目には、共通指標を作り、それが合否を超えて保守しやすさや人間のレビュー負担を予測できるか調べる研究が進むだろう。実務上の試行では、ツールの利用履歴、検証の証拠、変更の由来が記録される。作業システムには、未解決エラーや不十分な検証に対する助言型のゲートが追加される可能性がある。最初の大きな転換点は、作業過程の証拠を利用条件に結び付ける有力な組織のひな型か、独立した評価制度の登場である。単なる一般的なログ保存では、エージェントの行動とパッチ品質を明確に測らない限り、この条件を満たさない。
2年目には、標準化団体や業界連合が、共通の履歴形式と重要な確認点を定める可能性がある。未知のリポジトリを使う研究により、既知の公開課題以外でも証拠が有効か検証される。ツール提供者は、決定的な再実行、早期確認、候補選択の明確な記録によって対応するだろう。これにより、証拠要件が計測機能を改善し、改善された計測機能がより正確な要件を可能にする循環が生まれる。
3年目の中心課題は、指標を見かけだけ良くする行動への対策となる。適応型エージェントは、優れたパッチを作らずに、整って見える履歴だけを生成するおそれがある。そのため研究では、敵対的テストや無作為確認を導入し、生成された検証が本当に品質の証拠になるかを因果的に調べるだろう。独立評価が作業過程の指標と利用可否を結び付ければ、有力な進展の兆候となる。一方、指標が品質を予測できない場合や、履歴を安全に保持できない場合には、このシナリオの可能性は低下する。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- CodeMonkeys: Scaling Test-Time Compute for Software Engineering - 著者: Ryan Ehrlich, Bradley Brown, Jordan Juravsky, Ronald Clark, Christopher Ré, Azalia Mirhoseini, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Unveiling Pitfalls: Understanding Why AI-driven Code Agents Fail at GitHub Issue Resolution - 著者: Zhi Chen, Wei Ma, Lingxiao Jiang, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Magellan: Autonomous Discovery of Novel Compiler Optimization Heuristics with AlphaEvolve - 著者: Hongzheng Chen, Alexander Novikov, Ngân Vũ, Hanna Alam, Zhiru Zhang, Aiden Grossman, Mircea Trofin, Amir Yazdanbakhsh, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0