サマリー
本テーマは、テキストのみのベンチマークを超えて進化する高性能な言語・マルチモーダルモデルの評価と制御のあり方に焦点を当てている。代表的な研究は、不必要な思考連鎖を回避する効率的な推論、オムニモーダルな理解と生成の統一的評価、およびモデルが自身の知識を正確に示せるかどうかのメタ認知的評価という、相互に関連する3つのニーズを浮き彫りにしている。
テーマの状況
代表的な論文群は、モデル評価が単純なタスク精度から、高性能システムの行動を意識した評価へと移行しつつある状況を描いている。一つの研究方向は、強力な推論モデルがしばしば「過剰に思考」し、容易なクエリに対してレイテンシやトークンコストを生じさせるため、モデルがいつ推論すべきか、いつ推論すべきでないかを選択できるかどうかを評価で捉える必要があると主張している。別の研究方向は、オムニモーダルシステムがテキスト・画像・音声・動画にわたる深いコンテキスト理解と高忠実度の生成を両立する統一的かつ計算効率の高いアーキテクチャをまだ欠いており、これらのモデルがスケールするにつれて広範なマルチモーダル評価が不可欠であると主張している。
補完的な代表論文は、評価をモデルの内部に向け、モデルが実際に自身の知識を把握しているかどうかを問うている。直接質問とメタ質問のペアによるメタ認知的測定を導入しており、現代のモデルは正しく回答するだけでなく、自身の知識と限界を適切に較正すべきであるというより広い懸念を反映している。補足的なエビデンスはこの方向性をエージェント型マルチモーダル設定に拡張し、視覚推論におけるツール使用の適応性やコンピュータ操作軌跡に対するVLMベースの判定器の信頼性を検証している。
- KAT-V1: Kwai-AutoThink Technical Report
- Uni-MoE-2.0-Omni: Scaling Language-Centric Omnimodal Large Model with Advanced MoE, Training and Data
- Fine-Tuning Language Models to Know What They Know
インフォグラフィクス(日本語)
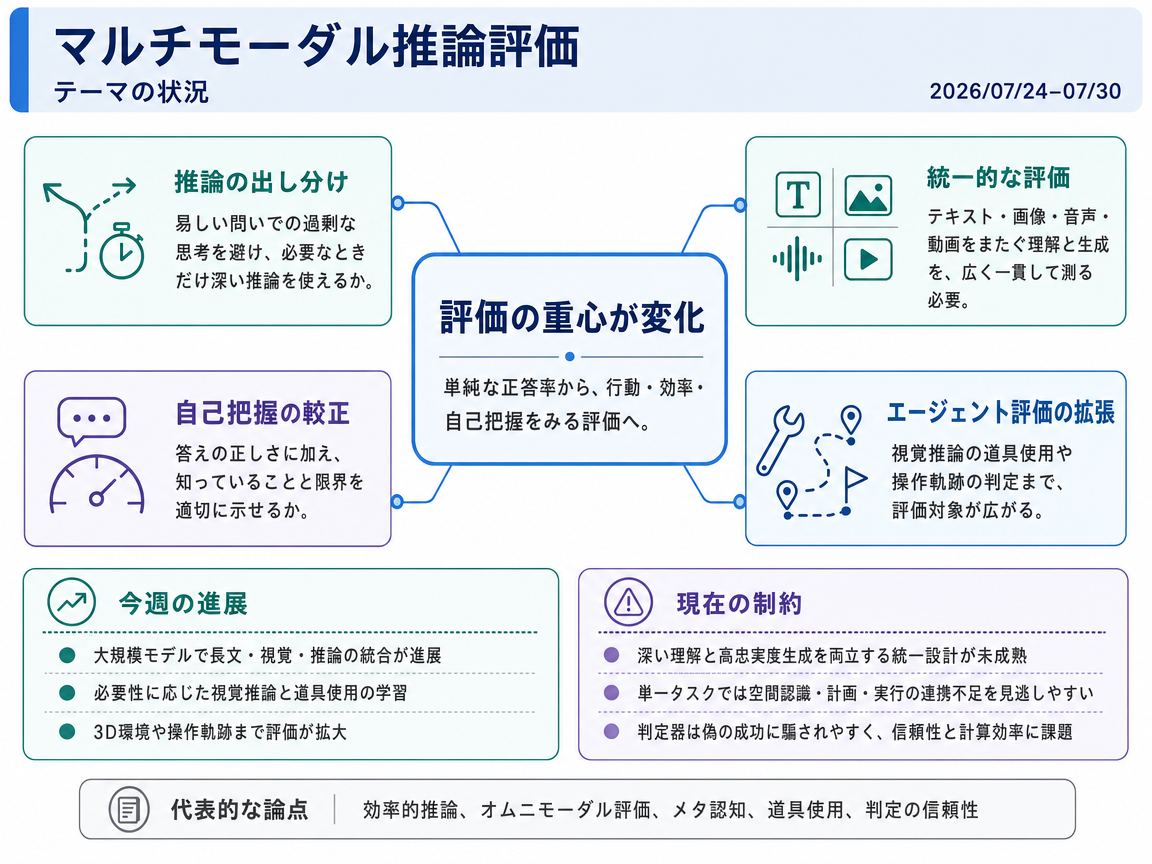
今週の進展
Kimi K3: Open Frontier Intelligence <See Details on Fugu-MT>
Kimi K3を発表した。2.8兆パラメータのMixture-of-Expertsモデルで、104億のアクティベートパラメータ、ネイティブビジョン機能、100万トークンのコンテキストウィンドウを備えている。Kimi Delta AttentionおよびAttention Residuals上に構築され、長文コーディング、エージェント、知識、推論、ビジョンタスクにおいてフロンティアレベルの性能を達成することを示した。 本論文の具体的なタスク、手法、エビデンス、または応用設定を通じて、モデル評価/マルチモーダル分野と関連している。
Beacon: Knowing When and How to Perform Agentic Visual Reasoning <See Details on Fugu-MT>
Beaconは、エージェント型ビジョンモデルがいつ、どのようにより深い推論やツールを呼び出すべきかを対象とすることで、マルチモーダル推論評価を前進させた。 必要性認識型の適応報酬とヒント誘導型ロールアウトをRL訓練に導入し、視覚推論における適応的ツール呼び出しと効果的なツール使用のギャップに具体的に対処している。
Zero-Shot Mission-Level Evaluation for Aerial MLLM Agents <See Details on Fugu-MT>
MissionBenchは、マルチモーダル評価を知覚タスクから3D環境における航空MLLMエージェントのゼロショット・ミッションレベル評価へと拡張した。 最先端モデルでもミッション成功率が35%未満であることを明らかにし、標準的な単一タスクベンチマークでは捉えられない空間認識・計画・実行の協調的なギャップを露呈した。
OSReward: Instituting Standardized Evaluation for Cross-Platform Computer-Use Reward Models <See Details on Fugu-MT>
OSRewardは、コンピュータ操作エージェント軌跡に対するVLM判定器を評価するための標準化されたクロスプラットフォームベンチマークを提供した。 現行の判定器が偽成功軌跡に容易に騙されることを示し、信頼性とコストのギャップを埋めるためにオープンな10万サンプルコーパスと訓練済み報酬モデルを公開した。
今後の展望
今後の展望(要約)
短期的には、マルチモーダル評価の中心が回答の正確さだけでなく、状況に応じた振る舞いへ移る可能性が高い。モデルがいつ深く推論し、道具を使い、自らの出力を疑うべきかが問われるようになる。研究では、対話型エージェントや長い工程を含む課題を通じて、こうした能力の検証が進むだろう。複数のメディアを扱うオムニモーダルシステムが拡大する中、条件付きルーティングとメタ認知訓練を利用し、制御可能性、信頼度の適切さ、効率を測る取り組みも重要になる。
インフォグラフィクス(日本語)
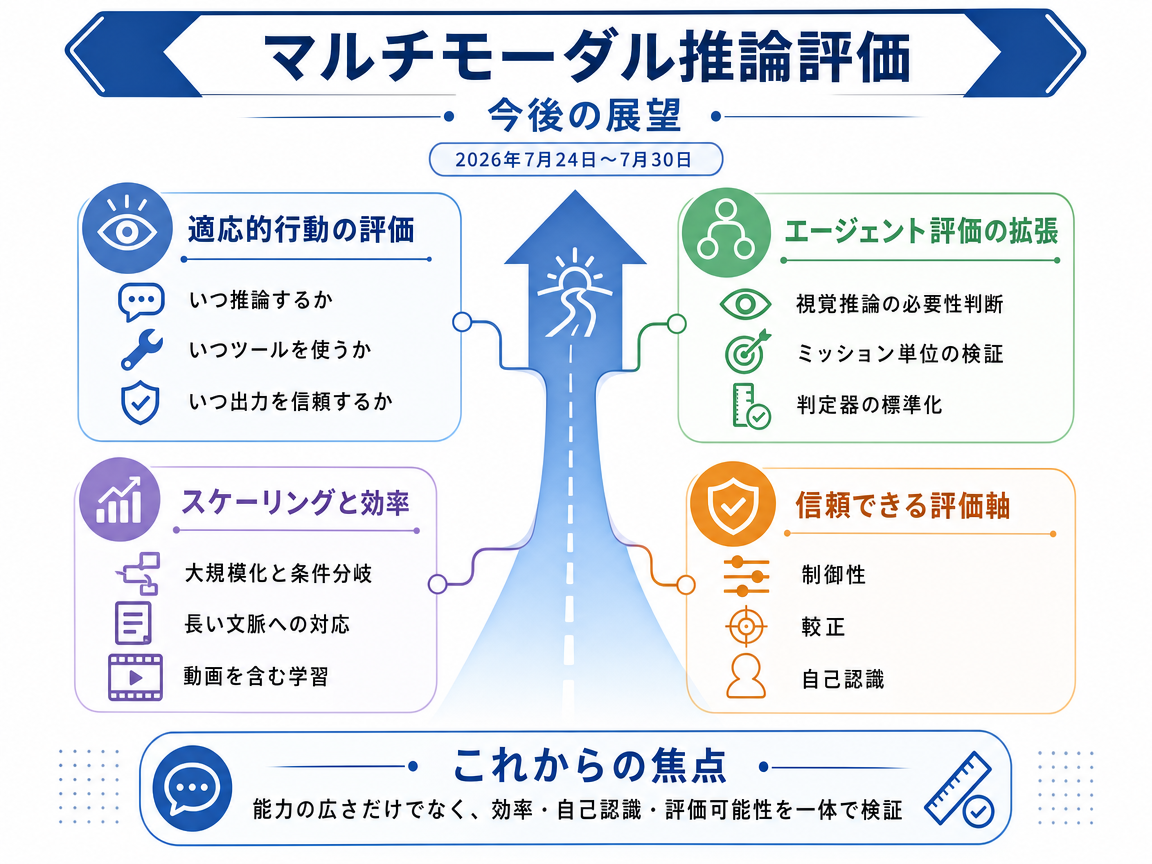
3年後を想定した動き
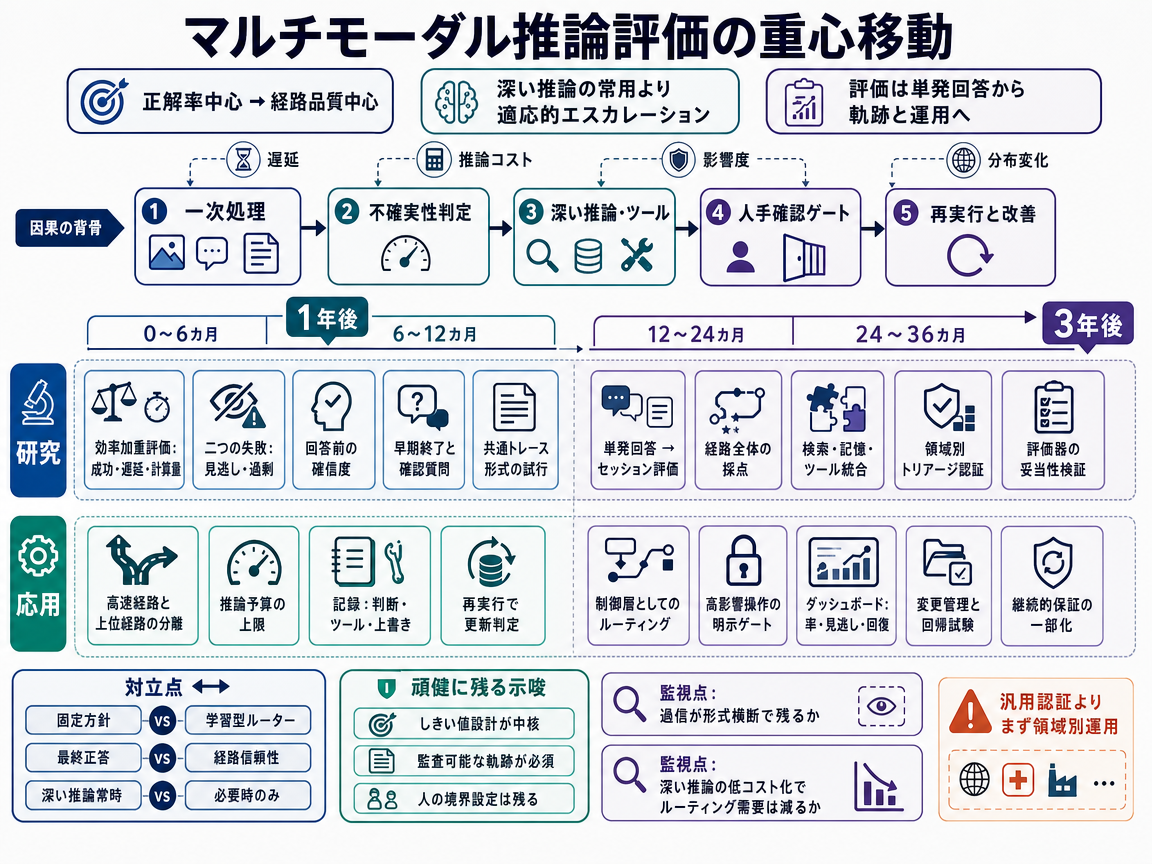
標準シナリオでは、臨床トリアージに似た仕組みをマルチモーダルシステムへ応用する。通常の課題は高速な初期処理で対応し、不確実性や重大な影響がある場合には、深い推論や人間の確認へ切り替える。1年目には、この考え方をルーティング課題として具体化し、精度、遅延、計算資源の使用量を測る。学習型ルーターと単純な固定規則を比較し、必要な切り替えの見逃しと無駄な切り替えを別々に評価する。初期の応用では、範囲を限定した作業工程に推論制御と切り替え記録を導入し、確認済みの失敗から判定しきい値を調整する。
2年目には、評価対象が単発の回答から長い対話へ広がる。データセットは個々のルーティング判断を記録すると同時に、課題全体が成功したかも検証する。システムが重要な行動の前に根拠を求めるか、追加の推論が役立たないときに停止できるかを試す。運用基盤は外部への行動前に明示的な確認段階を置き、ログを後日の検証に使える形で保存する。信頼度が課題やメディアの種類によって大きく変わる領域では、人間による監督が引き続き必要になる。
3年目までに、学習型の切り替えが固定方針を繰り返し上回れば、標準的な制御層になる可能性がある。その場合、評価は高速モデル、専門的な資源、詳細確認への引き継ぎを含む全工程を対象とする。基盤はローカルモデル、外部提供システム、人間の確認担当者を課題別の方針で連携させる。さらに計算量を制限し、終わらない処理を中断しながら、各切り替えが時間と負担に見合う情報を加えたかを示す。重要な観測指標は、不確実性に基づくルーティングが失敗と不要な計算の両方を減らすと、独立したベンチマークが示すことである。このシナリオは、メディアをまたぐ過信が残る場合や、誤った成功判定が続く場合、深い推論の負担が極端に小さくなる場合には弱まる。
対抗シナリオでは、ソフトウェア信頼性工学を中心的な仕組みとして使う。重要なエージェント実行をトレースとして記録し、失敗を再生して、将来の版が通過すべき回帰テストへ変える。自動評価器も誤る可能性がある監視装置として扱う。1年目には、適応的な推論を詳細な実行記録と課題全体の評価に結び付ける研究が進む。ルーティングの発生、信頼度の変化、道具とのやり取りから、最終回答だけでは見えない失敗を発見できるかを調べる。
1年目の後半には、共通のトレース形式と再生ツールによって、異なるシステムの失敗を比較しやすくなるだろう。敵対的テストでは、根拠がないのに成功して見える行動を評価モデルが受け入れるかを検証する。応用は、コーディング支援、コンピュータ操作エージェント、複数メディアを扱う支援システムなど、範囲を限定した作業から始まる。一部のチームは再生結果を段階的な公開や以前の版への復帰判断に結び付ける可能性がある。通常のベンチマーク平均が見逃した性能低下を課題再生が検出し、更新を実際に停止または取り消す事例が重要な到達点になる。
2年目には、障害から得たトレースを使い、作業工程ごとの回帰テスト群を構築する。新しい失敗が新しいテストを生み、その結果がルーティングや公開方針を変える循環が形成される。ただし複数の評価器が同じ誤りを繰り返すこともあるため、人間による抽出確認は必要である。3年目までには、共通の課題トレースにより、統合型マルチモーダルシステムと外部ツールを使うモジュール型システムを、より公平に比較できる可能性がある。保証層には、推論量の調整、追加根拠の要求、人間の承認要求を行う限定的な権限が与えられるかもしれない。
監視では、再生結果が実利用時の失敗を一貫して予測できるかに注目する。このシナリオは、トレースから行動理由が分からない場合や、環境変化で再生の信頼性が失われる場合、詳細記録を安全に保持できない場合に弱まる。仕組みが機能しても意味上の正しさは稼働状態だけでは判断できないため、課題別の根拠と人間の判断は残る。
可能性シナリオでは、実際の作業工程への適合性を試験する。管理されたベンチマークを実験室での検査に見立て、持ち運び可能な評価ツールで、組織がシステムに期待する実務課題を再生する。1年目には、推論効率と信頼度の調整を結び付け、自動判定器への敵対的テストも進める。内部を観察できるモデルを使えば、出力の採点だけでなく、ルーティングや道具使用の振る舞いも確認しやすい。主要な技術課題は、入力文や処理量が変化し、モデルが更新された後も測定値が安定するかどうかである。
初期の実務監査は、コーディング、文書と画像の処理、コンピュータ操作エージェントなど、範囲を限定した作業を対象とする。報告では課題の完了度と資源使用量を比べ、行動トレースの品質も確認する。さらに、管理されたベンチマークと現実の作業における性能差を示す適合係数を測る。このシナリオが加速するには、弱い評価が原因の明確な誤成功事例が確認され、複数の大規模組織が共通の試験付属文書を再利用する必要がある。共有された証拠によって試験方法の普及が進み、システム提供者によるルーティングや信頼度調整の改善につながる。その結果、後の試験に使える作業データも充実する。
2年目には、ベンチマークと実作業の差に許容範囲を設け、判定モデル自体を評価するテストを開発する。評価サービスは分野別の作業パックを管理し、継続的な適合試験によって主要な更新を確認するだろう。3年目までには、長期にわたる課題全体が評価の中心となり、局所的には妥当に見える行動と、最終的な課題達成を区別するようになる。作業工程別の評価は、モデルや制御方針、使用ツールの変更を公開する前の確認条件になり得る。安定した構成としては、公開の能力ベンチマークと、特定の作業向けに調整した非公開テストの併用が考えられる。
重要な観測指標は、共通の付属文書、再利用可能な再生ツール、誤成功事例の公開調査が広がることである。このシナリオは、指標が安定しない場合や、監査方法の整合が取れない場合、自動判定器が簡単に欺かれる場合に弱まる。校正状態と課題の成功条件は更新のたびに変わり得るため、一度限りの認証ではなく継続的な試験が必要になる。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- KAT-V1: Kwai-AutoThink Technical Report - 著者: Zizheng Zhan, Ken Deng, Huaixi Tang, Wen Xiang, Kun Wu, Weihao Li, Wenqiang Zhu, Jingxuan Xu, Lecheng Huang, Zongxian Feng, Shaojie Wang, Shangpeng Yan, Jiaheng Liu, Zhongyuan Peng, Zuchen Gao, Haoyang Huang, Ziqi Zhan, Yanan Wu, Yuanxing Zhang, Jian Yang, Guang Chen, Haotian Zhang, Bin Chen, Bing Yu, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Uni-MoE-2.0-Omni: Scaling Language-Centric Omnimodal Large Model with Advanced MoE, Training and Data - 著者: Yunxin Li, Xinyu Chen, Shenyuan Jiang, Haoyuan Shi, Zhenyu Liu, Xuanyu Zhang, Nanhao Deng, Zhenran Xu, Yicheng Ma, Meishan Zhang, Baotian Hu, Min Zhang, / <See Details on Fugu-MT> / ライセンス: CC-BY-SA-4.0
- Fine-Tuning Language Models to Know What They Know - 著者: Sangjun Park, Elliot Meyerson, Xin Qiu, Risto Miikkulainen, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0