サマリー
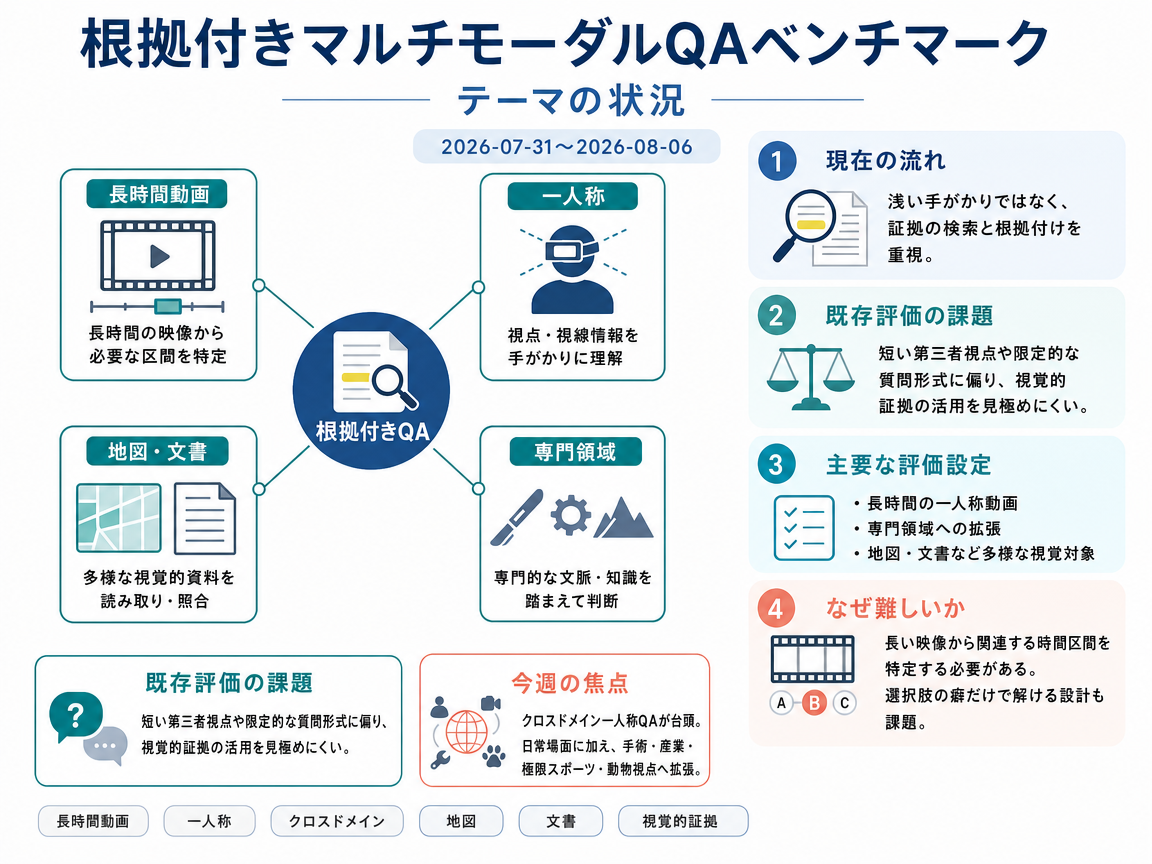
マルチモーダル質問応答のベンチマーク研究は、モデルが浅い多肢選択の手がかりに頼るのではなく、証拠を検索・根拠付けすることが求められる、より困難で信頼性の高い評価設定を志向する傾向が強まっている。今週のシグナルは一人称映像(エゴセントリック)分野でこの傾向を強化しており、クロスドメインの一人称QAが、長時間動画や専門的視覚ベンチマークと並ぶ具体的な評価設定として台頭している。
テーマの状況
代表的な論文群は共通のベンチマーク上の課題を提示している。従来の評価セットの多くは短い第三者視点の映像や限定的な質問形式に偏っており、システムが関連する視覚的証拠を真に活用しているかどうかの判断が困難であった。「Grounded Question-Answering in Long Egocentric Videos」は、長時間の一人称QAが難しい理由として、モデルが長い個人映像ストリームの中から関連する時間的区間を特定しなければならない点を主張している。また「CG-Bench」は、標準的な長時間動画の多肢選択問題が信頼できない場合があると論じており、その理由はモデルが正しい手がかり区間に根拠付けるのではなく、回答選択肢のアーティファクトを利用して問題を解く可能性があるためである。
ベンチマークの拡大は汎用的な動画を超えた領域にも広がっている。「MapVerse」は、地図を空間的・視覚的・ドメイン特化型推論のための未開拓かつ重要なテストベッドとして位置づけ、狭い範囲や高度に合成された設定ではなく、多様な実世界の地図と人間が作成した質問を用いている。今週の証拠として、「The First EgoCross Challenge at EgoVis 2026」(2608.04589v1)はエゴセントリックVQAベンチマークを手術、産業、エクストリームスポーツ、動物視点などの専門ドメインに拡張し、日常の一人称活動だけでなくドメインシフトに明示的に焦点を当てている。
- Grounded Question-Answering in Long Egocentric Videos
- CG-Bench: Clue-grounded Question Answering Benchmark for Long Video Understanding
- HierDoc: Hierarchical Page-to-Region Evidence Routing for Long-Document Visual Question Answering
- EgoAfford: Task-Oriented Affordance Grounding via Egocentric Referring Segmentation
- The First EgoCross Challenge at EgoVis 2026: Cross-Domain Egocentric Video Question Answering
インフォグラフィクス(日本語)
今週の進展
The First EgoCross Challenge at EgoVis 2026: Cross-Domain Egocentric Video Question Answering <See Details on Fugu-MT>
EgoCrossは、日常的な一人称シーンを超えた明示的なクロスドメインシフト下でエゴセントリック動画質問応答を評価することにより、根拠付きQAベンチマークを前進させた。 従来の長時間動画や汎用的なエゴセントリックデータセットと比較して、単なる長いコンテキストや標準的な活動カバレッジではなく、専門ドメインを主要な評価課題として追加している。
今後の展望
今後の展望(要約)
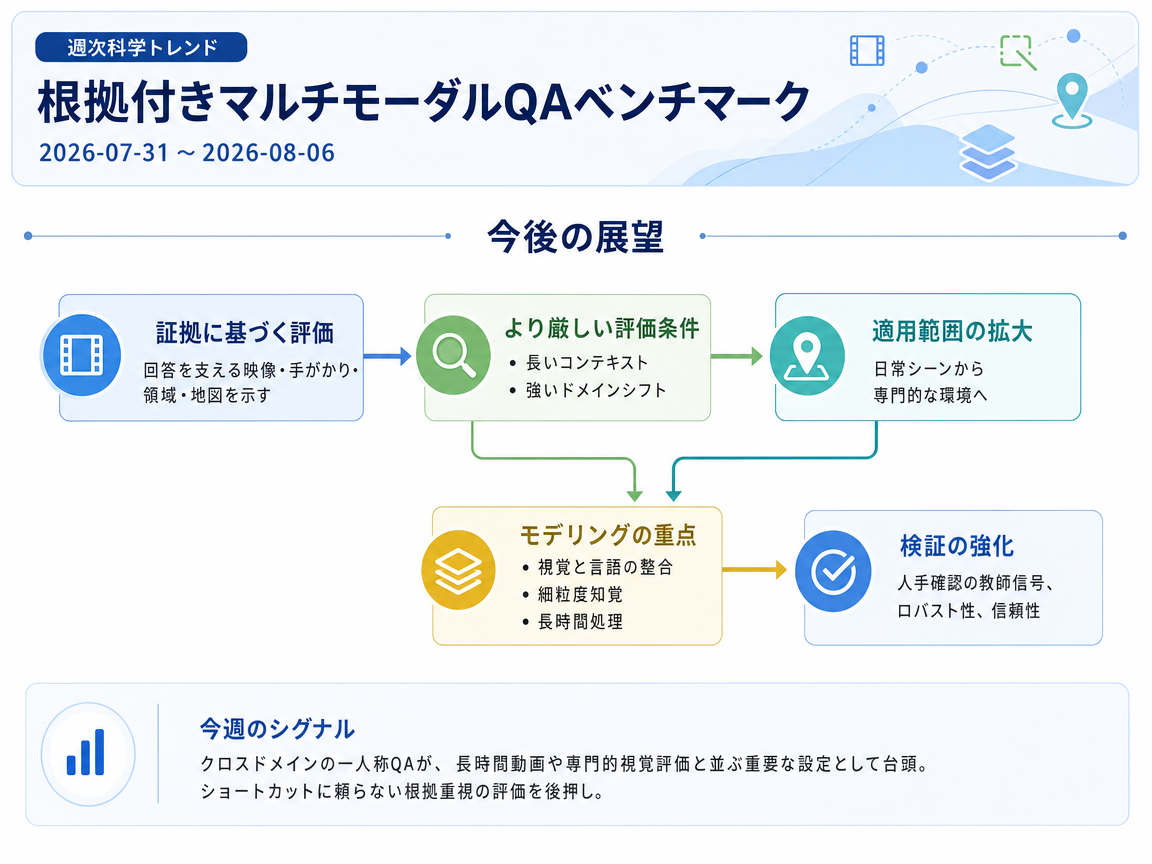
マルチモーダル質問応答は、各回答を裏付ける映像区間、画像領域、地図上の箇所をモデルに示させるベンチマークへ進む可能性が高い。評価では、より長い文脈や未知の専門領域を扱い、人が確認した教師データと、近道的な推測を見抜く検査を強化する必要がある。進歩の鍵は、視覚と言語の対応付け、物体中心の認識、高品質なデータであり、長い入力を効率よく圧縮して保持する技術も重要になる。評価範囲と信頼性検査が充実すれば、根拠を実際に利用する能力と、表面的なパターン照合を区別しやすくなる。
インフォグラフィクス(日本語)
3年後を想定した動き
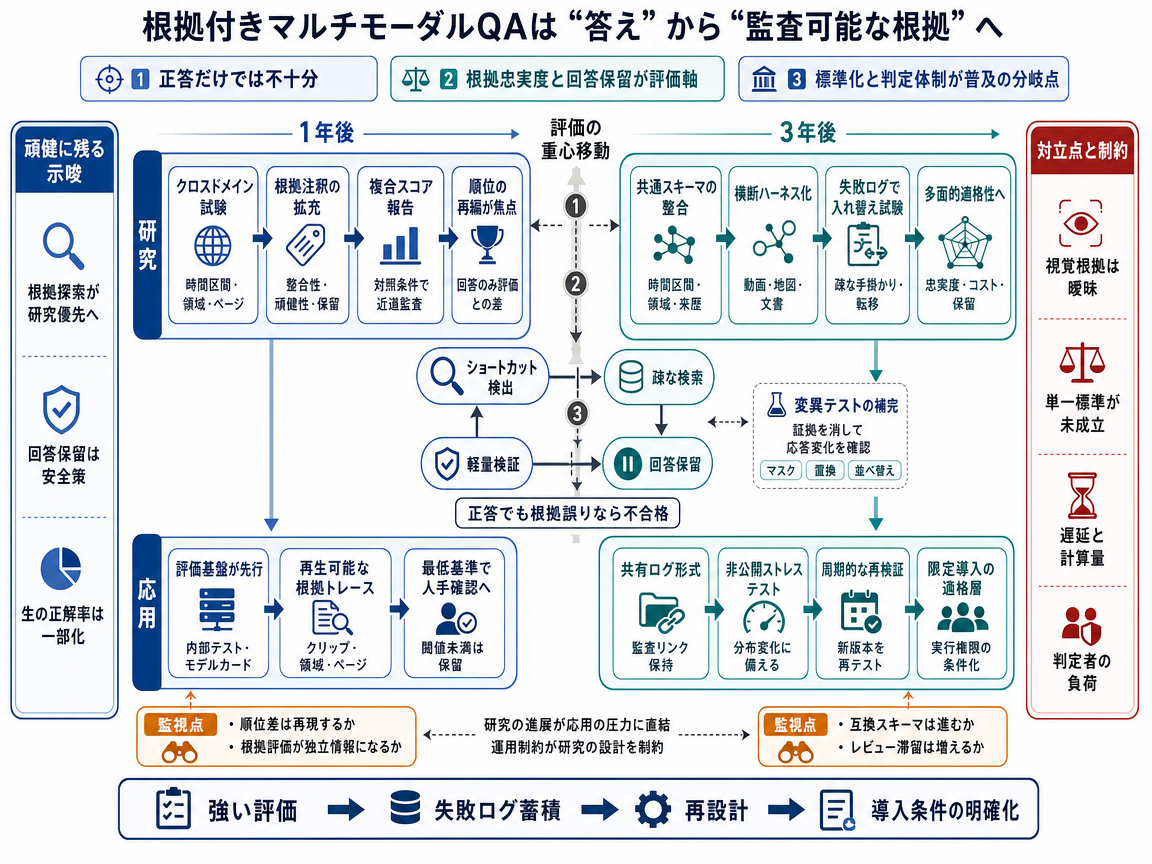
標準シナリオでは、ベンチマークが回答の正解率だけでなく、その回答を支える映像区間、画像領域、文章部分も検査するようになる。中心となる仕組みは、監査可能な根拠の記録を残し、未知の条件でも試験することである。十分な根拠がない場合には、モデルが回答を拒否できることも重視される。1年目には、データセットへ明確な根拠注釈を追加し、情報の削除や並べ替えによって近道的な推測を見抜く対照試験が増えるだろう。報告では、回答品質と根拠との整合性が別々に示されるようになる。頑健性と適切な回答拒否も、独立した評価項目として扱われる。初期の重要な兆候は、こうした尺度を加えたときにシステムの順位が再現可能な形で変わることである。
2年目までには、動画、地図、文書にまたがって根拠を表現する共通形式が整い始める可能性がある。研究の焦点は、段階的な検索、圧縮メモリ、小型の検証モデルを用いて、長い入力の確認費用を下げることへ移る。明確な事例は自動採点し、曖昧な根拠は人が確認する方式が現実的である。再現可能な失敗記録や、非公開の領域変化テストも、モデルのリリース検査で広く使われるようになる。この段階の成立には、人と自動処理を組み合わせた評価が、比較の信頼性を保ちながら過度に遅くならないことが必要である。
3年目ごろには、手掛かりが少ない問題、細かな物体、根拠が存在しない問題を狙う更新型テスト群が使われるだろう。その失敗記録を基に、人が検証した新しい事例を収集し、評価からデータ改善、さらにモデル改善へつなぐ循環が形成される。選ばれた応用では、新版が説明可能な根拠と制御された回答拒否を示すことが求められる。さらに、十分な頑健性と現実的な計算費用を満たしてから、より大きな作業権限が与えられる。正解率は引き続き示されるが、より広い適格性記録の一部になる。この動きは、根拠を考慮しても順位がほぼ変わらない場合、共通形式が普及しない場合、追加の遅延が実用性を損なう場合に弱まる。
対抗シナリオでも、評価は回答だけを見る方式から、根拠を優先する方式へ移る。特徴的な仕組みは正式な判定手続きであり、第二の確認者が、引用された映像区間、画像領域、ページ部分が本当に回答を支えるかを調べる。1年目には、回答と根拠を組み合わせた得点が導入され、根拠が部分的な場合や欠けている場合も明示的に分類されるだろう。長い文脈を扱うシステムは、多数のフレームを処理できることより、決定的な根拠を発見できることで評価される。共通の根拠形式が異なるベンチマークを結び始めても、難しい事例の判断は引き続き人が担う。
重要なきっかけは、主要な競技型評価が回答のみの順位付けをやめることである。専門的な確認への需要が担当者の処理能力より速く増えれば、根拠確認が最大のボトルネックになる。2年目までには、非公式な確認作業が、許容できる根拠と独立確認が必要な条件を定めた版管理付きの手順へ発展する可能性がある。自動評価器が明確な事例を振り分け、資格を持つ担当者が意見の不一致を解決する。認識と検索の改善は負担を減らせるが、合成された根拠ラベルには慎重な品質確認が必要である。
3年目ごろには、根拠優先の評価が動画、地図、文書へ広がるだろう。システムは監査可能な記録を保持し、利用者に関連する根拠を示し、争いのある出力を人の確認へ送る。複合的な尺度では、正しさと根拠の整合性を組み合わせ、適切な回答拒否も別途考慮する。モデルが固定試験に適応するため、ベンチマークの継続的な更新と確認担当者の能力検査も必要になる。注目すべき兆候は、報告書が確認者間の一致度、判定の遅延、人と機械の判断整合性を公表することである。この動きは、根拠出力が未検証の説明にとどまる場合、主要評価が選択式問題中心のままの場合、自動採点だけで安価に根拠を確認できる場合に弱まる。
可能性シナリオでは、根拠に基づく質問応答を、ソフトウェア工学のミューテーションテストに似た形で評価する。評価者が主張された根拠を変更または削除し、モデルの回答や確信度が変化するかを調べる。決定的な手掛かりが消えてもモデルが確信を保つなら、対になった試験によって近道的な推測を発見できる可能性がある。1年目には、既存データセットの映像や視覚入力に対し、根拠のマスク、置換、並べ替えを行う試みが増えるだろう。初期研究は、根拠の変化に対する感度と、裏付けのない質問への回答を拒否できない問題に注目する。重要な条件は、この試験が不自然な編集の検出ではなく、根拠利用の測定になっていると複数の研究で再現されることである。
初期の用途は、開発支援とリリース前の検査が中心になる。チームは、回答を支えるフレーム、物体、ページ領域が消えた後も、システムが高い確信を保つかを確認できる。編集によって無関係な情報だけが消えたり、非現実的な場面が生まれたりするため、人による変更内容の確認が重要である。2年目までには、目立つマスク処理の代わりに自然な生成編集が使われ、根拠がない場合に期待される反応を共通のミューテーション得点で表す可能性がある。さらに、未知の挙動を発見しやすい変更だけを選ぶことで、重複する計算を減らせる。
3年目ごろには、複数のモデルからなる自動システムが、回答を崩したり不当な確信を露呈させたりする最小の視覚変化を探索するかもしれない。確認された失敗は、新しい試験と狙いを定めた学習事例になり、試験、修正、再試験の循環を作る。結果に再現性があり費用も許容範囲なら、継続的な視覚テストが一部の専門システムで通常のリリース条件になる。強い兆候は、意味内容を人が検証したミューテーション得点が、複数のデータ形式で使われ始めることである。この動きは、編集後の場面が非現実的になりやすい場合、残った文脈だけで元の回答を支持できる場合、静的な根拠検査だけで十分な場合に弱まる。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- Grounded Question-Answering in Long Egocentric Videos - 著者: Shangzhe Di and Weidi Xie / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- CG-Bench: Clue-grounded Question Answering Benchmark for Long Video Understanding - 著者: Guo Chen, Yicheng Liu, Yifei Huang, Yuping He, Baoqi Pei, Jilan Xu, Yali Wang, Tong Lu, Limin Wang, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- HierDoc: Hierarchical Page-to-Region Evidence Routing for Long-Document Visual Question Answering - 著者: Rongjian Gu, Wengang Zhou, Junyu Xiong, Yonghui Wang, Bing Yin, Bei Wang, Houqiang Li / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- EgoAfford: Task-Oriented Affordance Grounding via Egocentric Referring Segmentation - 著者: Xinyuan Guan, Feifan Chen, Xinyu Zhan, Fu-Cheng Zhang, Cewu Lu, Lixin Yang / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- The First EgoCross Challenge at EgoVis 2026: Cross-Domain Egocentric Video Question Answering - 著者: Yuqian Fu, Tianwen Qian, Yanjun Li, Yu Li, Kunyu Peng, Xu Zheng, Yongqin Xian, Alessio Tonioni, Yanwei Fu, Xiaoling Wang, Danda Paudel, Federico Tombari, Luc Van Gool, Leyi Wu, Yifan Zhao, Jinjie Zhang, Yinchuan Li, Yingcong Chen, Zixu Li, Zhiwei Chen, Zhiheng Fu, Wenbo Wang, Yupeng Hu, Weili Guan, Liqiang Nie, Takuya Murakawa, Toru Tamaki, Yi Wen, Zhenglin Du, Zhengyang Li, Lingling Li, Licheng Jiao, Wenping Ma / <See Details on Fugu-MT> / ライセンス: CC BY 4.0