サマリー
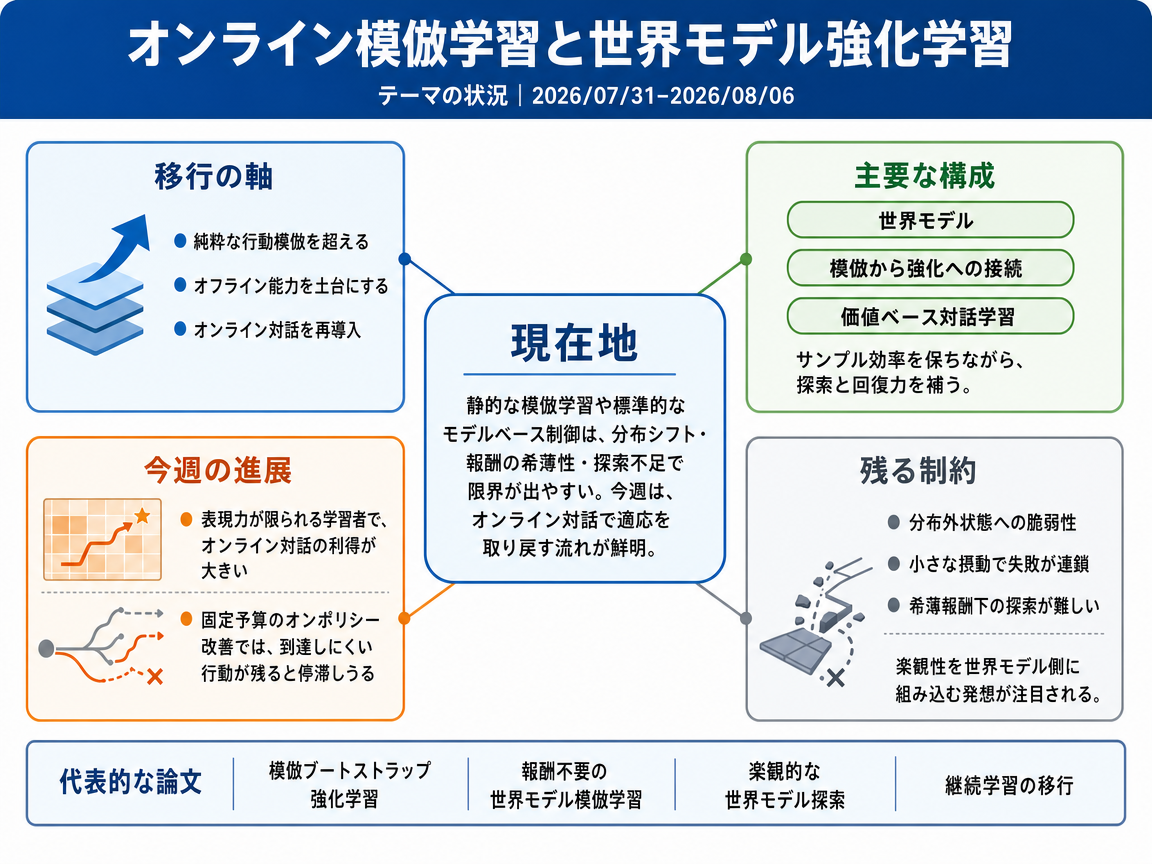
代表的な論文群は、静的な模倣学習や標準的なモデルベース制御に共通する限界に収束している。すなわち、方策がエキスパートデータの領域を離れると、分布シフト・報酬の希薄性・探索の不足に苦戦するという問題である。今週の成果は、世界モデル、模倣学習から強化学習へのブートストラップ、および価値ベースの対話的模倣学習を通じたオンライン適応の進展を示している。
テーマの状況
代表的な導入部は、純粋な行動クローニングやオフライン学習を超えた段階へと分野が移行していることを描いている。強力なオフライン模倣手法は大規模なデモンストレーションデータセットを活用できるが、分布外の状態、バイアスの蓄積、小さな摂動下での失敗に対して依然として脆弱である。それに対する応答として、サンプル効率を維持しつつオンライン対話を再導入する方向が示されている。Reward-free World Modelsは潜在世界モデルが明示的な報酬モデリングなしにオンライン模倣を支援できると主張し、Imitation Bootstrapped Reinforcement Learningは別途学習した模倣方策を用いて強化学習中の行動選択とQ値ブートストラップの両方を誘導し、デモンストレーション由来の能力を保持しつつ探索と分布シフトからの回復を改善する。
第二の代表的な研究系統として、モデルベース強化学習は報酬が希薄な設定でより優れた探索を依然として必要としている。Optimistic World Modelsはこれを標準的な世界モデル学習の限界として捉え、アクターのエントロピーのみに依存するのではなく、学習されたダイナミクス自体に楽観主義を直接組み込むことを提案している。今週の文脈として、Continual Learning in Transition(arXiv:2608.06216v1)はLLMやエージェントシステムにおける関連する動向を調査しており、能力開発が静的なオフポリシーのパラメータ更新からオンポリシー・推論時・ハーネスレベルの適応へと移行していることを示し、デプロイ後も改善を続けるシステムへの広範なトレンドを裏付けている。
- Imitation Bootstrapped Reinforcement Learning
- Reward-free World Models for Online Imitation Learning
- Optimistic World Models: Efficient Exploration in Model-Based Deep Reinforcement Learning
- Continual Learning in Transition
インフォグラフィクス(日本語)
今週の進展
When Does On-Policy Interaction Help? Representational Tradeoffs in Value-Based Imitation Learning <See Details on Fugu-MT>
学習者がエキスパートの価値関数を表現できる場合に統計的に効率的な、価値ベースの対話的模倣学習手法OVIを提案した。 オンライン対話が分布シフトに広く有効であるという従来の見方に対し、学習者がエキスパートより表現力が低い場合に利得が最大となることを具体的に示し、BC・DAgger・オフライン価値ベースILを上回る性能を達成した。
Verifier-Induced Support Reshaping in On-Policy Optimization <See Details on Fugu-MT>
検証器ベースのオンポリシー最適化が、固定ロールアウト予算下で報酬付き軌道の到達可能なサポートをどのように再形成するかを分析した。 後段の目標に関連する行動がサンプルや強化に対して希少すぎる場合、継続的なオンポリシー改善が停滞し得ることを新たに示し、オンライン適応の具体的な失敗モードを特定した。
今後の展望
今後の展望(要約)
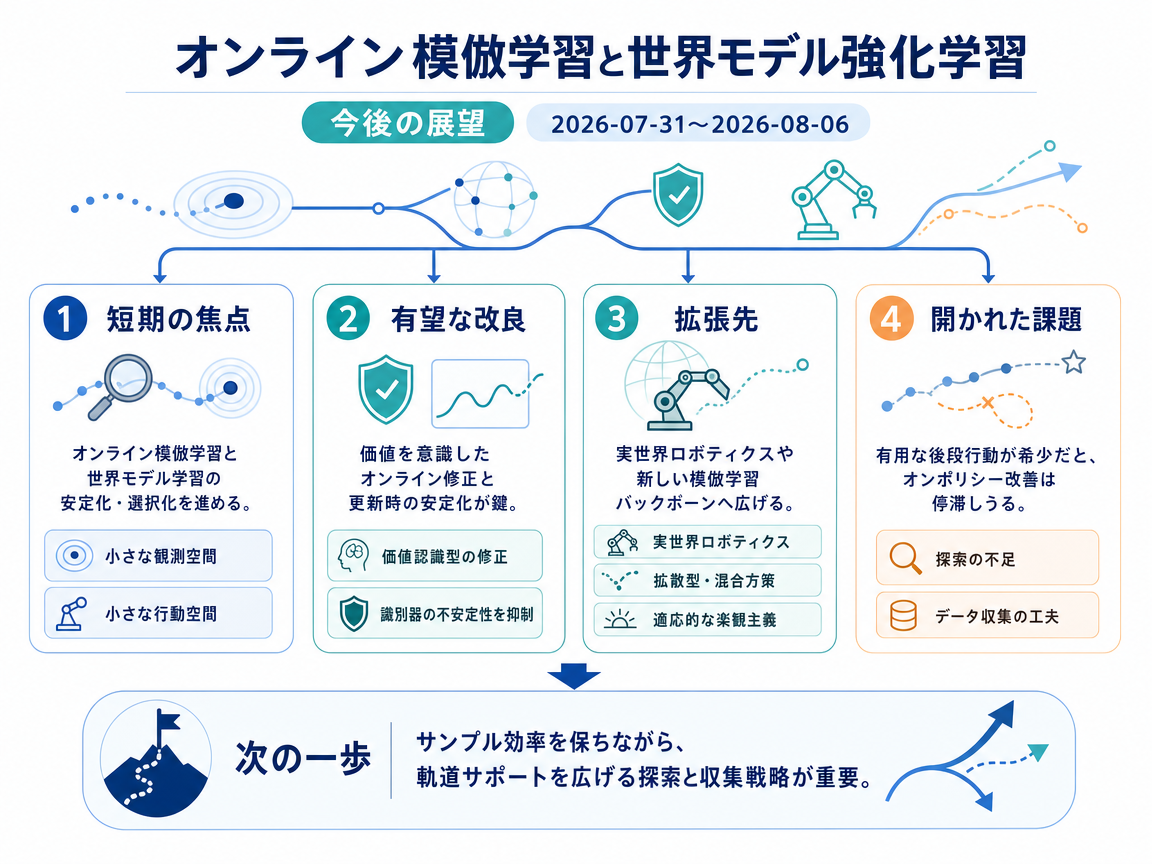
当面の研究では、オンライン模倣学習と世界モデルの訓練を、より安定的かつ選択的にする取り組みが進むだろう。特に観測空間や行動空間が小さい環境では、識別器が学習を不安定にしやすいため、改善の余地が大きい。価値推定に基づく対話的な学習は、学習器の表現能力が専門家より低い場合に最も役立つとみられる。今後は実ロボット、新しい模倣手法、探索の偏りを適応的に調整する世界モデルへと研究が広がる一方、限られた試行でも後半段階の重要な行動を十分に収集できるよう、標本効率と軌跡の網羅性を両立させる必要がある。
インフォグラフィクス(日本語)
3年後を想定した動き
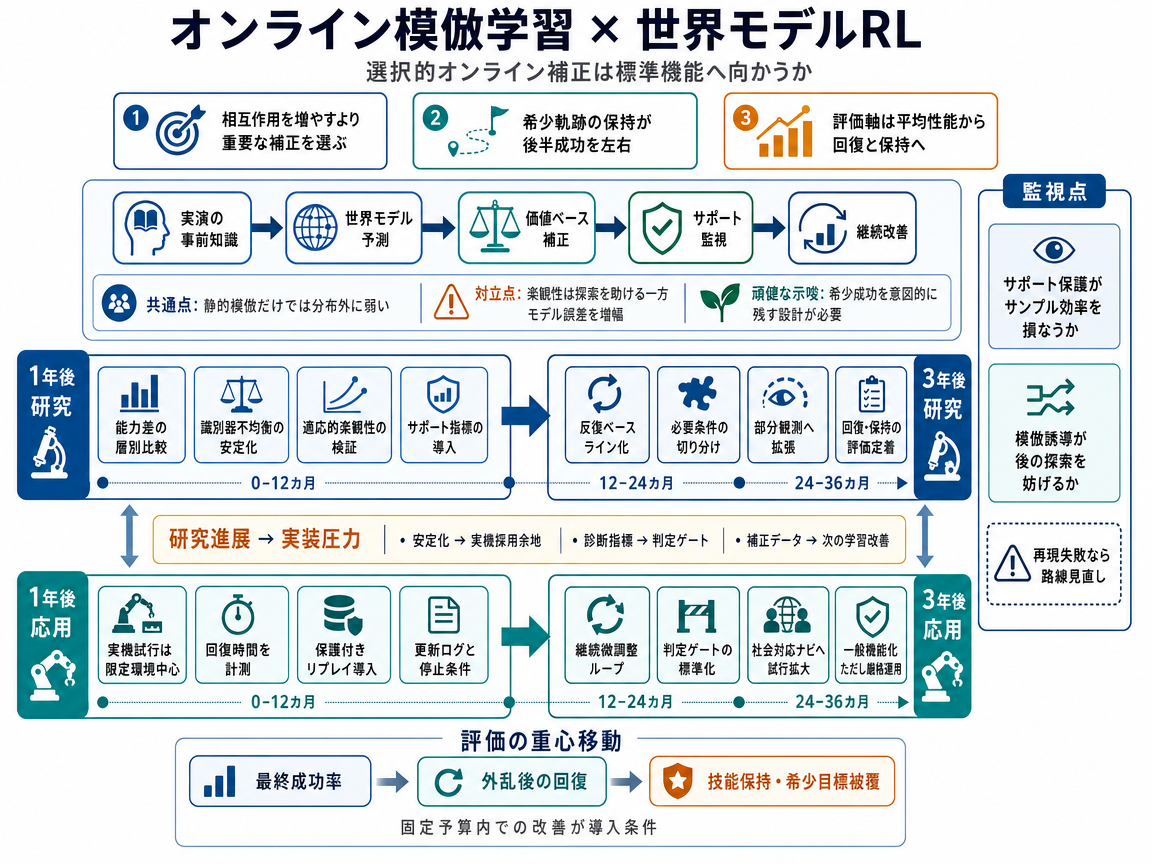
今後3年間の標準的な道筋では、身体を持つシステムに選択的なオンライン修正を導入するための共通訓練手順が整っていく。特に、学習器が専門家の行動を完全には表現できない場合に、対話的な学習が有効だという知見が基盤になる。中心となる仕組みは、初期の指針となるデモ、結果を予測する世界モデル、価値の高い修正に限定したオンライン対話を組み合わせるものだ。
1年目には、デモと試行回数が限られた条件で、この組み合わせの挙動が検証される。研究者は、小さな観測空間や行動空間で起きる識別器の不安定さに対処し、疎な報酬に隠れた結果を一時的に探索させる適応的な楽観性も調べるだろう。また、後半の作業に必要な希少状態を学習器が訪れ続けているかという、軌跡の支持範囲も測定される。再生学習や対象を絞ったカリキュラムが、対話回数を大幅に増やさず学習停滞を防ぐという再現可能な証拠が、重要な観測材料になる。
2年目には、有効な要素がロボット学習の共通基準へ統合される可能性が高い。デモによる事前学習が初期行動を与え、その後の適応を世界モデルによる計画と価値を考慮した修正が導く。研究チームは、デモの品質や制御器の能力が変わったとき、どの要素が引き続き必要かを比較する。実ロボットでは、安全性の高い修正が新しいデータを生み、そのデータが次の修正を改善する継続的な微調整が試されるだろう。
3年目までには、この手順が部分観測課題や複数主体の課題にも広がり、社会的ナビゲーションなどに応用される可能性がある。評価では、分布変化からの回復、希少技能の維持、導入後の継続的改善を確認する必要がある。複数の実機で結果が再現されれば、30~36か月目には選択的修正が身体性学習の標準基盤になり得る。ただし、楽観性がモデル誤差を長引かせる場合や、支持範囲の保護に過剰なデータが必要な場合、実機試験で基準課題の成果を再現できない場合には、この道筋は弱まる。
対抗シナリオでは、オンライン模倣学習の進歩とともに評価方法も変化する。仕組みは航空機の飛行範囲試験に似ており、通常課題の成績だけでなく、重要な行動の保持と制御された外乱からの回復も評価する。ただし、これは段階的試験を説明するための比喩であり、学習ロボットが航空機と同じ認証を受けられるという意味ではない。
1年目には、デモ回数と対話回数をそろえた条件で、この訓練範囲を測定可能にする。比較では、後半段階への到達、希少な成功、オンライン更新後の回復を追跡する。価値を考慮した対話は能力の低い学習器に特に有効とみられるため、結果は学習器と専門家の能力差ごとに分析される。また、内部的な支持範囲の指標が、目的のない新奇性ではなく課題に必要な行動を捉えているかも検証される。固定予算での回復曲線や支持範囲の保持結果を、平均性能とともに求めるベンチマーク群の登場が主要な観測材料になる。
2年目には、広く使われる評価群が外乱の分類、計算方法、能力差の区分を標準化する可能性がある。記録方法の改善により、オンライン更新が希少だが必要な軌跡段階への到達を失わせる場面が明らかになる。アルゴリズムは危うくなった段階へ試行を振り向けるか、希少経験を再生し、網羅性が縮小した場合には探索を抑えるようになる。ロボット研究室では、こうした検査を自動検証工程に組み込み、不合格なら更新を止めるかデモ由来の制御器へ戻すことが考えられる。
3年目までには、主要な評価が通常時の能力、外乱からの回復、対話コストを一つの点数にまとめず比較するようになる。未知の分布変化と実機試験を通じて、支持範囲の指標が既知の外乱への過適合ではなく、現実の転移を予測できるかが確かめられる。一部の操作課題や移動課題では、運用条件を広げる前に、範囲を限定したオンライン改善を示すことが強いシステムの要件になり得る。ただし、支持範囲の指標が最終成績以上に回復を予測できない場合や、実機で支持範囲の喪失が再現されない場合、詳細な試験でも手法の順位が変わらない場合には、このシナリオは弱まる。
可能性シナリオでは、オンライン修正を、導入後の問題監視を参考にした保証手続きへ結び付ける。デモは範囲を限定した初期試験、予期しない分布変化は報告対象の事象となり、あらかじめ定めた修正計画が回復方法を制御する。この比喩は監査可能な学習を支えるが、適応するロボットを変化しない製品として扱うものではない。
1年目には、試行回数を固定した条件で、学習器と専門家の能力差および軌跡の網羅性に関する信頼性試験が定義される。低次元課題における識別器の不安定さにも対処し、適応的な楽観性を制限して記録できるかが検証される。目標は、許可された更新規則、回復条件、巻き戻し試験を備えた限定修正パッケージを作ることだ。初期の応用では、制限のない適応よりも監視と管理された試験導入が重視される。新しい網羅性指標を使った分布変化からの回復証拠を求める標準化会議や調達用ひな型の登場が、重要な観測材料になる。
2年目には、成功した試験が、修正ソフトウェアと保証工程を結ぶ標準適合キットになる可能性がある。組織は、方策を変更できる時期や収集可能なデータ量を制限し、元に戻す条件を定めた更新範囲を設定するだろう。共有された事象報告から現実環境における分布変化の典型例が明らかになり、世界モデルの改善に役立つ。評価機関や大規模な導入組織が、記録されたオンライン修正を安全性の肯定的な証拠として受け入れれば、このシナリオは重要な段階を越える。
3年目までには、事象の証拠、修正手法、共通試験ツールが相互に改善を促す循環を形成し得る。モジュール型システムでは、模倣部分、世界モデル、更新工程を個別に点検できるようになる。評価の中心を回復と安全な巻き戻しに置くことで、導入先は囲われた産業施設から病院の廊下や管理された歩行空間へ広がる可能性がある。ただし、更新のたびに大規模なシステム変更とみなされ、全面的な再評価が必要になるおそれがある。網羅性指標を再現できない場合や、公開試験が不安定なままの場合、共通の事象報告制度が生まれない場合にも、この道筋は弱まる。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- Imitation Bootstrapped Reinforcement Learning - 著者: Hengyuan Hu, Suvir Mirchandani, Dorsa Sadigh / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Reward-free World Models for Online Imitation Learning - 著者: Shangzhe Li, Zhiao Huang, Hao Su, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Optimistic World Models: Efficient Exploration in Model-Based Deep Reinforcement Learning - 著者: Akshay Mete, Shahid Aamir Sheikh, Tzu-Hsiang Lin, Dileep Kalathil, P. R. Kumar, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Continual Learning in Transition - 著者: Zhiyan Hou, Dan Zhang, Tao Feng, Liyuan Wang, Wei Li, Xiangzhao Hao, Hongyan An, Junfeng Fang, Haokai Ma, Zhaohui Xu, Haiyun Guo, Jinqiao Wang, Tat-Seng Chua / <See Details on Fugu-MT> / ライセンス: CC BY 4.0