サマリー
今週の強化学習研究は、RLシステムのさらなる汎用化、計算効率の向上、および高負荷な訓練体制下での安定性に焦点を当てている。LLM生成によるセルフプレイ環境、シミュレーションから実機への敵対的方策転移、深層Q学習の不安定性に関する精緻な診断が進展し、統一的なMCTSベンチマーク、GPU高速化ゲーム基盤、高更新率最適化に関する代表的研究を補完している。
テーマの状況
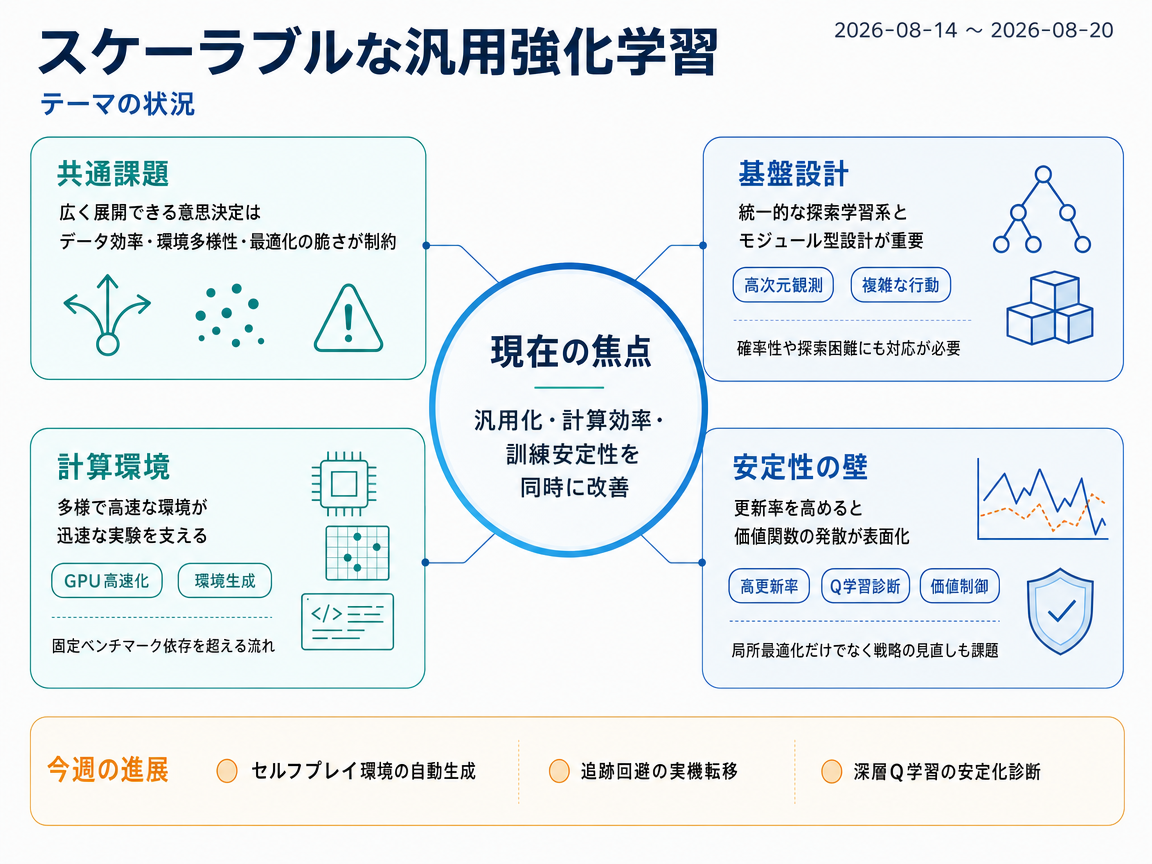
代表的な先行研究は共通の課題を提示している。個別ドメインでは強力なRL成果が存在するものの、広く展開可能な意思決定システムはデータ効率、環境の多様性、脆弱な最適化に依然として苦戦している。LightZeroは、汎用的な意思決定知能には統一的なMCTS/MuZeroスタイルのアルゴリズムとモジュール型システム設計が必要であり、高次元観測、複雑な行動空間、確率性、シミュレーションコスト、困難な探索に対処すべきと主張する。Ludaxはこれを補完し、ゲームと学習の進歩には多様かつ計算効率の高い環境が不可欠であるとし、迅速なRL実験のためのGPU高速化ボードゲームDSLを動機付けている。
第二の課題はサンプル効率を積極的に追求した際の訓練安定性である。「Dissecting Deep RL with High Update Ratios」は、環境ステップあたりの更新回数を増やすと、単純な初期データの過学習ではなく、最適化に起因する価値関数の発散が露呈すると論じ、安定した高UTDオフポリシーRLを中核的なシステム課題として位置付けている。今週のエビデンスとして、「What is Missing from AI Post-Training AI: An Empirical Analysis」(2608.19072v1)は、実行レベルの反復と戦略レベルの見直しを区別し、エージェントが局所的には最適化できても全体戦略を再考できないことを発見しており、より適応的な学習ループを目指すRL研究にとって隣接する課題を提起している。
- LightZero: A Unified Benchmark for Monte Carlo Tree Search in General Sequential Decision Scenarios
- Dissecting Deep RL with High Update Ratios: Combatting Value Overestimation and Divergence
- Ludax: A GPU-Accelerated Domain Specific Language for Board Games
- What is Missing from AI Post-Training AI: An Empirical Analysis
インフォグラフィクス(日本語)
今週の進展
PureTD: Reinforcement Learning for Backgammon Money Games with No Evaluation-time Search <See Details on Fugu-MT>
PureTD: 評価時探索なしの設定で、TDGammonをバックギャモンマネーゲームとして再検討する。チェッカープレイとキューブアクションは、手書きロジックを最小限に抑え、専門家特徴量なしのセルフプレイ強化学習によりゼロから学習される。 本論文の具体的なタスク・手法・実験結果・適用設定を通じて、強化学習研究に貢献している。
SPADE: Self-Play in Adaptive Synthetic Executable Environments <See Details on Fugu-MT>
SPADEは、LLMが実行可能なGymスタイルの訓練環境をコードとして生成するセルフプレイRLフレームワークを導入し、固定ベンチマークを超えてRL環境基盤を拡張する。 手作りや静的な環境に依存する代わりに、文書に基づく合成訓練世界と蓄積型環境メモリを追加している。
AgilePE: Autonomous UAV Pursuit-Evasion via Self-Play Reinforcement Learning <See Details on Fugu-MT>
AgilePEはセルフプレイRLを自律UAVの追跡回避に拡張し、敏捷な低レベル制御、優先度付き仮想セルフプレイによる敵対的方策最適化、シミュレーションから実機への展開を組み合わせている。 多様な対戦相手によるセルフプレイ戦術がシミュレーションから実際の二者間空中インタラクションへゼロショットで転移可能であることを示し、ゲームのみのセルフプレイ検証を超えた実証を行っている。
Understanding and Stabilizing Deep Q-Learning via Controlled Bootstrapping and Regulated Value Dynamics <See Details on Fugu-MT>
本研究は深層Q学習の不安定性を体系的に分析し、報酬ブートストラップの罠と特徴的なパラメータスパイクのダイナミクスを特定している。 価値関数発散に関する従来の広範な診断を超え、制御されたブートストラップと規制された価値ダイナミクスを提案し、Atari-100KおよびProcgenでの安定性改善を報告している。
今後の展望
今後の展望(要約)
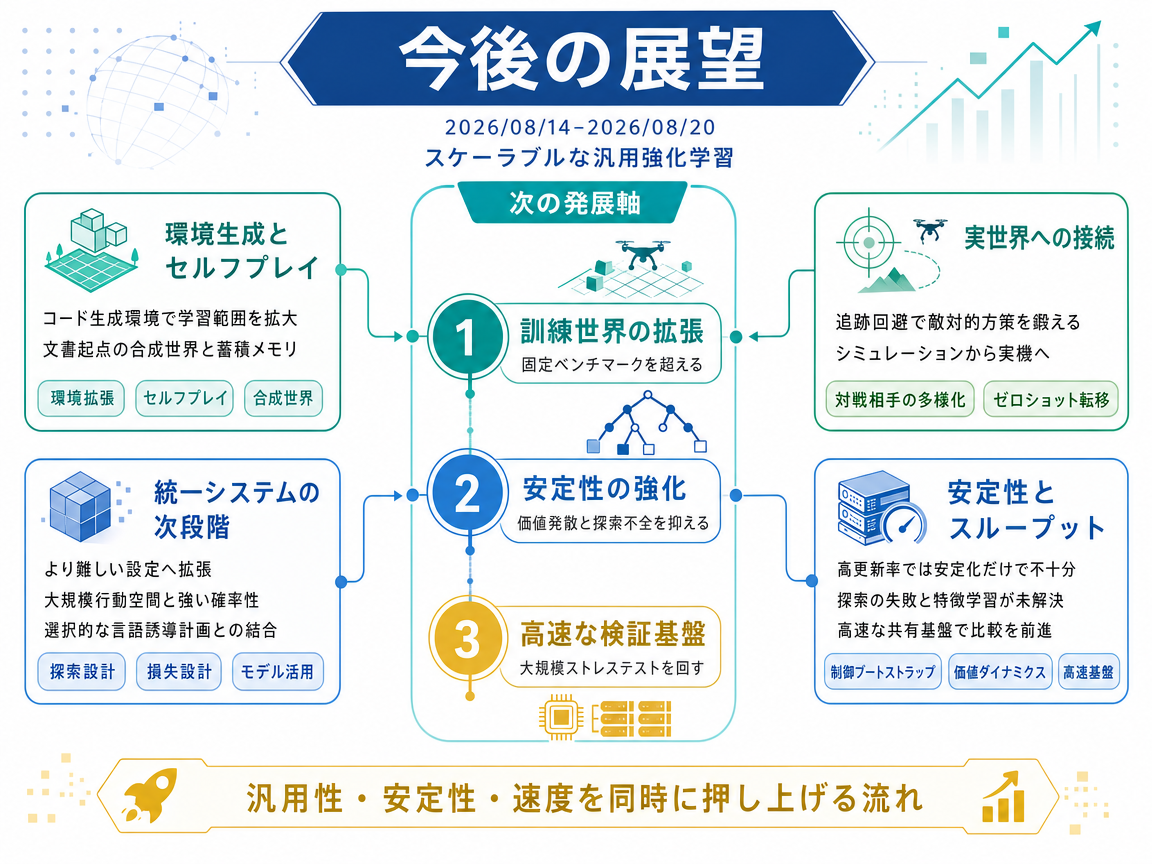
汎用的な強化学習は、より大きな行動空間や複数形式を含む行動空間、強いランダム性、実用的な課題に対応するため、探索とモデルベース手法を統合したシステムへ進みつつある。プログラム可能な自己対戦環境や、シミュレーションから現実環境への移行実験も、学習条件の幅を広げている。ただし現在の進歩は、アルゴリズムの適用範囲だけでなく、学習の安定性と処理速度にも左右される。少ないデータを何度も更新に使う学習では、価値推定の発散や探索不足、特徴表現の弱さが残る。GPU上で動く環境ツールと共通の大規模ベンチマークが整えば、探索や自己対戦、学習された世界モデルを同じ条件で比較し、問題を早期に発見しやすくなる。
インフォグラフィクス(日本語)
3年後を想定した動き
標準シナリオでは、単一の支配的なアルゴリズムではなく、多様な強化学習手法を扱う総合的な開発基盤が中心になる。その原動力は、低コストな環境、詳しい診断、安定した学習の間に生まれる改善の循環である。実験が高速になれば、価値の過大推定や探索の崩壊を早く見つけられ、制御技術の改善によって幅広い環境を試しやすくなる。近年のシステムは、実行可能な世界の生成、探索を使わない手法、物理制御を含む自己対戦を支えることで、この方向を後押ししている。
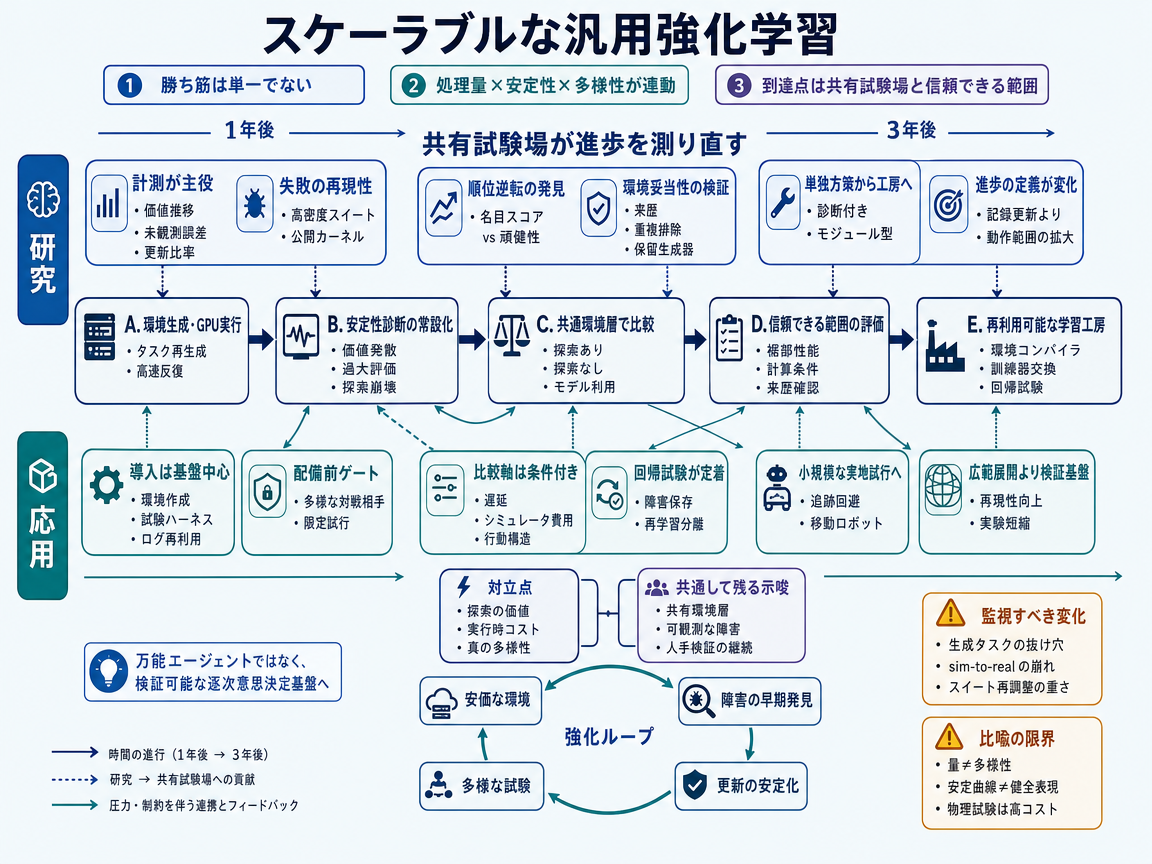
最初の1年には、生成された課題とGPU上のシミュレーターを、既存の探索システムまたは自己対戦システムにつなぐ研究が進む。報告では課題の得点だけでなく、極端な価値推定、未知の行動に対する誤差、不安定なブートストラップなどの内部信号も示されるようになる。ここでいう不安定なブートストラップとは、学習器が自らの不正確な予測を繰り返し学習目標に使う状態である。特徴表現への制約と、価値更新を安定させる仕組みも、標準的なベンチマーク設定になるだろう。外部チームが長期間の専用開発なしに課題群を追加し、複数方式を比較しながら高頻度更新を安定して実行できるかが重要な基準になる。
2年目には、共通の環境層が複雑な行動空間、確率的な変化、明示的な探索試験を支えるようになる。シミュレーションが安価な場合は探索が有力だが、実行時の計画が遅すぎる場合は探索を使わない方策が重要になる。応用チームは環境コンパイラーと価値推定の履歴検査を日常的に使う一方、生成課題の抜け道を見つけるには人間の確認も必要になる。
3年目には、個別の方策設計よりも、意思決定システム全体を試作できる基盤に関心が移る。この基盤は環境構築と高速シミュレーションを土台とし、複数の学習方式と安定性監視を交換可能な部品として組み合わせる。未知の相手や変化した力学条件でも、物理環境への移行が独立に再現されれば、空中ロボットや移動ロボットで限定的な試験を広げる根拠になる。生成課題が簡単に攻略される場合や、安定化に大幅な再調整が必要な場合、元の試験条件を外れると性能が崩れる場合には、この進路は弱まる。課題数が多くても多様性が表面的なことはあり、価値曲線が安定していても内部表現が弱い可能性は残る。
対抗シナリオでは、強化学習システムの比較方法そのものが変わる。固定された一つのベンチマークで最高得点を競う代わりに、システムが信頼できる課題と条件の範囲を示す「信頼性の包絡線」を測る。この仕組みは耐容量試験に似ており、乱数条件や対戦相手、計算資源の制約が変わっても保たれる性能を評価する。高速な環境と詳しい計測機能によって、この広い試験をシステム設計に影響するほど低コストで実施できるようになる。
最初の1年には、ベンチマークを整備する組織が、実行可能な課題生成、高速シミュレーション、不安定学習の診断を組み合わせたストレス評価を作る。報告では最高性能を、典型的な性能や最悪時の挙動と分けて示し、評価時探索の実行コストも明記する。重要な転機は、固定課題では低得点だった手法が課題の変化に耐え、見かけ上の首位手法を上回る順位逆転が再現されることである。そうなれば、ベンチマーク管理者は評価範囲を反映した得点と、その内訳を導入する可能性がある。信頼性の包絡線が任意の補足ではなく、主要な研究成果に当然求められる要素になれば、この段階の基準を越えたといえる。
2年目には、複数の研究機関が、どのストレス条件がロボットや制御課題への移行を予測できるかを検証する。新規性によって妥当性が見えにくくならないよう、生成された試験と固定の標準試験は分けて扱う。物理試験での失敗を新しいシナリオに反映すれば、広い試験が環境ツールの改善を促し、その改善が次の試験を安くする循環が生まれる。独立した再実行と、課題の生成元を追跡できる記録が重要な観測指標になる。
3年目には、無制限の汎用性ではなく、明示された動作範囲に合わせてシステムを設計する。シミュレーションが十分に安価なら探索を使い、応答時間が厳しい場面では安定した方策や学習済みモデルの役割を大きくする。共通の観測ツールにより、相手や環境、失敗パターンが試験済みの範囲を外れたことも把握しやすくなる。信頼性得点が現実の結果を継続的に予測できれば、検証済みのシナリオ群を、追加の物理試験へ進む前の継続的な確認工程にできる。この進路は、生成課題が表面的な場合や順位逆転を再現できない場合、ストレス得点が未知条件での挙動を予測しない場合に弱まる。また、設計された課題は攻略される可能性があり、導入後の条件を十分に表さないため、信頼性の評価範囲は対象領域ごとに定める必要がある。
可能性シナリオでは、最初に広く役立つ強化学習基盤は、高度に自律的なエージェントではなく試験ハーネスになる。この仕組みはソフトウェアのファジングに似ており、生成された環境や対戦相手が珍しいストレス入力を与え、再現可能な行動上の失敗が調査対象になる。安定性の計測情報を使えば、計画の誤りと学習過程の不安定さによる失敗を区別しやすくなる。
最初の1年には、制約付きの環境生成、まとめて実行するシミュレーション、決定論的な再生機能を継続的な検証工程につなぐ。生成された課題には不可能な力学条件や誤解を招く報酬が含まれ得るため、実行可能なコードだけでは足りない。自動検証と人間による確認を工程に組み込み、発見した失敗を単純で再現可能な事例まで縮小する必要がある。強いシステムはその事例を分類し、版管理された回帰試験群に保存する一方、未公開の評価事例を再学習用の課題から分離する。固定ベンチマークが見逃す重大な失敗を発見し、独立チームが手作業より低いコストで再現できれば、最初の大きな基準を越える。
2年目には、成功した試験導入が、持ち運び可能な環境形式と標準的な方策インターフェースへ収束していく。独立した評価者は、同じシナリオ群を異なるシミュレーターで再実行し、失敗が一般的なものか、特定の実行エンジンだけの問題かを判断する。研究では、計画の弱さ、内部表現の不足、価値更新の不安定さも分けて調べる必要がある。人工的に生成された試験での失敗と、限定された物理試験で後に見つかる問題との相関が繰り返し確認されれば、強い観測指標になる。
3年目には、共通の保証層によって、探索型プランナー、学習済み世界モデル、探索を使わない方策を同じシナリオ制御の下で試験できるようになる。定期的に入れ替える未公開試験群と課題の由来記録により、既知の試験だけに合わせた最適化が難しくなる。試験範囲が広がるほど多くの失敗が見つかり、それが課題テンプレートと観測機能の改善を促して、得られる証拠の信頼性を高める。ハーネスへの合格は次の試験に進む根拠にはなるが、安全性そのものの証明にはならない。生成環境が頻繁に無効になる場合や、インターフェースが分断されたままの場合、人工的な失敗が物理環境の結果と結び付かない場合には、このシナリオは弱まる。さらに、強化学習の方策は試験中にも変化し得るうえ、行動の網羅度には通常のコード試験ほど明確な完全性の尺度がないため、ファジングとの類似には限界がある。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- LightZero: A Unified Benchmark for Monte Carlo Tree Search in General Sequential Decision Scenarios - 著者: Yazhe Niu, Yuan Pu, Zhenjie Yang, Xueyan Li, Tong Zhou, Jiyuan Ren, Shuai Hu, Hongsheng Li, Yu Liu / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Dissecting Deep RL with High Update Ratios: Combatting Value Overestimation and Divergence - 著者: Marcel Hussing, Claas Voelcker, Igor Gilitschenski, Amir-massoud Farahmand, Eric Eaton / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Ludax: A GPU-Accelerated Domain Specific Language for Board Games - 著者: Graham Todd, Alexander G. Padula, Dennis J. N. J. Soemers, Julian Togelius, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- What is Missing from AI Post-Training AI: An Empirical Analysis - 著者: Joy Jia Yin Lim, Xin Huang, Hao Peng, Yaxi Lu, Xin Cong, Zhong Zhang, Maosong Sun, Yankai Lin / <See Details on Fugu-MT> / ライセンス: CC BY 4.0