サマリー
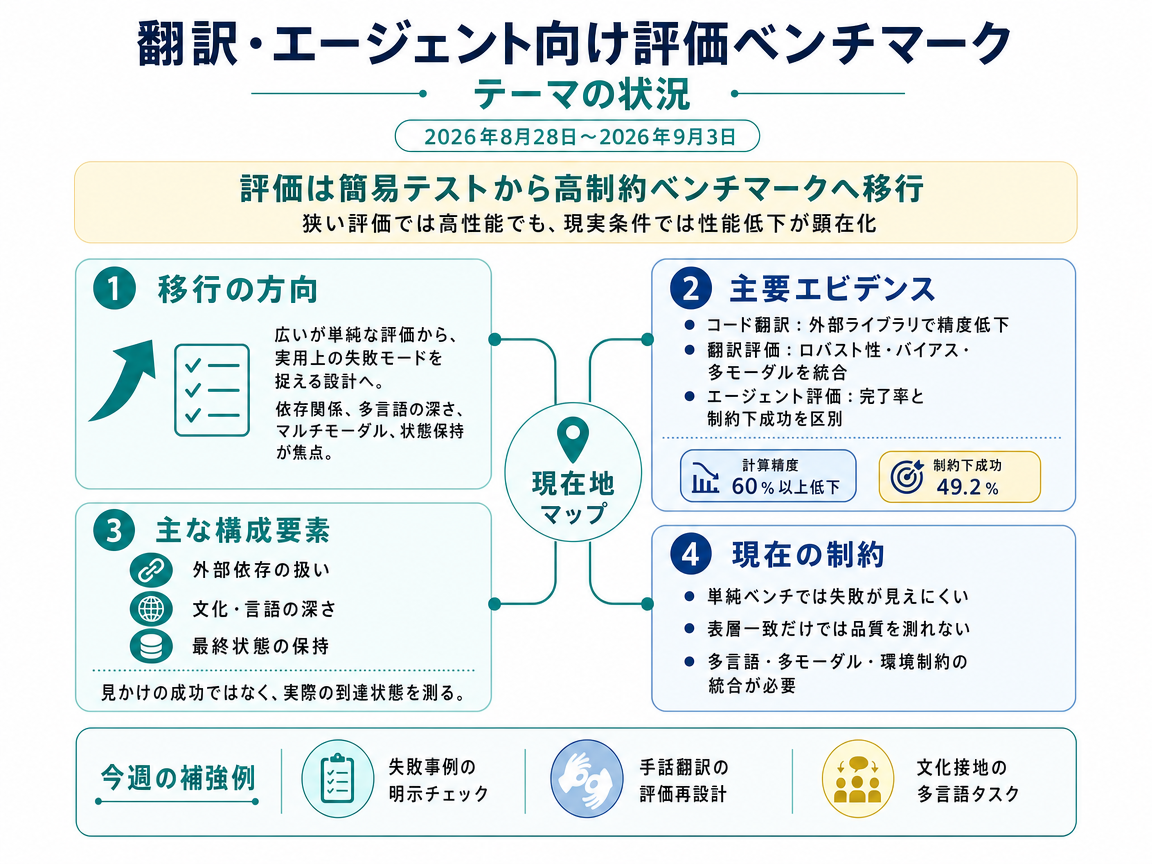
今週のテーマは、簡易的なテスト設定ではなく、より現実的で高制約のベンチマークへと評価が移行している点に焦点を当てている。代表的な論文は、現行システムが狭い評価では高性能に見えるものの、実際の依存関係、多言語の深さ、マルチモーダルなロバスト性、環境保持型のエージェント動作を反映したベンチマークでは著しく性能が低下することを示している。
テーマの状況
代表的なエビデンスは、広範だが簡略化された評価から、実用上の失敗モードを露呈するベンチマークへの移行を示している。TransLibEval(2509.12087v1)は、サードパーティライブラリが実際のソフトウェア開発で大きな比重を占めるにもかかわらず、ほとんどのコード翻訳ベンチマークではその表現が不十分であると主張し、特にAPI選択やクロス言語ライブラリマッピングにおいてLLMの性能が大幅に低下(計算精度で60%以上の低下)することを実証している。SeamlessM4T(2308.11596v1)は、テキストのみの翻訳スコアに頼るのではなく、ロバスト性テスト、バイアス測定、言語・モダリティ非依存の品質指標を組み込み、評価は本質的に多言語かつマルチモーダルであるべきだと位置づけている。
副次的なエビデンスも、より豊かなテストベッドとリソースへの同様の圧力を裏付けている。Targum(2602.09724v1)は、汎用的な学習規模ではなく、翻訳変異の計算的研究のための歴史的に深い翻訳カバレッジを優先している。今週のWorldBench(2609.01056v1)は、7言語・8文化にわたる文化的に根差した多言語エージェント評価を明示的に対象とし、見かけ上のタスク完了と正確な最終状態保持を区別するConstrained Task Success(CTS)を導入している。合格率とCTSの乖離(最強モデルでもCTSはわずか49.2%)は、現実的なベンチマーキングがヘッドラインの成功ではなく隠れた脆弱性の測定にますます注力していることを示している。
- A New Benchmark for Evaluating Code Translation with Third-Party Libraries
- Targum -- A Multilingual New Testament Translation Corpus
- WorldBench: Culturally Grounded Benchmark for Multilingual Agents
インフォグラフィクス(日本語)
今週の進展
Last Translation Benchmark <See Details on Fugu-MT>
このベンチマークは、主要な機械翻訳モデルが失敗する翻訳例を収集し、各ケースに手作業で作成された検証ルールを付与している。 広範な集約スコアリングと比較して、項目レベルのチェックを伴う明示的な失敗ケーステストへと翻訳評価を推進している。
Beyond BLEU: A Case for Redefining Sign Language Translation Benchmarks <See Details on Fugu-MT>
本論文は、手話翻訳の評価をBLEUの先へ進め、人間のランキングとより高い一致を示し、パラフレーズ不変性が6〜7倍高いオープンウェイトLLMによるQAプロトコルを提案している。 表層的な表現の違いへの感度を低減することで、現実的なカバレッジからより忠実な品質測定へとテーマを拡張している。
WorldBench: Culturally Grounded Benchmark for Multilingual Agents <See Details on Fugu-MT>
WorldBenchは、文化固有のアノテーターからの人間フィードバックで精緻化された7言語・1,600の文化的に根差したタスクをサンドボックス環境でLLMエージェントを評価する。 見かけ上のタスク完了だけでなく、多言語の接地された行動と状態保持をテストすることで、ベンチマークの現実性を拡大している。
今後の展望
今後の展望(要約)
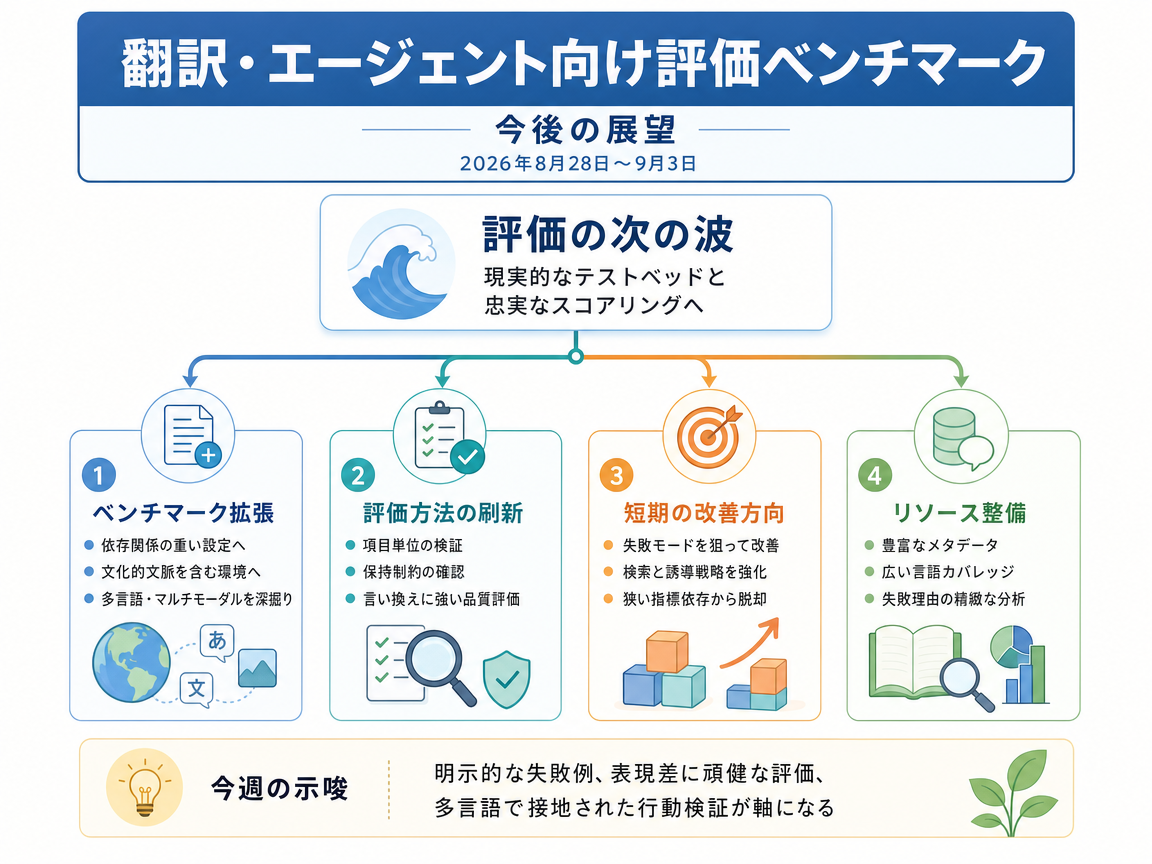
評価研究は、平均点だけに頼るのではなく、より難しく現実的なテスト環境と、隠れた失敗を明らかにする採点方法を組み合わせる方向に進むだろう。ベンチマークは、より多くのプログラミング言語の組み合わせや、文化的背景を反映したエージェント課題を扱うようになる。個々の結果に加え、意味や状態が保たれているか、言い換えに耐えられるかも調べられる。モデル改善では、検索機能や中間コード表現を強化し、ライブラリを含むコード変換など、テストで見つかった弱点に対応する。多言語・マルチモーダル研究は、支援の少ない言語、表現の質、ストリーミング条件へと広がる。さらに、データや課題に関するメタデータを充実させ、幅広い言語を対象にすることで、環境ごとに失敗する理由を説明しやすくなる。
インフォグラフィクス(日本語)
3年後を想定した動き
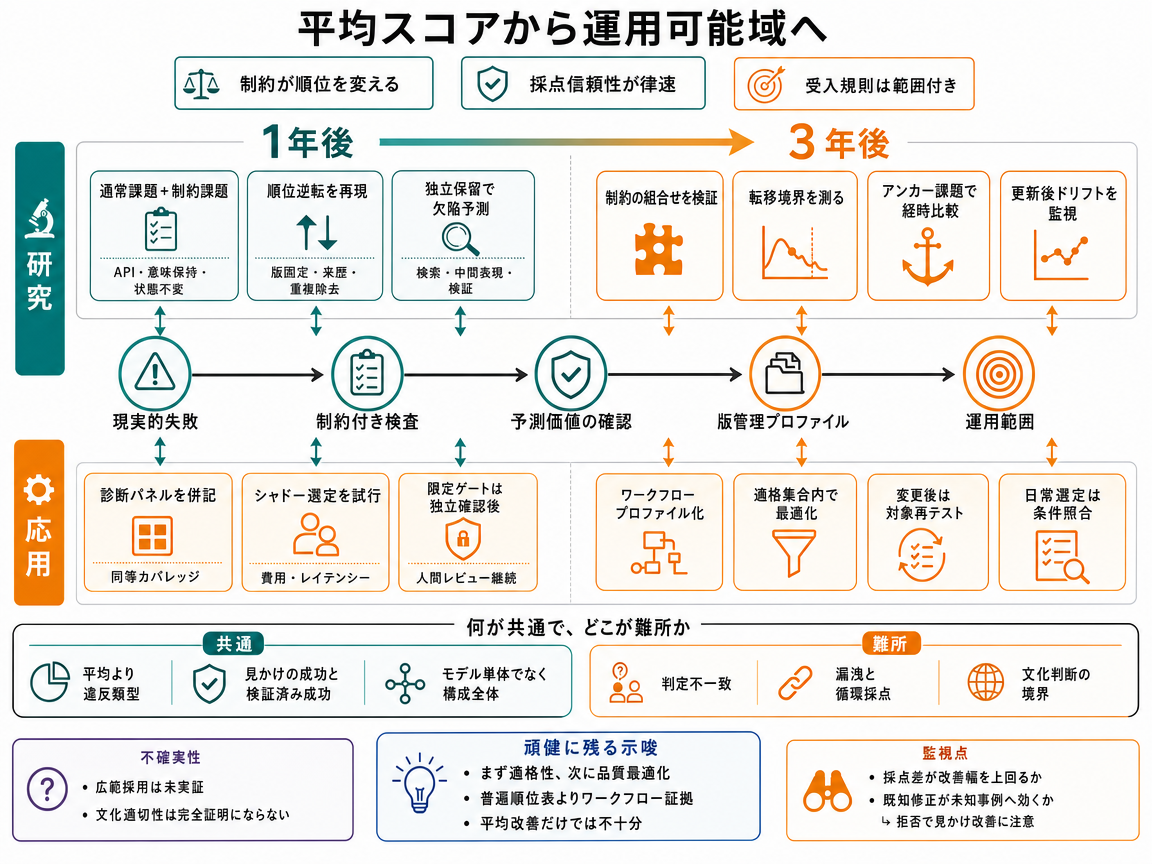
今後3年間で、現実的なベンチマークは、平均点によるモデル選定を、特定の業務要件を満たす証拠に基づく選定へ変える可能性がある。TransLibEvalでは、外部ライブラリの制約を加えると正解率が60%以上低下したと報告されており、通常のコード課題では隠れる失敗を調べる必要性が示されている。1年目には、通常課題と、その制約付きの課題を組み合わせる。制約付き課題では、ライブラリの正しい利用、意味の保持、無関係な記録の非変更などを確認する。チームは実際の業務を変えずに複数のモデルを比較し、同等の稼働条件において、制約付きテストが新しい課題での欠陥減少を予測できるかを調べる。
こうした確認が有効なら、2年目には個別のテストを再利用可能な業務プロファイルへまとめる。各プロファイルは必要条件と判定方法を明示する。研究者は、複数の制約が同時に働く場合でも個別テストの合格が成功につながるか、未知の環境にも結果が移せるかを検証する。この仕組みは、性能を高める前に、想定される障害の下で許容可能な動作を確認する電力網の安全検査に似ている。高い平均点によって重大な違反を埋め合わせない考え方である。報告された欠陥から新しいテストを作り、開発者は明らかになった弱点を修正し、独立した事例で効果を確かめる。
3年目には、特定のモデル構成が適切に動くと確認された条件を、版管理された「動作範囲」として文書化できるだろう。チーム間で構造化された証拠を共有し、更新の影響を受ける検査を再実行する一方、変更しない基準課題によって継続的な比較を可能にする。モデルは単一の総合順位ではなく、目的の業務に適することを示した証拠で選ばれ、条件が変われば再検査される。重要な観測指標は、独立した再現実験で順位が変わり、平均点が低くても関連する欠陥が少ないシステムが選ばれることである。判定者によって結果が大きく変わる場合や、難しい課題を避けるだけで成績が上がる場合、この道筋の可能性は弱まる。意味が曖昧な表現や文化に関わる言語課題では、テストは完全な証明ではなく更新可能な証拠にすぎないため、人による確認が引き続き重要になる。
今後3年間で課題が現実的になるほど、課題作成よりも信頼できる採点のほうが、有用な評価と安定したシステム比較を妨げる主要因になる可能性がある。TransLibEvalで報告された、ライブラリ制約下での60%を超える正解率低下は、詳しい検査の必要性を支える。ただし、現在の証拠だけでは、採点能力の不足が広く発生しているとはまだ言えない。1年目には、チームが難しいベンチマークを拡張し、異なる評価環境で独立に実装した検査を使って結果の再現を試みる。オラクルとは、要件を満たしたかどうかを決める規則または実行可能な検査であり、実装の違いによって同じ項目の点数が変わることがある。モデルの改善幅より採点者間の不一致が大きくなり、再実行可能な証拠と採点版の開示が求められるかが重要な観測指標になる。
問題が明確になれば、2年目には、独立したチームが同じ固定事例を採点して判断を比較する技能試験を導入できる。これは検査機関の品質管理を参考にした仕組みであり、小さな性能差をモデル選定や公開判断に使う前に、不一致の場所を特定して採点を調整する。事例の記録には、出所や改訂履歴に加え、学習時に見られた可能性を残す。これにより、信頼できる測定と、既知または変更済みのテスト材料に左右された結果を区別しやすくなる。ライブラリ動作やエージェント状態では実行可能な検査が早く進歩する一方、言語評価では意味や文化的な適合性について人の判断が必要となる。
3年目には、共有された調整方法が日常的な品質管理を支え、版管理された検査が公開工程と結び付く可能性がある。依存要素や判定方法が変わるたびに検査を繰り返し、対象を絞った改善が新しい事例でも維持されるかを確認する。専門の評価機関は基準事例を管理し、複数組織の間で争いのある結果を調査できる。この結果得られるのは万能な品質点ではなく、報告された改善幅に見合う一致を備えた限定的な測定基盤である。大きな注意点は循環的な評価であり、似た自動システムが課題の生成と採点を行うと、見かけほど独立した一致ではない可能性がある。独立した実装でも順位が安定し、採点差がモデルの改善幅より一貫して小さければ、信頼できない判定が最大の制約になるという見通しは弱まる。
今後3年間で、診断型評価は、記録された問題事例を使って特定の言語業務を更新できるか判断する、継続的な供給品質サービスへ発展する可能性がある。この仕組みは、荷物が届いた事実だけでなく、中身が正しいかを確かめることに似ている。出力が流暢でも、保護すべき事実や記録が変わらず残ったとは限らない。1年目には、日付の変更、数量の誤り、許可されていない記録変更など、繰り返し起きる問題を再構成し、独立した確認に十分な証拠を保存する。二言語を扱える確認者は明確な失敗と許容できる言い換えを区別する。試行チームは、受け入れ判断をすぐには変えず、過去の問題が新しい欠陥を予測できるかを調べる。繰り返す更新で確認済みの欠陥を発見し、再作業や争いへの対応を減らした効果が、検査と異議対応の負担を上回ることが進展の条件となる。
この基準を満たせば、2年目には実験用の一連のテストを実務サービスに変えられる。提供者との合意では、保存する証拠と、結果に異議を申し立てる方法を定める。研究者は、壊れた結果を見つけただけでは責任のある構成要素や関係者を特定できないため、失敗の発生源を調査する。問題事例は提供者の改善を導くテストとなり、独立に確認された新しい事例によって、既知のテスト以外でも再発が減るかを確かめる。利用者固有の検査は共通の証拠形式を使えるが、意味の保持とエージェント状態の正しさを同じ方法で判定できるとは限らない。
3年目には、持ち運び可能な証拠パッケージにより、利用者が自らの失敗履歴を使って代替提供者を評価し、確立したテストを別の提供者へ移せるようになる。管理サービスは、明示された言語業務の組み合わせについて更新を承認し、研究側は、その手続きが他の利用者や一部の音声課題にも適用できるかを調べるだろう。これは一般的な認証ではなく、対象を限定した公開許可であり、導入後の新しい問題が減ったことを独立した標本調査で示す必要がある。再現可能な問題記録や、提供者が自発的に提出する再実行の証拠が重要な観測指標になる。新しい欠陥の発生率が変わらない場合や、異議対応の費用が増える場合には、この道筋の可能性は弱まる。意味が曖昧な事例や再現できない環境では人による確認が残り、問題事例中心の検査が文化的な適合性や表現の質を見落としていないかも調べる必要がある。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- A New Benchmark for Evaluating Code Translation with Third-Party Libraries - 著者: Pengyu Xue, Kunwu Zheng, Zhen Yang, Yifei Pei, Linhao Wu, Jiahui Dong, Xiapu Luo, Yan Xiao, Fei Liu, Yuxuan Zhang, Xiran Lyu, Xianhang Li, Xuanyu Zhu, Chengyi Wang, / <See Details on Fugu-MT> / ライセンス: CC0-1.0
- Targum -- A Multilingual New Testament Translation Corpus - 著者: Maciej Rapacz, Aleksander Smywiński-Pohl, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- WorldBench: Culturally Grounded Benchmark for Multilingual Agents - 著者: Leonardo Ranaldi, Sherrie Shen, Jushi Kai, Alexandra Birch / <See Details on Fugu-MT> / ライセンス: CC BY 4.0