サマリー
今週のテーマは、単一のシステムで画像の理解・生成・編集を行うマルチモーダルモデルにおいて、視覚情報をどのように表現すべきかに焦点を当てている。代表的な論文群は、分断されたアーキテクチャ、非効率または意味的に弱い視覚トークン化、および細粒度の視覚知覚における根強いギャップを主要なボトルネックとして提示しており、最新の研究ではネイティブ解像度エンコーディングやトークナイザ設計を、孤立した評価ではなく統合的な自己回帰訓練の内部で検討する方向に進んでいる。
テーマの状況
代表的な論文群は、つぎはぎのパイプラインからネイティブに統合されたマルチモーダルモデルへと移行しつつある分野を描いている。Skywork UniPicは、理解・生成・編集の個別スタックがクロスモーダルなシナジーと実用的なデプロイを制限すると主張し、LLaVA-UHD v3はスライスベースの処理よりもグローバルなネイティブ解像度エンコーディングを動機づけている。これは、クロップ単位の手法が計算量を削減しつつもグローバルなコンテキストを失うためである。これらの導入部を合わせると、表現学習が中心的なシステム課題として提示されている。すなわち、モデルには意味論・ディテール・クロスモーダルアライメントを過大なコストなく保持する視覚エンコーディングが必要である。
二つ目の繰り返し現れる懸念は、現在のマルチモーダルシステムがその表現が実際に何を捉えているかという点でなお苦戦していることである。Euclidは幾何学や空間的ディテールにおける低レベル視覚知覚の失敗を強調し、精密な視覚理解にはより良い合成記述とカリキュラムベースの訓練が必要だと主張している。今週の「Studying Image Tokenizers as Visual Languages in Unified Multimodal Models」(arXiv:2609.09143v1)の証拠はこの指摘をさらに鮮明にし、再構成品質だけではマルチモーダル学習可能性と乖離しうること、また画像トークナイザはテキスト・画像の統合自己回帰訓練内で評価されるべきであることを示している。トークナイザの選択はクロスモーダルアライメントやテキストモデリングにさえ影響を与えるためである。
- Euclid: Supercharging Multimodal LLMs with Synthetic High-Fidelity Visual Descriptions
- Skywork UniPic: Unified Autoregressive Modeling for Visual Understanding and Generation
- LLaVA-UHD v3: Progressive Visual Compression for Efficient Native-Resolution Encoding in MLLMs
- Studying Image Tokenizers as Visual Languages in Unified Multimodal Models
インフォグラフィクス(日本語)
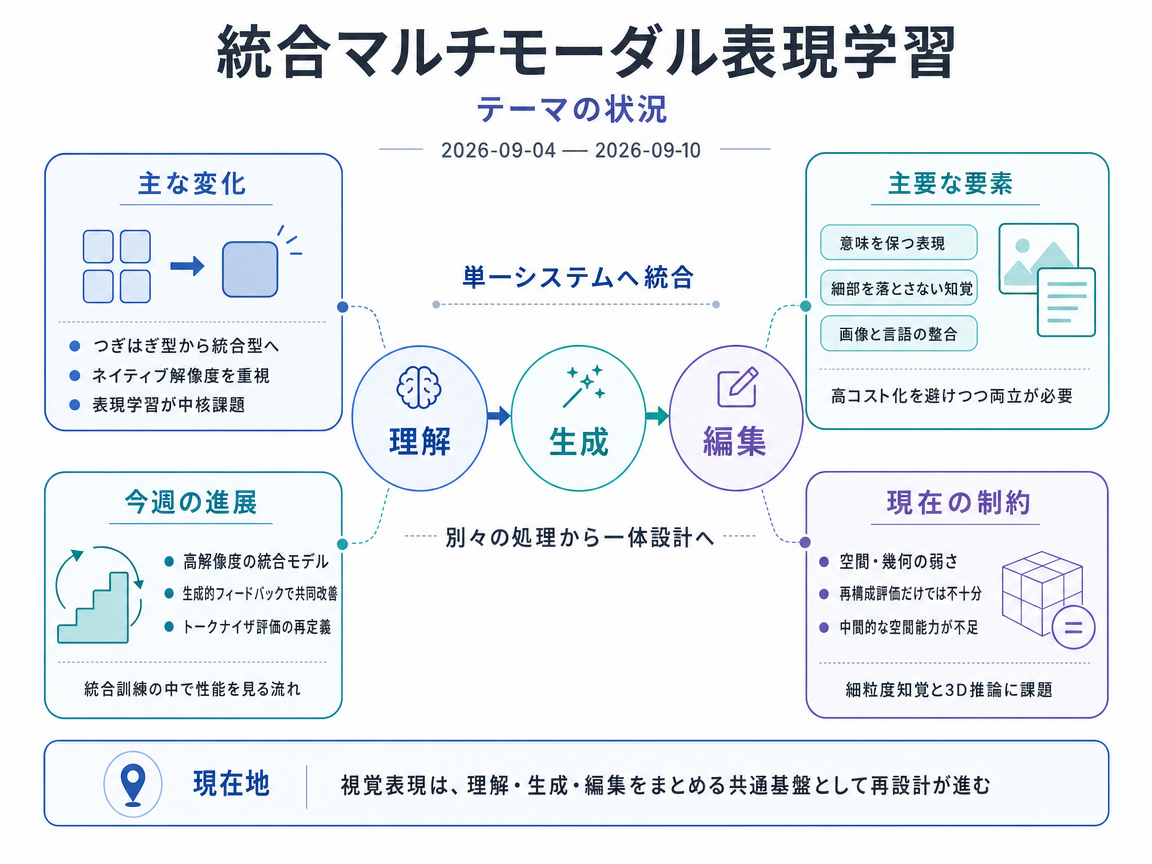
今週の進展
SenseNova-U1.5: Towards Native Unified Visual Intelligence <See Details on Fugu-MT>
SenseNova-U1.5は、最大4Kのネイティブ解像度で視覚コンテンツの理解・推論・生成を行う統合8B-MoTモデルを実証した。 従来の分断されたパイプラインやクロップベースのエンコーディングと比較し、ネイティブ高解像度訓練と、教師あり微調整・強化学習・オンライン蒸留を網羅する公開レシピを提供している。
Dreaming in Flow: Generative Grounding Feedback for Self-Evolving Unified Multimodal Models <See Details on Fugu-MT>
Dreaming in Flowは、生成的グラウンディングフィードバックを通じて視覚理解と生成を結合する自己進化型ポストトレーニングフレームワークを導入した。 二つの能力を別々のタスクとして最適化するのではなく、モデル自身の視覚出力とテキストプロンプトを用いて統合ネットワークを共同で改善する。
Studying Image Tokenizers as Visual Languages in Unified Multimodal Models <See Details on Fugu-MT>
本論文は、統合自己回帰マルチモーダル訓練内で画像トークナイザを評価し、学習可能性の尺度としてタスク固有の検証損失を追跡した。 トークナイザの評価を単独の再構成指標から、視覚トークン設計がテキスト・画像の統合学習と下流性能にどう影響するかという観点へと転換している。
MV-STRIDE: Enabling MLLMs to Master Multi-View Spatial Reasoning via Hierarchical Capability Modeling <See Details on Fugu-MT>
MV-STRIDEは、知覚からシーン理解、文脈的推論に至る依存関係を明示的にモデル化する階層的マルチビュー空間推論データセットを提供した。 より平坦なベンチマークと比較して、統合MLLMが複雑な3D推論において依然として欠いている中間的な空間能力を明らかにしている。
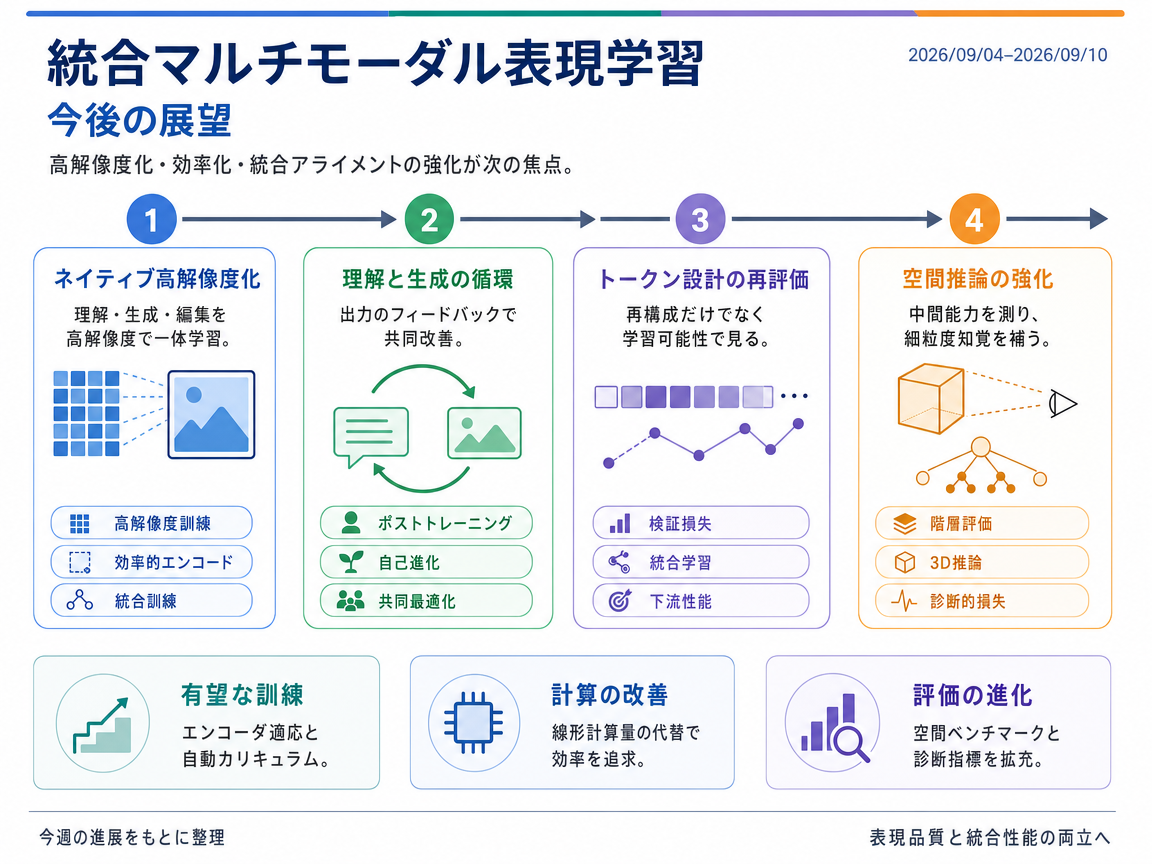
今後の展望
今後の展望(要約)
短期的には、統合型マルチモーダルモデルが高解像度画像を直接扱いながら、計算量を抑え、理解・生成・編集を一体的に行う方向へ進む可能性が高い。ただし、複雑な指示への対応、正確な編集、基本的な空間認識には課題が残り、画像の符号化にも大きな計算コストがかかる。今週の研究は、事後学習で理解と生成の間により密接なフィードバックを設ける重要性を示した。また、画像トークナイザーは再構成画像の見た目だけでなく、その表現がモデル全体の学習にどれだけ役立つかで評価すべきだと示唆している。エンコーダーの適応方法や学習カリキュラムを改善するには、より厳密な空間認識テストと診断用の損失関数を使い、どの変更がモデル全体を実際に改善したのかを確認する必要がある。
インフォグラフィクス(日本語)
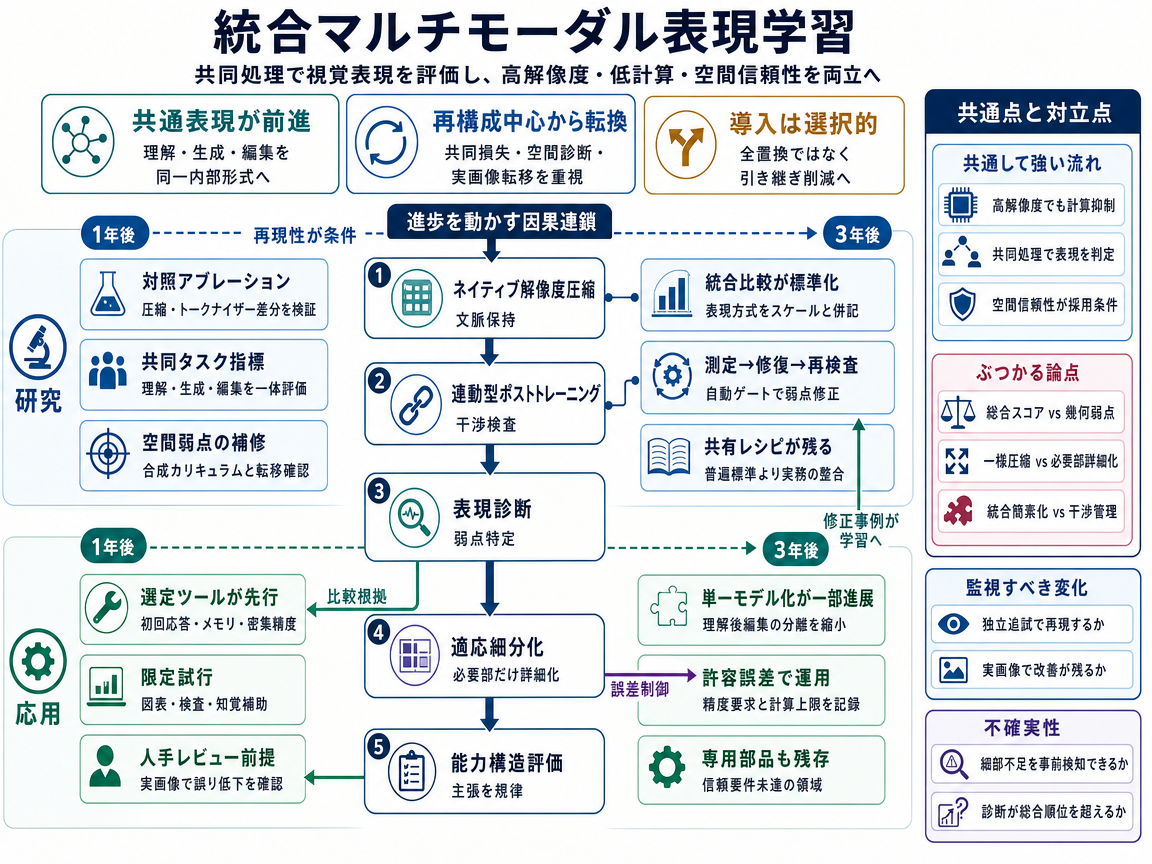
3年後を想定した動き
今後は、高解像度画像の理解・生成・編集を共通表現で行いながら、計算量を減らすモデルが中心になると考えられる。これまでの研究も、より小型の統合設計と低コストな画像符号化の可能性を支えている。一方、基本的な幾何認識の失敗は、ベンチマークの平均点だけでは必要な細部が保たれているか判断できないことを示す。そのため、総合得点だけでなく、課題ごとに必要な視覚情報を保持できるかを調べる必要がある。
今週報告された高解像度向けの学習法は、この方向をさらに後押ししている。理解と生成の間でフィードバックを強める方法も、両方の能力を一緒に改善する可能性を示した。トークナイザー研究からは、符号化された画像単位をモデル全体の学習への貢献度で評価するという仕組みも見えてきた。画像をきれいに再構成できるかだけでは、学習に有効な表現かどうかを十分に測れない。
重要な観測点は、効率の向上と同時に基本的な空間認識も強くなるかどうかである。総合得点だけが上がり、位置関係や形状の理解が改善しない場合、進歩は限定的である。これらは有望な研究上の兆候だが、確立された3年間の発展経路ではない。今週の主張には、完全な実験結果ではなく編集上の説明に基づくものもあるため、今後の再現検証が必要である。
このシナリオでは、高解像度を扱う統合型モデルが適応的な画像処理へ進む。画像をモデルが扱える単位に変換した視覚トークンを、課題が細部を必要とする領域だけで細かくする。これは数値シミュレーションの適応的メッシュ細分化に似ており、粗い表現では不十分な場所へ計算を集中させる仕組みである。現在の報告はこの方向を支持するが、追加の視覚情報が必要な場所と時点を確実に決める制御機構はまだ実証されていない。
1年目には、圧縮後の画像が自然に見えても、回答や編集に必要な細部が失われていないかを検証する。試作モデルは画像全体の表現を保ちつつ、選んだ領域からより細かなトークンを取得する。これにより、領域を個別に切り出す方法で失われやすい位置関係も保持しやすくなる。細部を取得する場所は、見た目の目立ちやすさだけでなく、課題の指示に応じて決めるようになる。重要な観測点は、制御に必要な追加処理も含めた同じ総計算量で、異なるモデル構成でも外部評価の誤りが減るかどうかである。
2年目には、有望な試作モデルを未知の配置や複数視点の場面で試す。これは、モデルが知識不足と視覚情報の不足を区別できるかを調べる試験になる。有望な応用では、人が責任を持ったまま、モデルの提案と実際の結果を記録して比較する試験運用が始まる可能性がある。人による修正は、誤りの場所を特定し、不要な細分化を避けるための学習例として利用できる。その結果、難しい事例へより多くの計算を振り向けられるようになる。
3年目まで成功が続けば、要求した精度や未解決の誤りを記録する共通の細分化インターフェースが整備される可能性がある。文書処理や検査の一部では、固定解像度ではなく必要な許容誤差を指定し、必要時に細部を取得できる小型モデルが有利になり得る。ただし、小さな特徴を検出できない場合や、追加処理を含めると固定解像度方式と差がない場合、この経路の可能性は弱まるため、独立した確認と人への引き継ぎが欠かせない。
このシナリオでは、統合型マルチモーダルモデルの進歩を、最終的なベンチマーク得点だけで評価しなくなる。代わりに、信頼できる知覚を生み出す各段階の測定を重視する。画像をモデルが読める単位へ変換するトークナイザーは、見た目の保存度だけでなく、出力が学習をどれだけ支えるかで評価される。空間認識テストでは、基本的な知覚と複雑な推論を分けて調べ、総合成績に隠れた弱点を明らかにする。
1年目には、圧縮方法と学習段階を比較し、重要な空間能力がどこで生まれ、どこで失われるかを調べる。大きな転換には、知覚不足が原因と確認された試験運用上の失敗と、小型モデルが空間認識テストで上位システムを上回る検証結果が必要になる。共通評価では、生成や編集の結果を採点する前に、最低限の知覚得点を求める可能性がある。ただし、その基準は対象課題の性能を実際に予測できる場合に限って有効である。
2年目には、診断手法が自動化された学習検査となり、失敗の原因となった段階を特定できるようになる。測定・修正・再試験の循環により、単一の総合得点を繰り返し最適化するよりも、狙いを定めた改善が行いやすくなる。また、実際の運用条件の下でシステム同士を比較しやすくなる。一方、合成データによる学習は、実際の場面を改善せず、既知の幾何問題への回答だけを良くするおそれがある。このため、定期的に入れ替えるテストと、外部が管理する未公開課題が必要になる。
3年目までには、共通手順と独立管理のテストにより、診断サービスや一貫した公開報告が可能になる。検査や技術文書を扱う業務では、検証済みの知覚基準が日常的に求められる一方、一般的な創作ツールでは出力品質が引き続き重視されるだろう。既存の複数構成システムも、構成要素間の接続を有効に検査できるなら利用価値を保ち、統合型への置き換えが自動的に正当化されるわけではない。実運用が診断証拠を求め、その結果によるモデル順位の変化を受け入れるかが重要な観測点であり、予測力が増さなければ診断は研究用の道具にとどまる可能性がある。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- Euclid: Supercharging Multimodal LLMs with Synthetic High-Fidelity Visual Descriptions - 著者: Jiarui Zhang, Ollie Liu, Tianyu Yu, Jinyi Hu, Willie Neiswanger, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Skywork UniPic: Unified Autoregressive Modeling for Visual Understanding and Generation - 著者: Peiyu Wang, Yi Peng, Yimeng Gan, Liang Hu, Tianyidan Xie, Xiaokun Wang, Yichen Wei, Chuanxin Tang, Bo Zhu, Changshi Li, Hongyang Wei, Eric Li, Xuchen Song, Yang Liu, Yahui Zhou, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- LLaVA-UHD v3: Progressive Visual Compression for Efficient Native-Resolution Encoding in MLLMs - 著者: Shichu Sun, Yichen Zhang, Haolin Song, Zonghao Guo, Chi Chen, Yidan Zhang, Yuan Yao, Zhiyuan Liu, Maosong Sun, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Studying Image Tokenizers as Visual Languages in Unified Multimodal Models - 著者: Siting Li, Zhengyang Wang, Simon Shaolei Du, Xi Chen, Yang Liu / <See Details on Fugu-MT> / ライセンス: CC BY 4.0