サマリー
本テーマは、クリーンな単一話者条件を超えて動作する音声認識システムを扱い、騒音環境・遮音環境、話者重複、チャネル不一致への対応を対象とする。代表的な研究は、分離・クロスモーダル転移・ドメイン適応型合成を通じた、強力な事前学習済みモデルやストリーミングアーキテクチャのモジュール式適応を重視している。今週の進展として、数十言語対応かつストリーミング対応のLLMベースASR、エンドツーエンドのターゲット話者書き起こし、低遅延デプロイのためのエンコーダ圧縮が報告された。
テーマの状況
代表的な論文群は共通の課題を提示している。標準的な条件下での高いASR性能は、実環境の条件にはそのまま移行できないという問題である。Radio2Textは、騒音環境や遮音環境におけるミリ波反射からの低遅延・大語彙書き起こしへの音声認識の拡張を主張するが、低品質な電波信号やストリーミング復号における未来コンテキストの欠如に対処する必要がある。Sidecar Separatorは話者重複をモデル適応問題として扱い、固定された単一話者ASRを完全に再設計するのではなく、軽量な分離器で拡張できることを示した。CADA-GANは録音チャネル不一致に起因する頑健性ギャップを対象とし、ドメイン適応型合成を用いてマイク間のASR脆弱性を低減する。
これらの基盤的知見を総合すると、モジュール式でスケーラブルな頑健性の方向性が示される。すなわち、モダリティ間での知識転移、軽量適応コンポーネントの挿入、ターゲットに類似したデータの合成により、強力なベース認識器を維持しつつ動作条件を拡大するアプローチである。今週の研究として、X-AuT(2609.11412v1)はデプロイの観点を追加し、音声LLMがストリーミング・モバイル・車載環境において初回トークン遅延やエンコーダコストの制約に直面していることを指摘し、事前学習済み音声エンコーダの圧縮と性能回復が精度とともにASRシステムの重要な課題であると主張している。
- A Sidecar Separator Can Convert a Single-Speaker Speech Recognition System to a Multi-Speaker One
- Radio2Text: Streaming Speech Recognition Using mmWave Radio Signals
- Channel-Aware Domain-Adaptive Generative Adversarial Network for Robust Speech Recognition
- Qwen-Audio-3.0-ASR Technical Report
- Xiaomi-CocktailASR-1 Technical Report
- X-AuT: Progressive Audio-Encoder Compression for Speech LLMs with Cross-Scale Distillation
インフォグラフィクス(日本語)
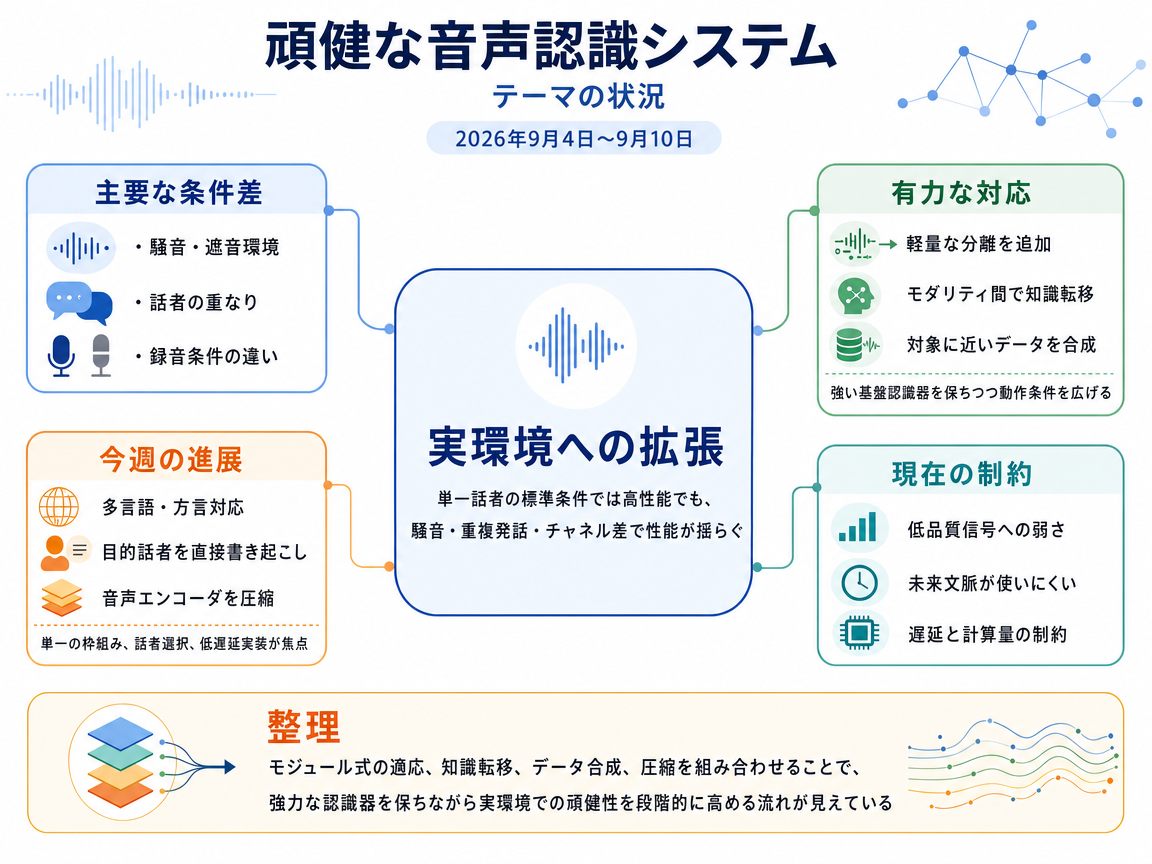
今週の進展
Qwen-Audio-3.0-ASR Technical Report <See Details on Fugu-MT>
Qwen-Audio-3.0-ASRは、30言語と16の中国語方言に対応するMixture-of-ExpertsベースのLLM型ASRシステムを提示し、低遅延アプリケーション向けの専用ストリーミングモードを備える。 従来のモジュール式頑健化戦略と比較して、多言語対応・文脈エンティティ認識・ワンパスの非流暢性修正を、ストリーミングモード付きの単一の命令制御フレームワーク内に統合している。
Xiaomi-CocktailASR-1 Technical Report <See Details on Fugu-MT>
Xiaomi-CocktailASR-1は、参照音声プロンプトを用いて明示的な音声分離なしに目的話者を直接書き起こす、エンドツーエンドのターゲット話者ASRシステムを提案する。 従来の分離器ベースの適応と比較して、ターゲット話者が不在の場合の棄却機能を追加し、解釈可能性のためのChain-of-Thought推論をサポートしている。
X-AuT: Progressive Audio-Encoder Compression for Speech LLMs with Cross-Scale Distillation <See Details on Fugu-MT>
X-AuTは、段階的なレイヤー刈り込みとクロススケール蒸留により事前学習済み音声LLMの音声エンコーダを圧縮し、エンコーダの深さを最大22%削減しつつ競争力のある精度を維持する。 従来の音響条件適応に関する研究と比較して、エンコーダ効率と初回トークン遅延を、ストリーミングおよびオンデバイスデプロイのための頑健ASRシステム設計の具体的な要素として位置づけている。
今後の展望
今後の展望(要約)
短期的には、音声認識システムを一から作り直すのではなく、実績のある認識器を拡張することで頑健性が向上すると考えられる。優先課題は、ラベルなし録音も利用した大規模なミリ波音声データセットの整備、通信路に適応する音声合成の幅広い検証、既存モデルに追加できる軽量機能の開発である。こうした研究は、指定話者を認識し、多言語のストリーミング処理に対応する実用システムへ収束しつつある。エンコーダーの圧縮では、応答の遅延を小さく保つことが重要な制約になる。次の段階では、話者の重なりやマイク条件の変化が同時に起きても、処理速度と移植性を維持できるかを検証する必要がある。
インフォグラフィクス(日本語)
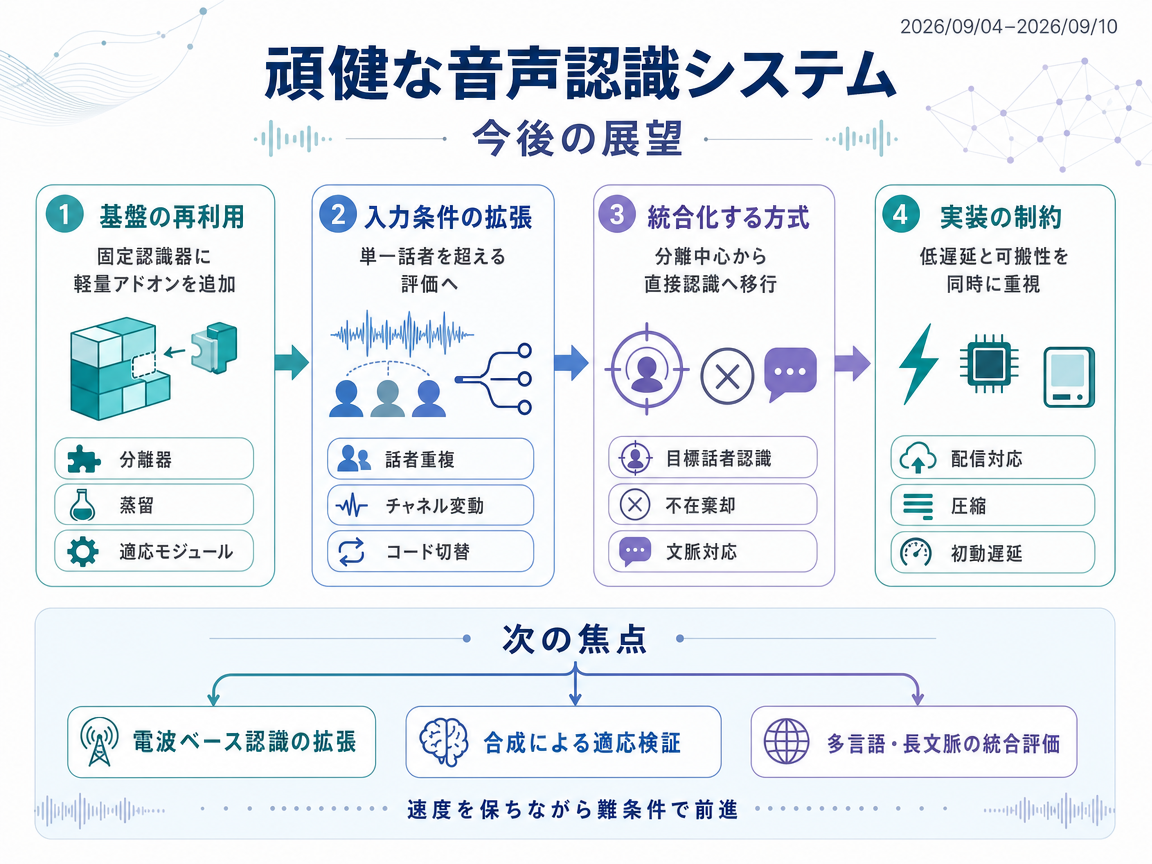
3年後を想定した動き
今後3年間、このシナリオでは、動作条件が難しくなるたびにシステム全体を作り直すのではなく、再利用可能な追加機能によって実績ある音声認識器を拡張する。これは、強い土台を残したまま専用の枝を接ぐ果樹の接ぎ木に似た仕組みである。ただし現時点では、複数の追加機能を組み合わせても安定して動くことまでは示されていない。
1年目には、実際の会議で指定された話者の声を分離する方法を比較し、その話者が不在の場合も調べる。マイク特性に合わせた学習用音声を高性能な認識器で試し、効果が別のモデルでも続くかを確認する。圧縮については、認識誤りと最初の文字が表示されるまでの遅延を使って評価する。
これらの試験が成功すれば、2年目には個別機能の実証から、ストリーミング制約の下で複数機能を併用する検証へ進む。研究者は機能を一つずつ外し、それぞれが結果にどの程度寄与するかを調べる。応用チームは、一つの操作画面から状況に応じて内部の処理経路を選べるようにする。短いマイク録音の取得や参照音声の任意登録を標準的な設定手順にすれば、有効な構成を別の作業環境へ移しやすくなる。共通の部品接続方式と明確な試験条件も、再利用と比較を容易にし、その結果を次の導入へ反映する循環を強める。
3年目の中心課題は、基盤モデルの更新後も機能の組み合わせを維持し、言語や音響条件が変わる長時間の処理に対応することである。会議で実証された構成は一部の車内用途にも広げられ、認識精度に加えて応答時間と話者選択の誤りが受け入れ条件になる。重要な観測指標は、全面的な再学習や応答の低速化なしに、複合条件の試験結果が繰り返し改善することである。圧縮によって追加機能に必要な情報が失われる場合や、同等の能力を持つ統合モデルが登場した場合、この方向の優位性は弱まる。ミリ波音声認識は別の研究分野として進み、大規模データによる実験は増えるが、実用化には検知性能とプライバシー保護の確認が必要である。
今後3年間、このシナリオではストリーミング音声認識器の上に監督機構を置き、出力を受け入れるか、回復処理を行うかを判断する。ロボット分野の実行時保証を応用し、監督機構が想定された動作範囲を監視する。範囲を外れた場合は、文字を確定するか、別の処理経路を試すか、発話の繰り返しを求める。
1年目の焦点は、話者の重なりと未知のマイク条件が同時に起きても、文字の確定前に誤りの可能性を見つけられるかである。同意を得た会議での試験では、最初は介入案だけを記録し、実際の文字列は変更しない。その後、未使用の録音による試験で利点が確認された場合に限り、限定的な介入を認める。評価では、保持する音声の割合と計算量をそろえて代替システムを比較し、95%の処理が完了する時間であるp95遅延も確認する。
2年目には、成功した試作から、未確定の文字と確定済みの文字を区別できる共通インターフェースを作る。回復処理の途中でも、話者の識別情報を保つ必要がある。応用チームは段階的な公開と以前の版へ戻す手順を整え、研究者は基盤の認識器が変わっても監督機構が信頼できるかを調べる。同意の下で得た介入記録を評価に使えば、繰り返される失敗が修正課題を示し、監視精度の向上が不要な中断を減らす循環が生まれる。難しい音声を捨てただけで性能が上がったように見えないよう、拒否された音声も監査用サンプルに残す。
3年目には、複数拠点で長時間かつ複合的な困難を含む試験を行い、基盤モデルの交換後も既定の動作範囲が有効かを評価する。成功すれば、会議拠点や一部の車内用途へ広げられ、認識部品が変わっても文字列の受け入れ規則は独立して検証される。重要な観測指標は、音声の保持率を下げず、遅い応答の待ち時間も悪化させずに、話者の取り違えが減ることである。監視機構の信頼性が失われる場合や、利用者が確認要求を無効にする場合、この方法は弱まる。また、監督機構と認識器が同じ弱点を持つ可能性があるため、その有効性は実験で継続的に確かめる必要がある。
今後3年間、このシナリオでは、会議室設備の保守作業を、正常に動く機器をすぐ交換せずに文字起こし品質を検査し、修復する機会として利用する。中心となる仕組みは、特定の機器とソフトウェアの組み合わせが明示された条件で試験に合格し、後の変更時には再試験するという反復可能な認定手順である。
1年目には、同意を得た現場試験で、ソフトウェアによる適応と既存認識器の継続利用を比較し、必要に応じて機器修理とも比べる。最初は修正案を実際のサービスから切り離して評価する。認識品質は人による修正作業とストリーミング遅延に関連付け、適応に使っていない録音でも改善が続くかを確認する。有料の追加サービスとして成立するには、顧客が求める品質を守りながら、支援作業と文字修正を合わせた負担を減らす必要がある。さらに、未知の機器変更が起きた別の拠点でも成功を再現しなければならない。
2年目には、成功した修復方法を文書化し、版管理された設定と顧客管理の試験録音によって、更新後も以前の結果を確認できるようにする。研究者は将来の問題を予測できる短い導入試験を探し、マイクや部屋の特徴を再利用可能な通信路プロファイルとして記述する。ただし、新しい拠点ではそのプロファイルを改めて検証する必要がある。公共設備の保守に似た循環により、入力条件の変化が点検を促し、完了した修復の証拠が次の故障診断と対応を改善する。作業事業者は限定的な品質保証と回復対応を提供できるが、録音や知見を拠点間で共有できるかは顧客の許可に左右される。
3年目には、どの部屋でも完全に認識できると主張するのではなく、多数の部屋で実証済みの品質を維持する手間の削減に重点を置く。自動変更検知によって再確認が必要な構成を示し、機器やモデルの更新ごとに全面評価と限定的な再試験のどちらが必要かを研究で明らかにする。重要な観測指標は、更新時の受け入れ試験を続けながら、拠点ごとの認定時間が短くなることである。通常のマイク交換の方が安く問題を解決できる場合や、未知の部屋で改善が消える場合、この方向の価値は弱まる。そのため、品質上の約束は試験済みの条件と明確に定めた回復対応の範囲に限られる。
1年後・3年後の研究/応用インフォグラフィクス
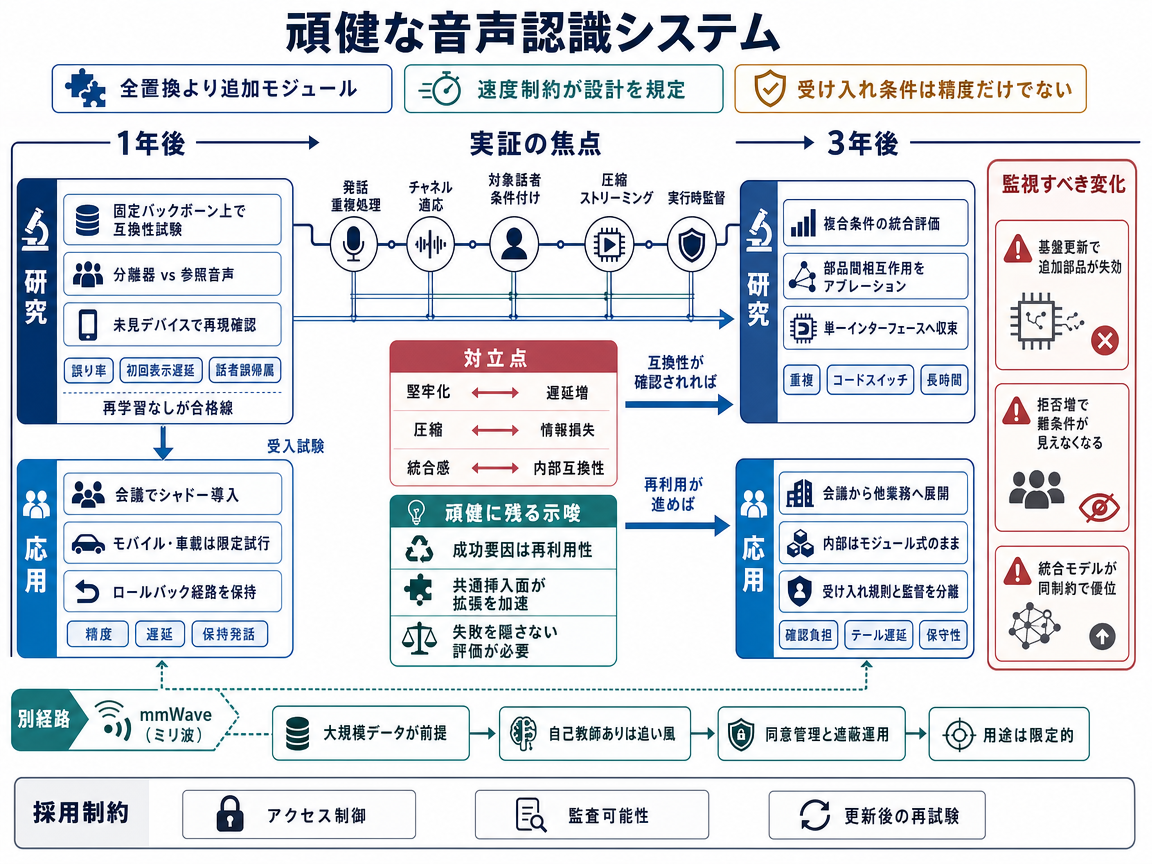
参照論文
- A Sidecar Separator Can Convert a Single-Speaker Speech Recognition System to a Multi-Speaker One - 著者: Lingwei Meng, Jiawen Kang, Mingyu Cui, Yuejiao Wang, Xixin Wu, Helen Meng / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Radio2Text: Streaming Speech Recognition Using mmWave Radio Signals - 著者: Running Zhao, Jiangtao Yu, Hang Zhao and Edith C.H. Ngai / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Channel-Aware Domain-Adaptive Generative Adversarial Network for Robust Speech Recognition - 著者: Chien-Chun Wang, Li-Wei Chen, Cheng-Kang Chou, Hung-Shin Lee, Berlin Chen, Hsin-Min Wang, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Qwen-Audio-3.0-ASR Technical Report - 著者: Chuanmeng Bian, Daren Chen, Peixin Chen, Zhigao Chen, Zhiyun Fan, Zhifu Gao, Bo Gong, Qing Gu, Jiajun He, Yawei Hu, Yunjie Ji, Jingbei Li, Xiangang Li, Xu Li, Zengxi Li, Zheng Li, Chengdong Liang, Baiji Liu, Ying Liu, Bin Ma, Yiping Peng, Yuezhang Peng, Zhendong Peng, Yu Pu, Yang Shi, Xin Shu, Jian Tang, Biao Tian, Peiyao Wang, Tianzi Wang, Wen Wang, Wupeng Wang, Cheng Wen, Yuzhong Wu, Zijian Xia, Yunchong Xiao, Nan Yang, Jianwei Yu, Jixing Yu, Binbin Zhang, Lei Zhang, Sitong Zhao, Guangdong Zhou, Yuan Zhou, Jianheng Zhuo / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- Xiaomi-CocktailASR-1 Technical Report - 著者: Yiru Zhang, Hang Su, Lichun Fan, Ying Zeng, Chang Liu, Yifeng Wang, Yuquan Liang, Tao Li, Lian Li, Wenhao Yang, Jian Luan, Cong Zou, Heng Qu / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- X-AuT: Progressive Audio-Encoder Compression for Speech LLMs with Cross-Scale Distillation - 著者: Haojun Zhang, Yi Zou, Min Chen, Qize Yu, Lianrui Fan, Xini Ding, Hao Li, Shuchang Zhou, Xianming Liu, Shiyu Huang / <See Details on Fugu-MT> / ライセンス: CC BY 4.0