サマリー
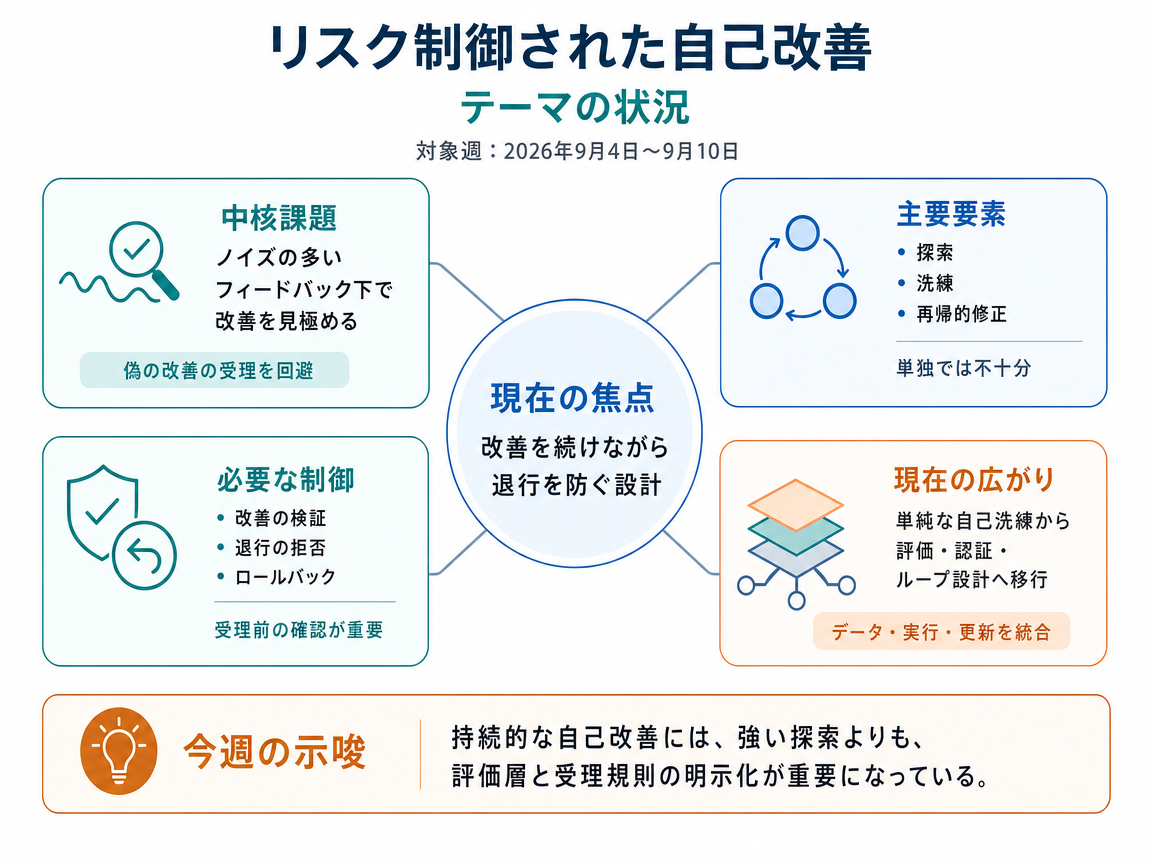
本テーマは、学習システムが自身を改善したり推論を修正したりする際に、有害な変更を暗黙的に蓄積しない方法に焦点を当てている。中心的な課題はノイズの多いフィードバック下での評価であり、より強力な探索・洗練・再帰的修正は、改善の検証、退行の拒否、オープンエンドな改善ループの管理を行うメカニズムと組み合わされて初めて有効となる。
テーマの状況
代表的な論文の序論は、自己改善型MLおよびLLMシステムにおける共通の緊張関係を述べている。反復的な洗練、探索、再帰的自己修正はより良い推論と適応を可能にするが、後の修正が以前のものより優れているとは限らない。SGM(2510.10232v1)はこれを再帰的編集のリスク制御問題として定式化し、AutoMLや強化学習におけるヒューリスティックな受理ルールが偽の改善を採用しうると論じている。SCREWS(2309.13075v1)も同様に、洗練ステップには以前の回答へロールバックできる選択メカニズムが必要となりうることを示している。並行して、AlphaLLMフレームワーク(2404.12253v1)は、探索ベースの自己改善がデータの制約、巨大な言語探索空間、不完全なフィードバックの克服に依存すると論じている。
今週の証拠として、MetaRSI / RSI2(2609.06396v1)はこの議論をより広範な再帰的自己改善システムへと押し進めている。その序論では、既存のRSIループの多くが機械検証可能なベンチマークに依然として紐付けられていると論じ、データ生成、実行ハーネスの編集、モデル更新を上位のスケジューリングポリシーの下で統合するフレームワークを提案している。これらの論文を総合すると、この分野は単純な自己洗練から、持続的な自己改善のためのより明示的な評価・認証・ループ設計原則へと移行しつつあることが示唆される。
- SCREWS: A Modular Framework for Reasoning with Revisions
- Toward Self-Improvement of LLMs via Imagination, Searching, and Criticizing
- SGM: A Statistical Godel Machine for Risk-Controlled Recursive Self-Modification
- MetaRSI / RSI2: A Meta-Recursive Self-Improving System for Recursive Self-Improving Systems Themselves
インフォグラフィクス(日本語)
今週の進展
MetaRSI / RSI2: A Meta-Recursive Self-Improving System for Recursive Self-Improving Systems Themselves <See Details on Fugu-MT>
MetaRSIは、モデル・データ・ハーネスの変更に対する型付き演算子のスケジュール合成として再帰的自己改善を統一的に定式化した。 コーディングや形式的ベンチマークに焦点を当てた従来のRSI研究と比較して、メタレベルのスケジューリングポリシーの下で科学・工学の設定にまでループを拡張している。
RISE: Recursive Improvement via Self-Extrapolating Policy Distillation <See Details on Fugu-MT>
RISEは、モデル自身のRL訓練軌跡から合成教師を蒸留することで、モデルを再帰的に改善する。 RL単体の訓練やオンポリシー自己蒸留と比較して、推論・コード・エージェントタスクにわたってスケールする自己改善メカニズムを提供する。
UniRRM: Unified Reasoning Reward Models Across Languages and Evaluation Paradigms <See Details on Fugu-MT>
UniRRMは、オープンエンドなRLタスクに対して複数言語および複数評価パラダイムをサポートする統一的推論報酬モデルを導入した。 静的で断片化されたベンチマークを超えて、より一貫性のある多言語評価層へと従来の報酬モデリングを拡張している。
From Interaction Traces to Persistent Skills: Online Evolution for Computer-Use Agents <See Details on Fugu-MT>
本フレームワークは、インタラクショントレースと評価者フィードバックを、コンピュータ操作エージェント用の永続的スキルのバージョン管理ライブラリに変換する。 繰り返し受理された編集が元のタスクの復元に失敗しうることを実証し、オンライン改善におけるロールバックとクロスタスク検証の必要性を強調している。
今後の展望
今後の展望(要約)
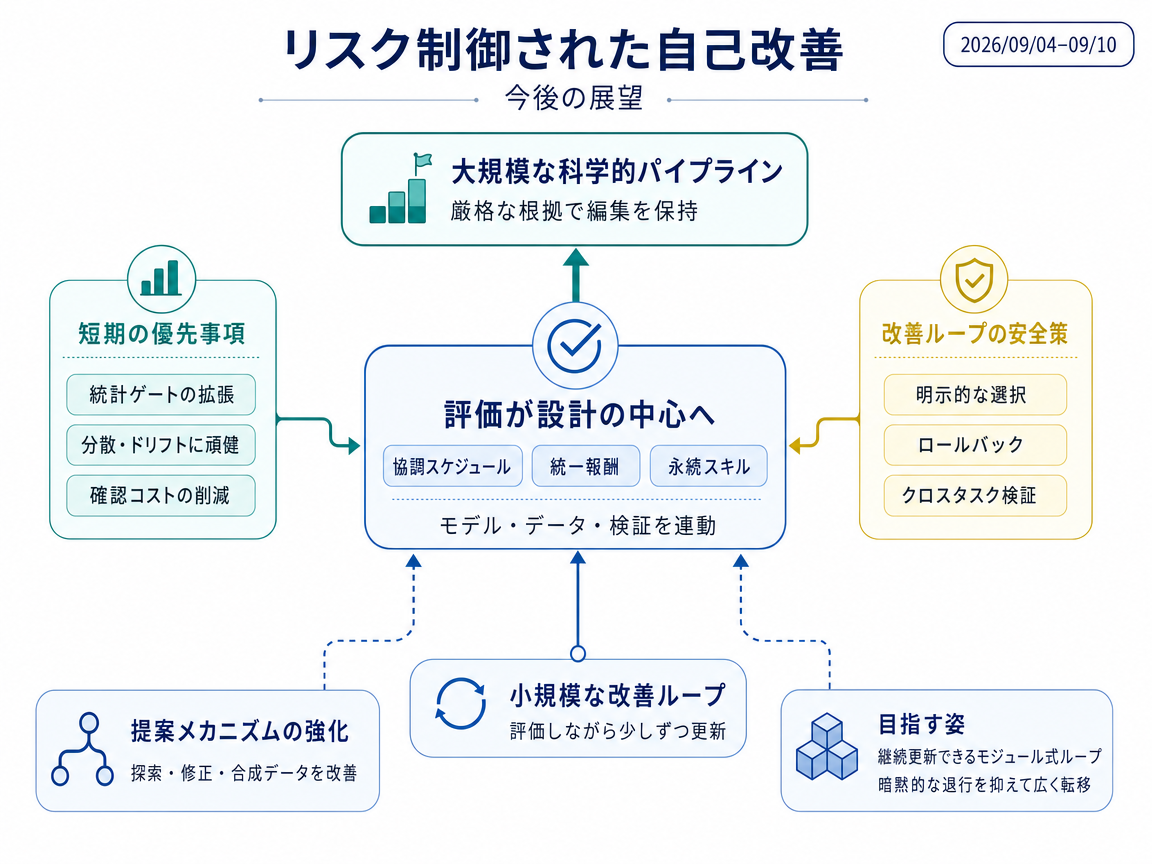
自己改善型システムは、小規模なベンチマークの反復から、より大きな自律型ワークフローや科学研究の工程へ広がる可能性が高い。ただし、変更を採用する前には、これまで以上に強い証拠が求められる。今後の重点は、統計的な合格判定を大規模化し、結果どうしの相関や試験条件の変化に対処しながら、必要に応じて確認回数を変えることで評価費用を抑えることにある。能力の修正や合成データの生成にも、以前の能力を守るための選別と復元の仕組みが必要になる。評価はシステム構成の一部となり、モデルやデータの更新を調整しつつ、再利用できる技能が複数の課題で保たれているかを確認するようになるだろう。全体としては、幅広い課題へ移せるモジュール型の改善ループに向かうが、進展には手頃な費用での検証と、見逃されやすい性能低下への対策が欠かせない。
インフォグラフィクス(日本語)
3年後を想定した動き
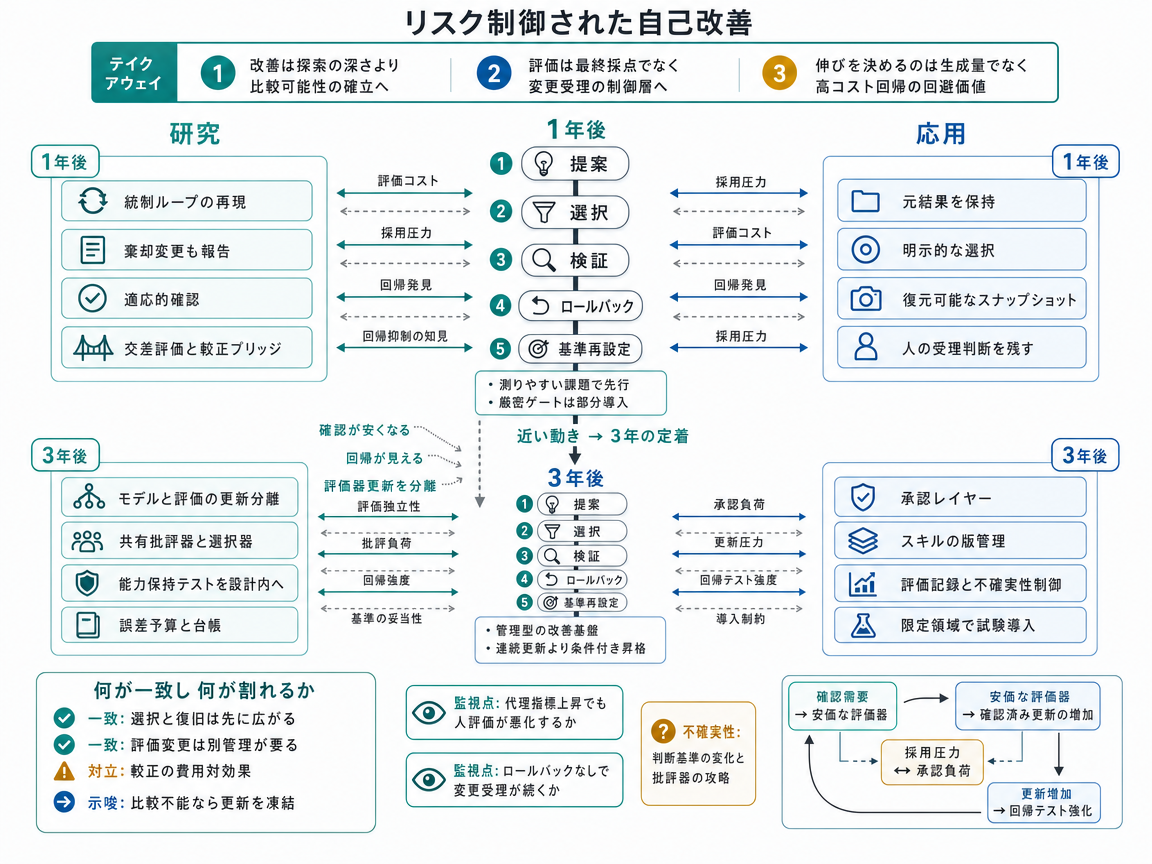
今後3年間で、自己改善は、単に高い得点を出すのではなく、提案された変更が実際の向上を示した場合だけ採用する、管理された更新手順になる可能性が高い。その仕組みは医薬品の変更管理に似ており、各候補を検証済みの基準版と比べ、問題があれば以前の版へ戻せるようにする。
1年目には、研究者が既存の推論やコード修復のループへ統計的な合格判定を加え、その後でより大規模なシステムへ広げるだろう。適応的な確認では、判断が不確かな場合に多くの試行を使い、結果が明確な場合には試行を減らす。これにより、検査規則を緩めずに、強い確認を手頃な費用で実施しやすくなる。初期の応用では、直近で合格した版を保存し、自動評価が重要な品質問題を見逃す場面では人間の承認も残す。
2年目には、モデルと評価器を同時に変えると改善の意味が分かりにくくなるため、更新の調整が中心課題になる。両者の更新時期を分け、新しい基準測定を行うことで、能力の向上と試験環境の変化を区別しやすくなる。版管理された技能の仕組みは、すでに機能している能力を保存し、過去の課題を使った検査は、忘却の発生や復元の有効性を確かめる。こうした管理が有効で費用も許容できれば、より多くの更新を確認でき、その結果として新たな弱点が見つかり、回帰試験も強化される。
3年目には、一部のソフトウェア保守や科学研究の工程で、優れた候補を作る方法と、合格判定や能力保持の検査が組み合わされる可能性がある。評価は恒久的な構成要素となり、各変更を受け入れた条件と、元に戻す方法が記録される。注目すべき兆候は、最終得点だけでなく、変更を却下した事例や復元に成功した証拠が、確認費用の低下とともに公表されることである。自動評価の得点だけが上がって人間の評価が悪化する場合や、試験条件の変化で比較が成立しない場合には、この道筋は弱まり、人間の承認が引き続き必要になる。
このシナリオでは、自己改善型システムが能力だけでなく、その能力を測る評価器まで変更し始めるため、信頼できる測定が中心課題になる。その仕組みは科学計測の考え方に基づき、評価器を測定器として扱い、保護された基準課題で比較の有効性を確かめる。
1年目には、研究者が旧版と新版の候補を両方の評価器で試し、採点方法の変更によって優れた候補の順位が変わるかを調べる。結果に争いがある場合は独立した担当者が検討し、評価器の版を結び付ける校正研究によって、結果を引き続き比較できる条件を明らかにする。初期のコード修復実験では、同じ評価方法で改善が再現できなければ採用を止める。意見の不一致を解消できない場合には、以前の状態へ戻すか、新しい基準測定を行う。
2年目には、評価器を続けて変更したときに不確実性がどう蓄積するかを調べ、どの時点で古い基準との直接比較が必要になるかを研究する。別の研究機関も異なる環境で一部の比較を再現し、ある場所で得られた証拠がどこまで通用するかを確かめる。応用チームは検証済みの校正手順を再利用し、記録された不一致から、費用の高い追加確認を優先すべき場所を見つけられる。選び方に偏りのある試験を公平な証拠とみなさず、許容できる費用で独立確認済みの改善を多く残せる場合に限って、適用範囲を広げる。
3年目までに校正が成功すれば、各構成要素を別々の時期に変更しても、以前の採用判断を支えた証拠を有効に保てる可能性がある。運用担当者は影響を受ける変更だけを止め、新しい課題と独立した確認によって、更新を繰り返した後も以前の能力が残っているかを調べる。注目すべき兆候は、複数回の評価器変更を経ても独立確認された向上が残り、測定の不確実性が採用に値する改善幅より小さいと示す履歴である。同じ費用で固定評価器による試験が同等に機能する場合、この道筋の必要性は弱まる。また、人間の選好自体が変化する場合には、新しい証拠の基準を作り直す必要がある。
このシナリオには制度面の推進力が加わり、科学や工学の組織がAIシステムの自己更新を認める前に、認証済みの変更計画を求める。その仕組みは工程を重視する食品安全管理を応用し、最終出力の検査だけに頼らず、運用全体に合格判定と是正措置を組み込む。
1年目には、研究者が範囲を限定した改善ループへ統計的な判定条件を加え、導入組織は許容する変更と承認に必要な証拠を定める。必要な場合だけ追加証拠を集める試験は、確認費用を抑えられる可能性がある。ただし、誤って変更を受け入れる確率の上限は条件付きのものであり、システム全体の安全を保証するわけではない。最初の重要な節目は、監査済みの試験運用が行われ、別の組織も互換性のある記録を受け入れることである。これにより、計画が一つの組織を越えて利用できると分かる。
2年目には、繰り返される更新によって以前の合格判定の前提が崩れ得るため、相関のある反応や変化するデータへの対処が研究される。評価器の変更にも独立した管理が必要となり、表明された確信度が実際の信頼性と合っているかを確認する。これにより、新しい採点方法が性能低下を隠すことを防ぐ。独立確認の下で以前の能力が保たれるなら、監督機関は、承認済み計画の範囲内にある変更について、全面的な再審査を省くことを検討できる。ただし、その許可は運用上の証拠に支えられた制度判断であり、統計試験への合格や書類の完成だけから自動的に決まるものではない。
3年目には、成功した試験運用を基に、更新と合格判定を調整しつつ、復元可能な版と追跡可能な変更記録を維持する共通の管理システムが作られる可能性がある。長期間動く科学研究エージェントは過去の課題で修正版を検査し、提供側は互換性のある証拠を複数の計画で再利用できる。費用を抑えた有効な確認が普及を促し、共通ツールの改善がさらに強い検証を実用的にするという循環が生まれる。注目すべき兆候は、複数の運用中の試験が共通の証拠を実際に受け入れることであり、似た規則や記録形式を公表するだけでは不十分である。固定された試験が攻略された場合や、計画どおりに運用しても能力低下を見逃す場合には、この道筋は弱まる。特に、想定される制度移行の期間がかなり短い点には注意が必要である。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- SCREWS: A Modular Framework for Reasoning with Revisions - 著者: Kumar Shridhar, Harsh Jhamtani, Hao Fang, Benjamin Van Durme, Jason Eisner, Patrick Xia / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Toward Self-Improvement of LLMs via Imagination, Searching, and Criticizing - 著者: Ye Tian, Baolin Peng, Linfeng Song, Lifeng Jin, Dian Yu, Haitao Mi, Dong Yu, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- SGM: A Statistical Godel Machine for Risk-Controlled Recursive Self-Modification - 著者: Xuening Wu, Shenqin Yin, Yanlan Kang, Xinhang Zhang, Qianya Xu, Zeping Chen, Wenqiang Zhang, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- MetaRSI / RSI2: A Meta-Recursive Self-Improving System for Recursive Self-Improving Systems Themselves - 著者: Zihan Tan, Leixin Sun, Zitong Shi, Yitao Liu, Jiajun Wu, Nathaniel Brooks, Jiaru Qian, Xiaoran Shang, Suyuan Huang, Yi Ding, Yangxu Liao, Mukai Li, Qiushi Sun, Shudong Liu, Xuankun Rong, Xiaohang Yu, Zhuo Chen, Hejia Geng, Chenxin Li, Aozhou Wang, Zengji Tu, Robert Tang, Yuxin Zhan, Eric Jiang, Yuxin Wu, Jianqing Zhang, Xiao Liang, Fang Wu, Haochi Zhang, Alexander Marlow, Guancheng Wan / <See Details on Fugu-MT> / ライセンス: CC BY 4.0