サマリー
本テーマは、急速に増大するKVキャッシュのメモリフットプリントを削減し、長コンテキストLLM推論を実用化することを中心に据えている。代表的な論文群は、量子化・レイヤ間共有・トークン/状態マージといった相補的な圧縮戦略を軸に分野を整理しており、生成品質を維持しつつ、より長いコンテキスト、より大きなバッチサイズ、より低いサービングコストの実現を共通の目標としている。
テーマの状況
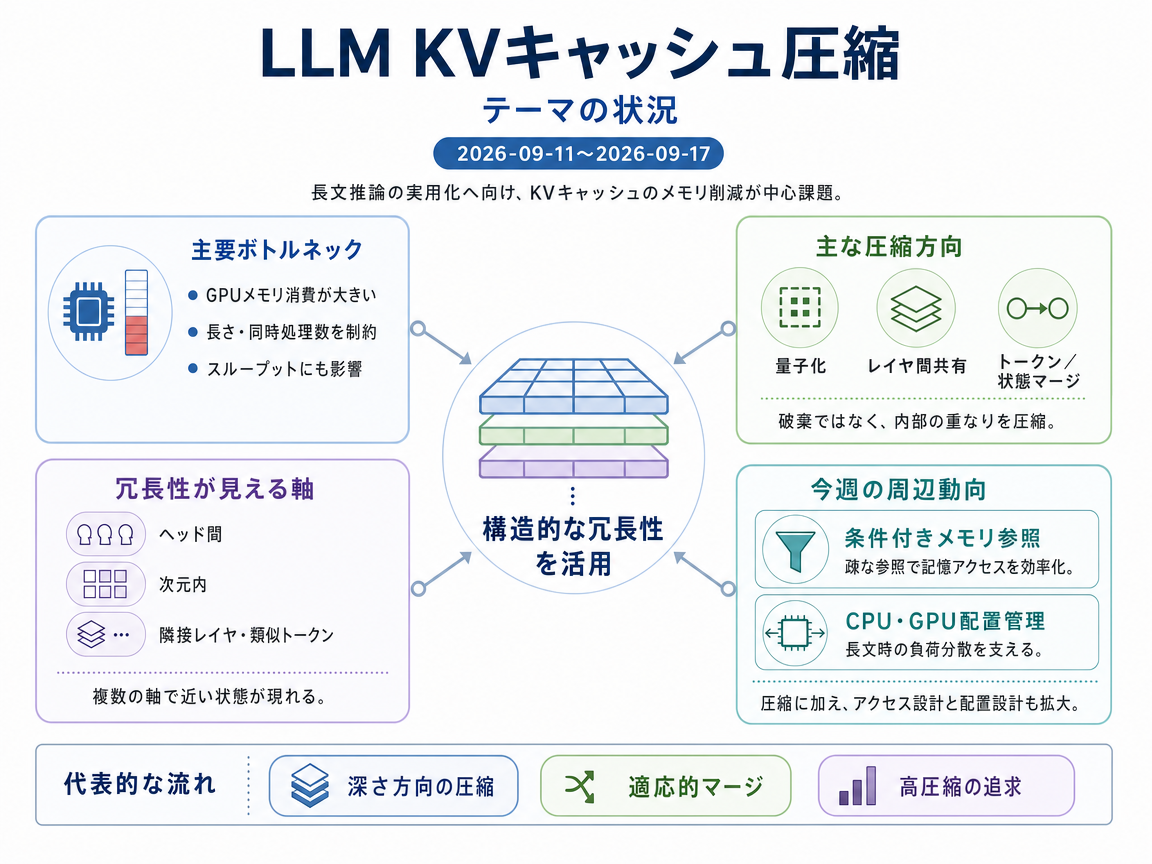
代表的な論文の導入部では、KVキャッシュがデコーダ専用LLMの主要なデプロイボトルネックとして描かれている。コンテキストウィンドウとモデルサイズが拡大するにつれ、キャッシュされたキー・バリュー状態が大量のGPUメモリを消費し、トークン長、バッチサイズ、スループットを制約する。主な研究方向は単にキャッシュを破棄することではなく、キャッシュ内の構造的冗長性を活用することにある。引用論文群は、この冗長性がアテンションヘッドや次元内、隣接レイヤ間、長コンテキスト中の類似トークン状態間など複数の軸にわたって現れると主張しており、ほぼ無損失の性能を維持しつつメモリ使用量を大幅に削減する手法——共同圧縮アーキテクチャ、レイヤ間マージ、類似度ベースKVマージなど——の動機づけとなっている。
この状況の中で、今週はキャッシュ管理のみにとどまらない効率的LLMスケーリングの拡大を示す隣接的な証拠が加わった。MoME: Mixture-of-Memory Embeddings for Context-Aware Sparse Lookup(arXiv:2609.15126v1)は、トランスフォーマーにはネイティブな検索プリミティブが欠如していると主張し、静的パターンの検索を密な計算から分離する軽量スパースルックアップ機構として、コンテキスト対応の条件付きメモリを提案している。KVキャッシュ論文ではないが、LLMシステム研究がメモリ効率と条件付きアクセスを軸にますます組織化されているという広範なトレンドを裏付けており、よりスケーラブルな長コンテキスト推論への動きを補完している。
- MiniCache: KV Cache Compression in Depth Dimension for Large Language Models
- Model Tells You Where to Merge: Adaptive KV Cache Merging for LLMs on Long-Context Tasks
- Lossless KV Cache Compression to 2%
- MoME: Mixture-of-Memory Embeddings for Context-Aware Sparse Lookup
インフォグラフィクス(日本語)
今週の進展
DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression <See Details on Fugu-MT>
DeepSeek-V4.1-Flash: KVキャッシュ圧縮の限界を押し広げる: DeepSeek-V4.1-Flashは、552Bのバックボーンパラメータを持つマルチモーダルMixture-of-Experts(MoE)モデルで、最大100万トークンのコンテキストをサポートする。Causal-Decoder(CED)アーキテクチャでは、デコード時にトークン毎に16Bパラメータを起動するが、プリフィル時に8Bパラメータしか有効にせず、エージェントワークロードのコスト効率を大幅に向上する。 本論文の具体的なタスク、手法、エビデンス、または応用設定を通じて、モデル評価/LLMに関連する。
MoME: Mixture-of-Memory Embeddings for Context-Aware Sparse Lookup <See Details on Fugu-MT>
MoMEは、固定されたトークン毎のメモリベクトルを隠れ状態ゲーティングで選択されるスロットの混合に置き換えるコンテキスト対応スパースメモリルックアップを導入し、複数のアーキテクチャにわたって事前学習済みLLMバックボーンを改善した。 格納状態を削減するKVキャッシュ圧縮手法とは異なり、MoMEはLLM容量のスケーリングに向けた相補的経路として、メモリ効率の高い条件付きアクセスへとテーマを拡張している。
Physically Partitioned KVCache Format for CPU--GPU Load Balancing in MoE Inference <See Details on Fugu-MT>
InplaceKVCacheは、書き込み時にKVキャッシュエントリのバイトレベルの物理的配置を固定する形式的な抽象化を導入し、長コンテキストMoE推論時における原理的なCPU–GPU負荷分散を可能にした。 圧縮によるキャッシュサイズ削減ではなく、シングルGPUサービング向けのシステムレベルのKVキャッシュ配置およびスピル管理へとテーマを拡張している。
今後の展望
今後の展望(要約)
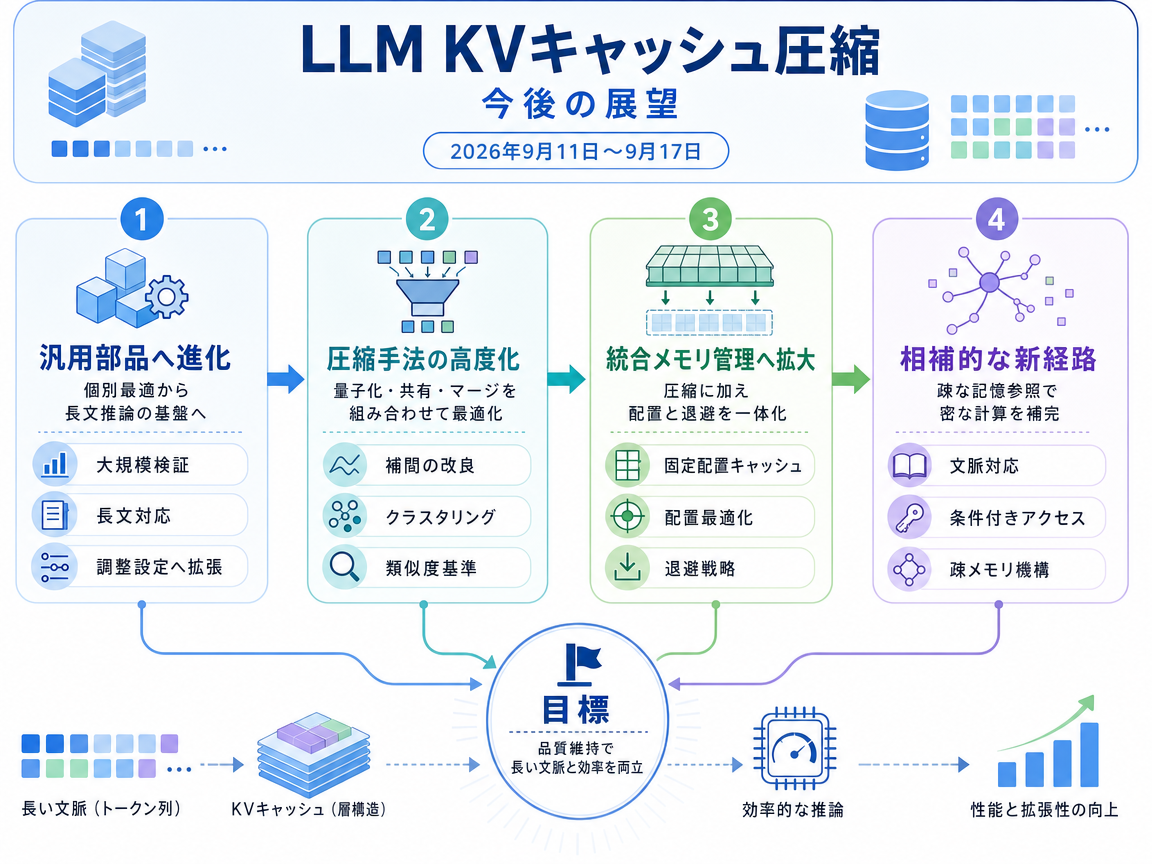
KVキャッシュ圧縮は、個別の手法から、長いコンテキストの推論に再利用できる部品へと発展しつつある。今後は、より大規模なモデルやファインチューニング済みモデルでの検証、圧縮処理の効率的な分散、複数層にまたがる類似データの統合が重要になる。次の段階では、情報をほぼ失わない圧縮とCPU・GPU間のキャッシュ配置を組み合わせ、GPUメモリからデータを適切に退避させる統合的なメモリ管理が求められる。文脈に応じた疎なメモリも、必要な情報の選択的な検索と密な計算を分ける補完的な方法になる。
インフォグラフィクス(日本語)
3年後を想定した動き
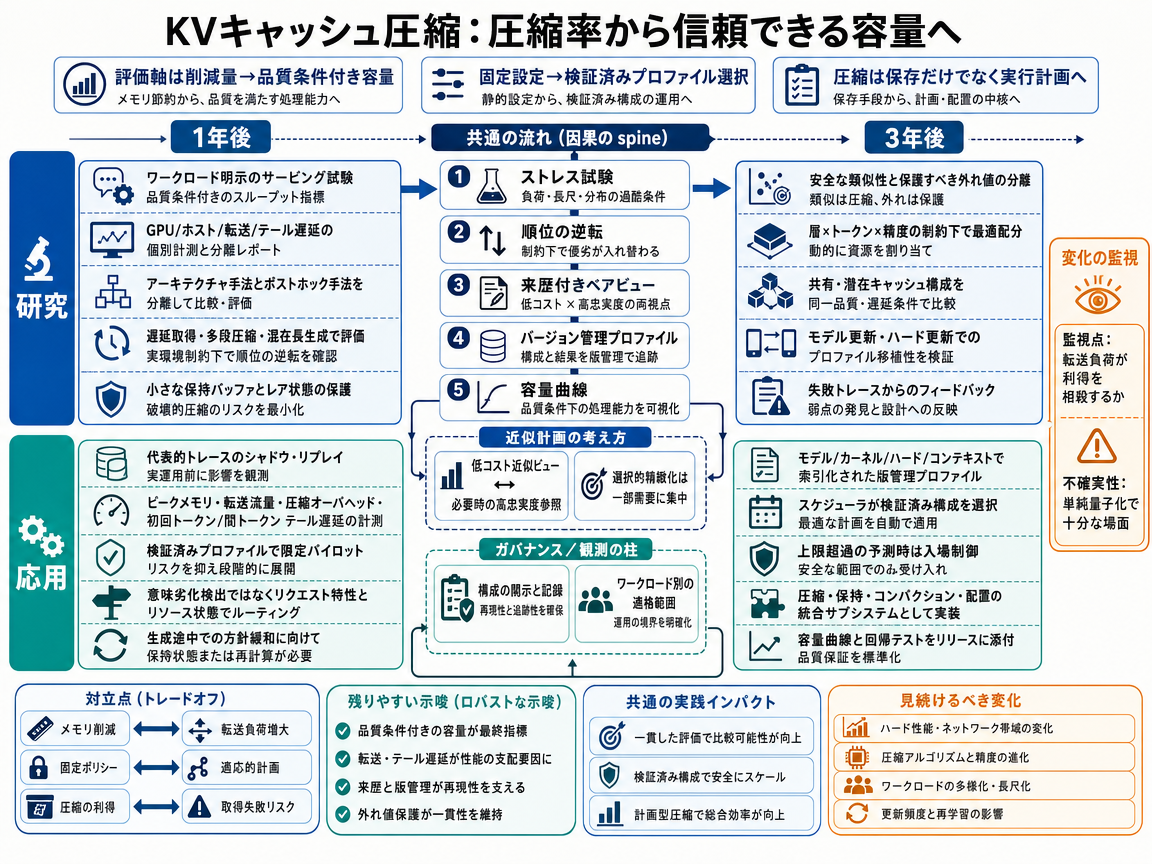
今後3年間で、KVキャッシュ圧縮は、単なるメモリ節約策ではなく、連携して動くメモリサブシステムへ発展する可能性がある。その評価では、電力供給を高負荷時に試すように、定められた品質と応答時間を守りながら、どれだけ安定して処理できるかを測る。初年度には、キャッシュを繰り返し統合しても見落とされやすい事実を保持できるかを調べる。同時に、コンテキスト長の異なる要求が並行して届く条件でも検証する。中心的な指標は、回答品質と応答時間の両方を満たした完了処理量であり、メモリ使用量と転送負荷は別に報告する。初期の有力な兆候は、見かけ上の節約量が小さい手法のほうが、異なるモデルやハードウェアで多くの実用的な処理能力を支えるという順位逆転が再現されることである。
2年目には、試験で見つかった失敗を基に、安全に統合できるキャッシュ状態と、保護すべき希少な情報を区別する。実行環境の開発チームは、成功した設定を検証済みプロファイルとしてまとめ、特定のモデルと実行条件に結び付ける。ソフトウェアは、コンテキスト長や現在の負荷に応じて、その範囲内からプロファイルを選ぶ。検証済みの上限を超えそうな場合は、新しい要求の受け付けを遅らせる。ただし、メモリ量の計測だけでは必要な情報が回答に残るか判断できないため、選択肢は試験済みの設定に限られる。
3年目には、最初から小さなキャッシュ向けに設計したモデルと、既存モデルへ圧縮を追加した方式を、同じ品質・遅延条件で比較できるようになる。実行基盤は圧縮、保持、データ配置を連携させ、コンテキストが長くなったときに同時処理数がどう変わるかを検証済みの曲線で示す。運用中の失敗は新しい試験事例となり、プロファイルの順位や既定設定の更新につながる。この道筋は、試験が実際の問題を予測できない場合や、単純な量子化が大幅に少ない複雑さで同程度の結果を出す場合に弱まる。検証に成功しても示せるのは試験済みの動作範囲までであり、削除した情報は復元できず、未知の入力が新たな失敗を引き起こす可能性がある。
今後3年間で、圧縮は一つの固定設定ではなく、必要な場合だけ高精度のデータを参照する調整可能な実行計画になる可能性がある。その仕組みは近似的なデータベース照会に似ており、圧縮キャッシュで低コストの初期結果を作り、保持した元の状態から必要に応じて精度を高める。初年度には、圧縮ブロックと元データを対応付け、低コストの信号で精度向上が有効な場面を見分けられるかを試す。実運用に近い試験では、十分に調整した固定方針と比較し、GPUメモリの節約量だけでなく、保存領域や転送の負荷も測る。初期の重要な兆候は、精度向上が必要な事例が一部に集中し、未経験の要求でも品質リスクを安定して予測できることである。
比較が成功すれば、2年目には手作業の規則を、モデルごとの検証済みプロファイルへ置き換える。各プロファイルは、利用可能な操作の実行コストと、観測された品質リスクを記録する。複数の要求が同時に元データを取得するとCPU・GPU間の接続が混雑するため、技術者は先読みと生成処理のまとまりを調整する。より高精度な実行との抜き取り比較により、コストの大きい誤判断を見つけ、不要な精度向上を減らす。また、未知の入力やモデル更新後でも判定信号が有効かを確認する。需要や予測誤差が検証範囲を超えた場合は、試験済みの代替設定と受け付け量の制限によって影響を抑える。
3年目には、成功した結果がキャッシュ配置やアテンション用の計算処理に反映され、圧縮された状態と保持データの間を移動する費用が下がる可能性がある。各圧縮ブロックの生成記録があれば、精度向上に使える情報と、すでに失われた情報を実行基盤が判別しやすくなる。適したサービスでは、品質と遅延が実証済みの範囲内で圧縮計画を調整しつつ、CPU側のメモリ負荷や転送コストを継続的に測る。このシナリオは、誤り検出のためにほぼ常に高精度処理が必要な場合や、固定された圧縮・配置方針が同等に機能する場合に弱まる。また、後から高精度データを取得しても、以前の内部状態の変化や生成済みの出力までは通常取り消せないため、完全な回復策にはならない。
今後3年間で、キャッシュ方針の違いが、共通の情報開示と適格性確認の仕組みにつながる可能性がある。同じモデルの重みを使っても、長いコンテキストに対する動作が同じになるとは限らないからである。中心となる方法は、名称を明示した基準設定との比較であり、すべての入力で同一の回答を求めるのではなく、指定された処理で許容できる差を定める。初年度には、同じメモリ上限の下で複数のキャッシュ設定を比較し、かなり前に示された情報を後で利用できるかを試す。品質差の測定には不確実性も添える。実行環境にはプロファイル識別子と設定記録を加え、報告された性能低下をメモリ方針の変更まで追跡できるようにする。非公開のキャッシュ変更による失敗が記録されれば、利用組織や共同体が設定開示と簡略な基準比較を求めるきっかけになり得る。
小規模な共有評価セットは、定めた品質要件を満たしつつメモリ使用量を減らせる設定を探すことで、研究と実運用を結び付ける。この道筋が加速するのは、再利用可能な試験報告を作る費用が、組織ごとに別々の証拠を繰り返し用意する費用より低い場合である。2年目に実際の要求が生まれれば、合格した設定を登録する仕組みを構築できる。そこには、モデルの版や実行条件とともに、試験済みのメモリ方針を記録する。処理内容によって許容差は異なり、実行環境や要求の分布が変われば、以前の結果に頼り続けず再検証する必要がある。
3年目には、自動試験と再利用可能な報告書により、参加組織の内部で適格性確認が日常的になる可能性があるが、普遍的な認証制度の成立を意味するわけではない。小さなキャッシュを前提に設計されたモデルでは、圧縮表現自体が基準モデルの一部になるため、評価対象はメモリサブシステム全体へ広がる。運用者は処理内容に合う検証済みプロファイルを選び、過去の証拠が当てはまらない兆候が出た場合には基準設定へ戻せる。最も強い観測指標は、利用組織が実際に報告を要求し、実行基盤が検証済み設定を簡単に選択・記録できるようになることである。こうした要求が現れない場合や、結果を再現できない場合には、共有基盤ではなく個別組織の開発手法の改善にとどまる可能性が高い。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- MiniCache: KV Cache Compression in Depth Dimension for Large Language Models - 著者: Akide Liu, Jing Liu, Zizheng Pan, Yefei He, Gholamreza Haffari, Bohan Zhuang, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Model Tells You Where to Merge: Adaptive KV Cache Merging for LLMs on Long-Context Tasks - 著者: Zheng Wang, Boxiao Jin, Zhongzhi Yu, Minjia Zhang, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Lossless KV Cache Compression to 2% - 著者: Zhen Yang, J. N. Han, Kan Wu, Ruobing Xie, An Wang, Xingwu Sun, Zhanhui Kang, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- MoME: Mixture-of-Memory Embeddings for Context-Aware Sparse Lookup - 著者: Muchen Li, Leonid Sigal, Renjie Liao / <See Details on Fugu-MT> / ライセンス: CC BY 4.0