サマリー
本テーマは、評価と検証がデータ選択、選好チューニング、強化学習を導く、オープンで多段階のLLMポストトレーニングを中心とする。今週の研究は、再現可能なレシピ、エージェント指向のベンチマーク、より効率的な評価を加えた。通信分野の研究はこのパターンを異種のドメインタスクへ拡張し、汎用的な推論能力で十分とみなすのではなく、情報源に根拠づけられた学習とタスク固有の報酬を重視している。
テーマの状況
TÜLU 3は、ポストトレーニングを、スキル別評価と汚染除去に導かれた、教師ありファインチューニング、選好チューニング、検証可能な報酬による強化学習からなる再現可能なパイプラインとして位置づけている。ポストトレーニングに関するサーベイは、これらの選択をテスト時スケーリングと並べて整理しつつ、事実的信頼性、アライメント、推論評価の難しさを強調している。DR Tuluは、オープンエンドな調査型の回答では検証がなぜ難しくなるかを示している。固定ルーブリックは重要な品質を見落とす可能性があり、モデル出力とともに進化する検索に根拠づけられたルーブリックの動機となっている。
今週のエビデンスとして、「TelecomGPT-R1: Unified Post-Training for Reasoning Across Heterogeneous Telecom Tasks」は、教師ありファインチューニングと強化学習の2段階レシピを、標準仕様、ログ、設定、数式、コードに適用している。その序論では、これらのタスクが推論構造、検証器の設計、報酬密度の点で異なると論じ、プロセスフィードバックと結果の正しさを組み合わせたタスク別ルーティングのルーブリック報酬を用いている。これらの論文は総じて、評価を単なる最終スコアではなく、オープンなポストトレーニング全体を通じた設計上の制約として扱っており、特に回答が外部または専門的な情報源に根拠づけられる必要がある場合にその傾向が強い。
- TÜLU 3: Pushing Frontiers in Open Language Model Post-Training
- LLM Post-Training: A Deep Dive into Reasoning Large Language Models
- DR Tulu: Reinforcement Learning with Evolving Rubrics for Deep Research
- TelecomGPT-R1: Unified Post-Training for Reasoning Across Heterogeneous Telecom Tasks
インフォグラフィクス(日本語)
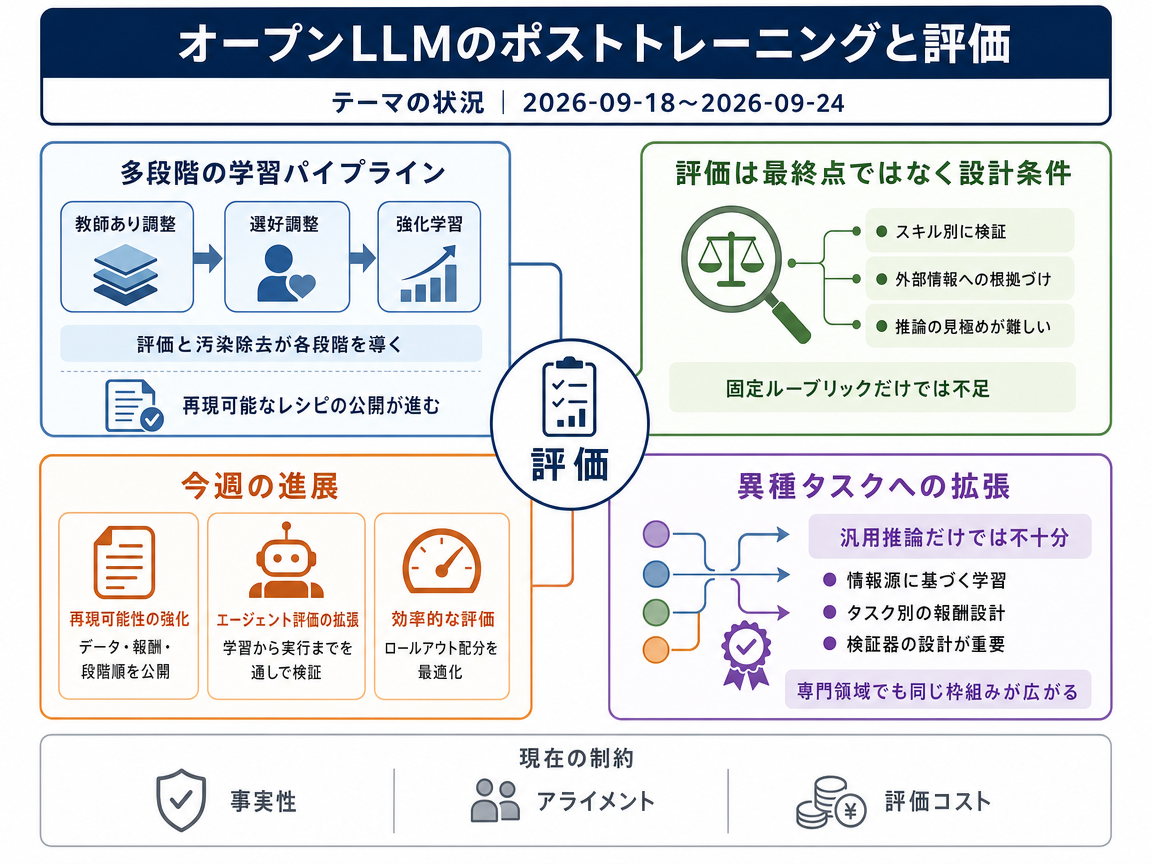
今週の進展
Rufus-Air: An Open LLM Post-Training Recipe <See Details on Fugu-MT>
Rufus-Airは、GLM-4.5-Air-Base上のオープンなポストトレーニングレシピを文書化した。 データ、報酬設計、インフラ、段階の順序、段階ごとの結果を再現可能な形で公開している。
Trains but Doesn't Learn: A Post-Training Delivery Benchmark for LLM Agents as Forward-Deployed Engineers <See Details on Fugu-MT>
このベンチマークは、予算制約下でモデルのファインチューニング、評価、デプロイを行うLLMエージェントを評価する。 評価の対象をモデルのスキルから、8B〜70Bのオープンなベースモデルと複数のGPU種別にわたるエンドツーエンドのポストトレーニング遂行へと移している。
SkillGym: Internalizing Human Skills into LLMs for Real-World Problem Solving <See Details on Fugu-MT>
SkillGymは、人間のスキルをLLMエージェント向けの実行可能かつ検証可能な学習環境に変換する。 エージェントの学習を検証可能なスキル実行に結びつけており、35BエージェントはスキルアシストありのSkillsBenchで51.47%を達成したと報告されている。
GVPO++: Group Variance Policy Optimization for LLM Post-Training and On-Policy Distillation <See Details on Fugu-MT>
GVPO++は、KL制約付き報酬最大化の解析解から勾配の重み付けを構成する。 同じポストトレーニング手法をオンポリシー蒸留へ拡張している。
TelecomGPT-R1: Unified Post-Training for Reasoning Across Heterogeneous Telecom Tasks <See Details on Fugu-MT>
TelecomGPT-R1は、通信分野向けのオープンな推論モデルと再現可能な学習レシピを公開した。 汎用的な推論のみに頼るのではなく、検証を考慮したポストトレーニングを異種の専門タスクに適用している。
Speculative Evaluation of Stochastic LLMs <See Details on Fugu-MT>
Speculative evaluationは、パイロット結果と投機的な継続を用いて確率的なLLMロールアウトを割り当てる。 タスクあたり8〜64ロールアウトにおいて、一様割り当てと比べて評価の分散を平均12.8〜33.6%削減する。
Critical-State RL: Diagnosing Trainable States for Multi-Turn Tool Use <See Details on Fugu-MT>
Critical-State RLは、マルチターンのツール使用においてどの状態が学習に値するかを診断する。 報酬が行動のタスク成功への影響を捉えているか、および参照方策が改善可能かを検証しており、BFCL v4で評価している。
ACLArena: Agent Continue Learning in Multi-stage Post-training <See Details on Fugu-MT>
ACLArenaは、多段階のポストトレーニングを通じてエージェントの能力がどのように引き継がれるかを調べる。 オフラインの軌跡リプレイとRLでルーティングされるLoRAエキスパートを組み合わせた継続学習レシピを加えている。
今後の展望
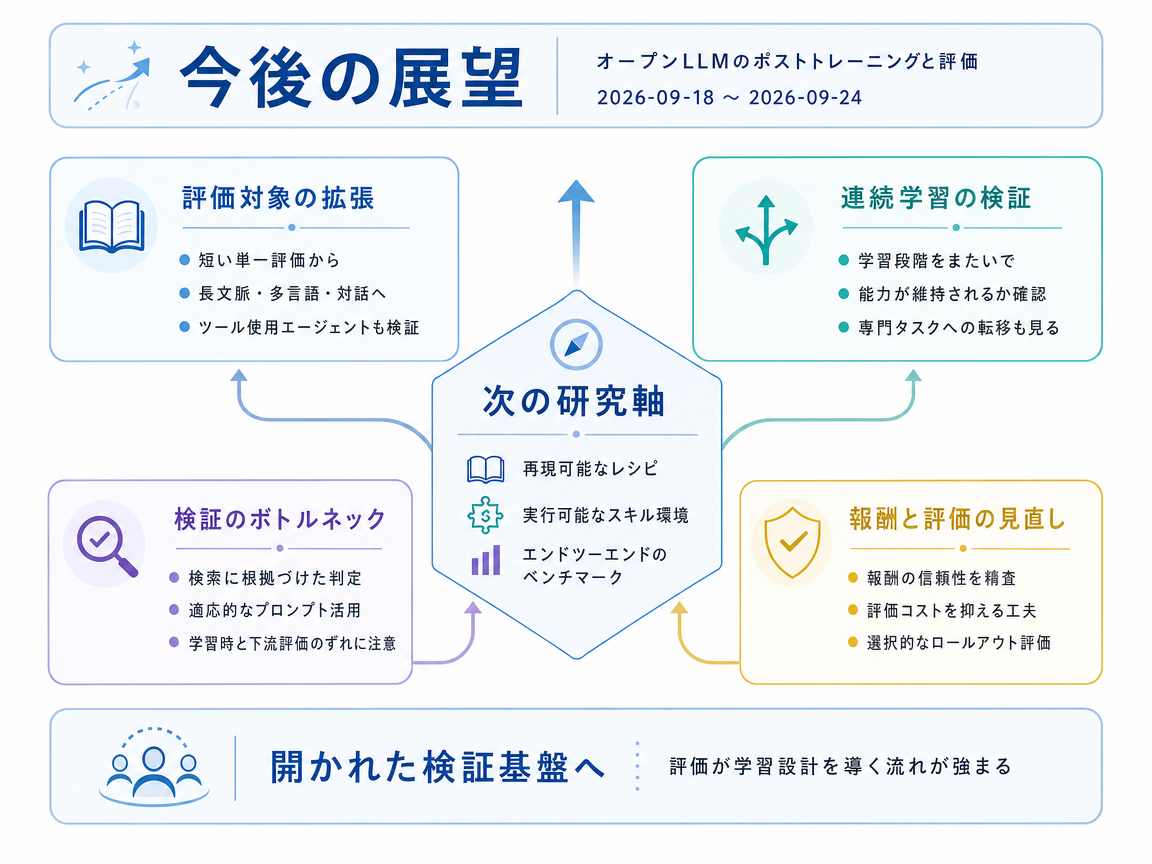
今後の展望(要約)
公開された追加学習手法は、TÜLU 3が示した課題に対応するため、より長い対話、多言語タスク、ツールを使うエージェントへと広がる可能性が高い。再現可能な作業手順と実行可能なベンチマークを使えば、複数の学習段階を経ても能力が維持され、専門タスクへ転用できるかを検証できる。ただし、検証は依然としてボトルネックである。DR Tuluは、検索結果に基づいて変化する評価基準を提案する一方、学習時の判定と下流テストの結果が一致しない問題も示している。そのため、タスク別の報酬や選択的な評価については、学習時の報酬だけで有効と判断せず、報酬の抜け道、判定の信頼性、評価全体のコストを調べる必要がある。
インフォグラフィクス(日本語)
3年後を想定した動き
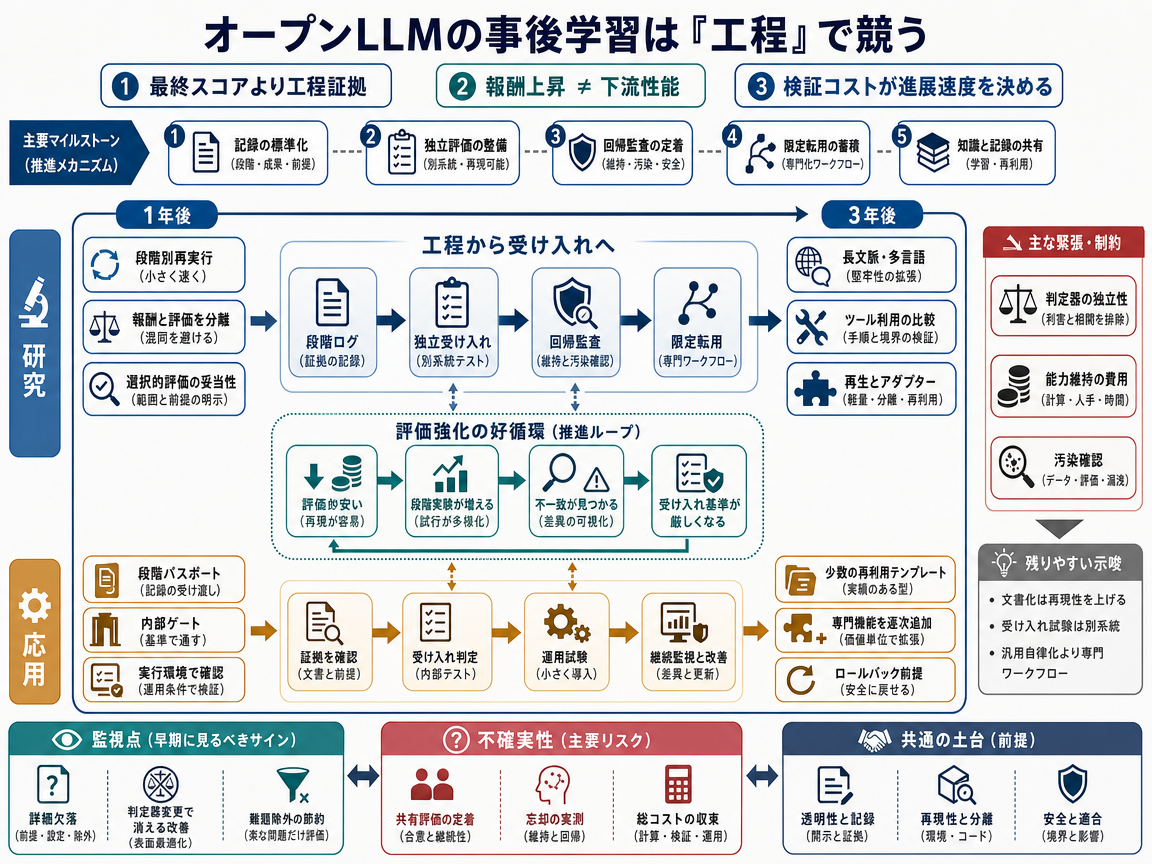
今後3年間で、公開された追加学習の研究は、広く自律的に動くエージェントよりも、再現可能な少数の専門作業手順を生み出す可能性がある。TÜLU 3が公開した学習手順とDR Tuluの報酬実験は、その出発点になる。ただし、学習時の得点が向上しても、実用上の性能は別に検査しなければならない。1年目には、各チームが個々の学習段階を再現し、モデルの作成過程を記録しながら報酬設計を比較する。少なくとも二つの独立したグループが、別々の下流評価でも段階ごとの改善を再現できれば、重要な初期シグナルとなる。
その証拠が蓄積すれば、2年目には手法をより長い対話やツール利用へ拡張し、他の言語によって転用の限界を調べる。モデルが評価基準に適応した後も、変化する採点基準が良い回答と悪い回答を区別できるかを確認する。実務では、検証済みの少数の専門タスク用テンプレートが定着し、学習と評価の仕組みを毎回作り直す必要が減る可能性がある。この仕組みは工程の妥当性確認に似ており、記録された学習段階によって開発過程を点検し、独立した受け入れテストで目的に合うモデルかを確認する。選択的なテストは評価コストを下げ、追加実験を行いやすくするが、難しいタスクを避けるだけであってはならない。
3年目には、専門能力を一つずつ追加しながら以前の能力が保たれているかを検査し、許容できない後退があれば旧版へ戻せるようになる。過去の学習例を再利用したり、小規模な専門モジュールを接続したりする方法は能力維持に役立つかもしれないが、確実な解決策とはまだいえない。その後は、回答生成を含む学習と検証の総コストを考慮しても、こうした制御された能力追加が有用かを調べる必要がある。週次報告で示された結果は再現研究の出発点であり、この移行がすでに起きたことを独立に証明するものではない。評価者を変えただけで改善が消えるなら、未知の利用者やツールに対する信頼性を文書だけでは示せないため、このシナリオの説得力は弱まる。
このシナリオでは、報酬設計が改善して学習段階を繰り返せる一方、それらが損なう可能性のある能力をすべて確認するには高いコストがかかると想定する。今後3年間では、以前の能力を維持することが、信頼できるモデル開発の中心的な制約になる。ただし、報酬の質そのものが重要でなくなるわけではない。1年目には、研究者が各段階の後で能力を測定し、過去の学習例を再利用する方法や専門機能を分離する方法を比較する。開発チームは、変更点、改善点、後退した点を段階ごとに記録し、新版を採用する前に確認する。
同程度の計算資源で、改善と能力維持の両方を独立したチームが再現できれば、保存手法が機能していることを示す強い初期シグナルになる。2年目には、長い対話や未知のツールによって保護すべき能力が増え、多言語テストによって検査範囲の不足も明らかになる。この仕組みは生物学的なラチェットに似ており、各段階は直近の目標を改善しながら、後の作業では戻せない損失を別の場所に生む可能性がある。過去の例を再利用したり、タスクを専門部品へ振り分けたりすれば、この損失の蓄積を抑えられるかもしれない。ただし、その修復に必要なコストも測定しなければならない。新しい段階が検査より速く隠れた損失を生み、修復のたびに仕組みが複雑になる場合、危険性が高まる。
3年目の主な評価課題は、限られたテスト予算の中で、必要な能力全体をどのように観測可能に保つかになる。選択的なテストでは、よく使うタスクの反復を減らすだけでなく、利用頻度の低い能力も検査対象に残す必要がある。保存の仕組みが成功すれば、検査範囲の記録と旧版へ確実に戻せる手順を使い、専門能力を取り外し可能な形で追加しながら多能力モデルを維持できる。失敗した場合は、複雑化する連続学習より、安定した汎用モデルと独立した専門モジュールを組み合わせる方が実用的になり得る。ただし、チェックポイントは復元できるため、この比喩には限界があり、忘れた能力を低コストで検出できる場合や特別な保存手法なしに安定して回復できる場合には、このシナリオは弱まる。
今後3年間で、共有の測定ツールは、単なる任意の報告支援ではなく、どの追加学習結果を再利用すべきか判断するための信頼できる基盤になる可能性がある。出発点となる問題は、学習手順が公開されていても、学習時の報酬向上が下流性能の改善を安定して予測できないことである。1年目には、研究者が段階ごとの改善を独立に再現し、評価者や計算予算を変えても結論が維持されるかを調べる。共通の評価ハーネス、つまり同じ条件の検査を実行して結果を記録するソフトウェアがあれば、異なるチーム間で比較を繰り返しやすくなる。
重要な初期シグナルは、再現失敗が繰り返される一方で、保守されている共通ハーネスを少なくとも一つのチームが成果物の採否判断に使うことである。この条件を満たせば、2年目には長い対話や未知のツールへテストが広がり、他の言語によって手法を転用できる範囲も明らかになる。開発チームは、目的に必要な以前の能力を消してしまう場合、新しい学習段階の公開を止める検査を導入する。比較可能なテストが弱い手法を明らかにすると、チームは外部証拠を重視し、その結果として共有検査が次の研究にも強い影響を持つようになる。この仕組みは公衆衛生における共通の報告定義に似ており、単一のテストがあらゆる場面の信頼性を証明しなくても、分散した観測結果を比較可能にする。
3年目まで継続して再利用されれば、すべての検査を作り直さずに既存の作業手順を調整できる、少数の互換性ある評価システムが広く使われる可能性がある。その保守担当者は、許容できる評価の不確実性や能力低下の範囲を定める役割を強め、性能実証に必要な資源も見えやすくする。研究者は、研究報告の根拠確認や未知のツール操作の完了を含め、評価システムが目的の能力を本当に測っているかを引き続き調べる必要がある。大きな注意点は、使い慣れた検査自体が最適化の標的となり、基礎的なタスク能力が改善していなくてもモデルが採点規則だけを満たす可能性である。独立した評価者と定期的に更新されるタスクは対策になり得るが、共有資源が保守されない場合や安価な独自検査が引き続き好まれる場合、この変化は弱まる。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- TÜLU 3: Pushing Frontiers in Open Language Model Post-Training - 著者: Nathan Lambert, Jacob Morrison, Valentina Pyatkin, Shengyi Huang, Hamish Ivison, Faeze Brahman, Lester James V. Miranda, Alisa Liu, Nouha Dziri, Shane Lyu, Yuling Gu, Saumya Malik, Victoria Graf, Jena D. Hwang, Jiangjiang Yang, Ronan Le Bras, Oyvind Tafjord, Chris Wilhelm, Luca Soldaini, Noah A. Smith, Yizhong Wang, Pradeep Dasigi, Hannaneh Hajishirzi, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- LLM Post-Training: A Deep Dive into Reasoning Large Language Models - 著者: Komal Kumar, Tajamul Ashraf, Omkar Thawakar, Rao Muhammad Anwer, Hisham Cholakkal, Mubarak Shah, Ming-Hsuan Yang, Phillip H. S. Torr, Salman Khan, Fahad Shahbaz Khan, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- DR Tulu: Reinforcement Learning with Evolving Rubrics for Deep Research - 著者: Rulin Shao, Akari Asai, Shannon Zejiang Shen, Hamish Ivison, Varsha Kishore, Jingming Zhuo, Xinran Zhao, Molly Park, Samuel G. Finlayson, David Sontag, Tyler Murray, Sewon Min, Pradeep Dasigi, Luca Soldaini, Faeze Brahman, Wen-tau Yih, Tongshuang Wu, Luke Zettlemoyer, Yoon Kim, Hannaneh Hajishirzi, Pang Wei Koh, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- TelecomGPT-R1: Unified Post-Training for Reasoning Across Heterogeneous Telecom Tasks - 著者: Bohao Wang, Chenwei Wu, Hang Zou, Yu Tian, Lina Bariah, Li Wei, Chongwen Huang, Yongliang Shen, Zhaoyang Zhang, Merouane Debbah / <See Details on Fugu-MT> / ライセンス: CC BY 4.0