サマリー
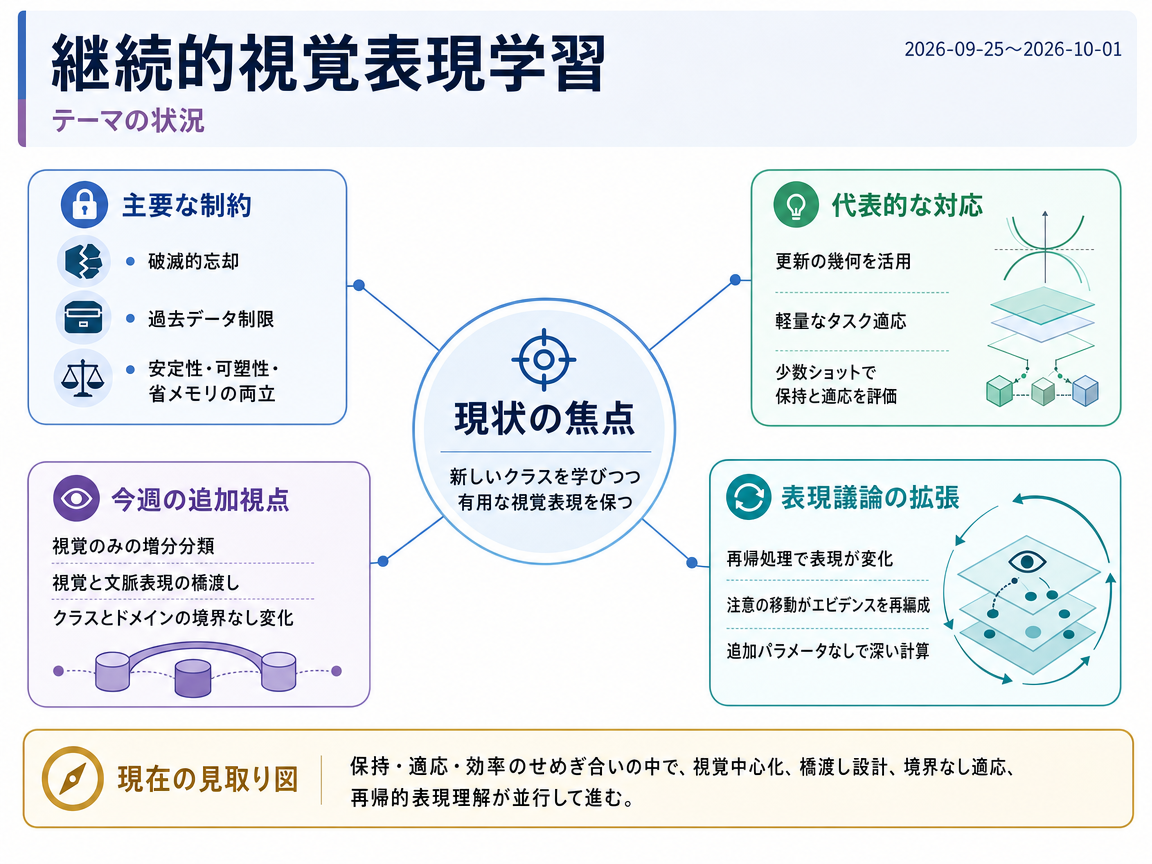
本テーマは、新しいクラスを学習しながら有用な視覚表現を保持することを中心とする。代表的な研究は、最適化の幾何、軽量なタスク固有適応、少数ショットにおける安定性と適応性のトレードオフに取り組んでいる。今週のエビデンスは、視覚のみのCLIP分類器、テキストと視覚のプロトタイプ橋渡し、境界のないクラスおよびドメインのシフトを加えた。また、再帰的な視覚言語研究が、共有パラメータ処理の下で表現がどのように変化するかへと議論を広げている。
テーマの状況
クラス増分学習は依然として、破滅的忘却、過去データへの限られたアクセス、そして安定性・可塑性・メモリ効率という相反する要求に制約されている。代表的な論文のIntroductionは相補的な対応策を示している。「Closing the Oracle Gap」は、先進的な増分手法の全履歴データオラクルにおける低損失の線形接続性を報告し、リプレイに依存しないFisher情報に基づく更新変換の動機付けとしている。タスク固有バッチ正規化は、共有特徴抽出器を保持しつつ小規模な正規化・分類モジュールを追加し、分布外検出を用いてタスクIDを推定する。少数ショット設定では、「A Bag of Tricks for Few-Shot Class-Incremental Learning」が、より強い埋め込み分離と選択的なエンコーダ調整を組み合わせ、精度だけでなく保持能力と新規クラスへの適応を評価している。
今週の補足的エビデンスは、2つの異なる視点を加える。「Visual Branch is What You Need for CLIP-based Class-Incremental Learning」は、テキスト分類器の重みと視覚的クラス分布の不整合を診断している。これが、視覚プロトタイプと、加法的十分統計量から構築される増分分類器の動機となっている。別途、「LoopVL: Recurrent Visual Intelligence」(2609.38426v1)は、視覚言語の結合状態に対する共有パラメータの再帰を研究し、後段のステップが視覚的エビデンスを再編成・再利用することを報告している。これは継続学習手法ではないが、表現に関する議論を空間的注意のダイナミクスや、追加パラメータなしでのより深いマルチモーダル計算へと広げている。
- A Bag of Tricks for Few-Shot Class-Incremental Learning
- Class Incremental Learning with Task-Specific Batch Normalization and Out-of-Distribution Detection
- Closing the Oracle Gap: Increment Vector Transformation for Class Incremental Learning
- Online Versatile Incremental Learning: Towards Class and Domain-Agnostic Adaptation at Any Time
- Visual Branch is What You Need for CLIP-based Class-Incremental Learning
- LoopVL: Recurrent Visual Intelligence
インフォグラフィクス(日本語)
今週の進展
Visual Branch is What You Need for CLIP-based Class-Incremental Learning <See Details on Fugu-MT>
VISは、デプロイ時にテキストブランチを除去し、完全に視覚空間で分類することで、CLIPベースのクラス増分学習を前進させた。 視覚プロトタイプと加法的十分統計量による閉形式更新により、診断されたテキストと視覚の分類器の不整合に対処する。
Hyperbolic Prototype Routing for Rehearsal-Free Class-Incremental Learning <See Details on Fugu-MT>
HyProは、リハーサル不要のクラス増分学習フレームワークを導入した。 過去の事例を保存しない設定に、双曲プロトタイプルーティングを持ち込んでいる。
Dual-Mode Low-Rank Learner with Bridge-Prototype Ensemble for Vision-Language Class-Incremental Learning <See Details on Fugu-MT>
DuLBEは、視覚言語クラス増分学習のために、デュアルモード低ランク学習とブリッジプロトタイプアンサンブルを組み合わせた。 視覚のみの分類とは異なり、低ランクのパラメータ効率を維持しながら、測地線ブリッジを通じて視覚プロトタイプとテキスト埋め込みを結び付ける。
Online Versatile Incremental Learning: Towards Class and Domain-Agnostic Adaptation at Any Time <See Details on Fugu-MT>
Online VILは、明示的なタスク境界なしにクラスと視覚ドメインが同時に変化する状況へと増分学習を拡張した。 TopFlowは、ドメイン非依存のフローマッチングと大域的トポロジー保存を組み合わせ、過去入力の明示的なメモリなしに知識を保持する。
LoopVL: Recurrent Visual Intelligence <See Details on Fugu-MT>
LoopVLは、共有された視覚言語状態の再帰的更新の下で、視覚表現がどのように変化するかを検証した。 ループ間で観察された注意のシフトは、計算中のエビデンス再利用を表現挙動を捉える視点として示唆している。
Decoupled and Distilled: Task-Adaptive LoRA-Teachers with Ensemble Knowledge Transfer for Few-Shot Class-Incremental Learning <See Details on Fugu-MT>
TALONは、少数ショットクラス増分学習のために、アンサンブル知識転移を伴うタスク適応型LoRA教師を導入した。 保持と適応に加えて、推論効率を明示的な設計目標としている。
今後の展望
今後の展望(要約)
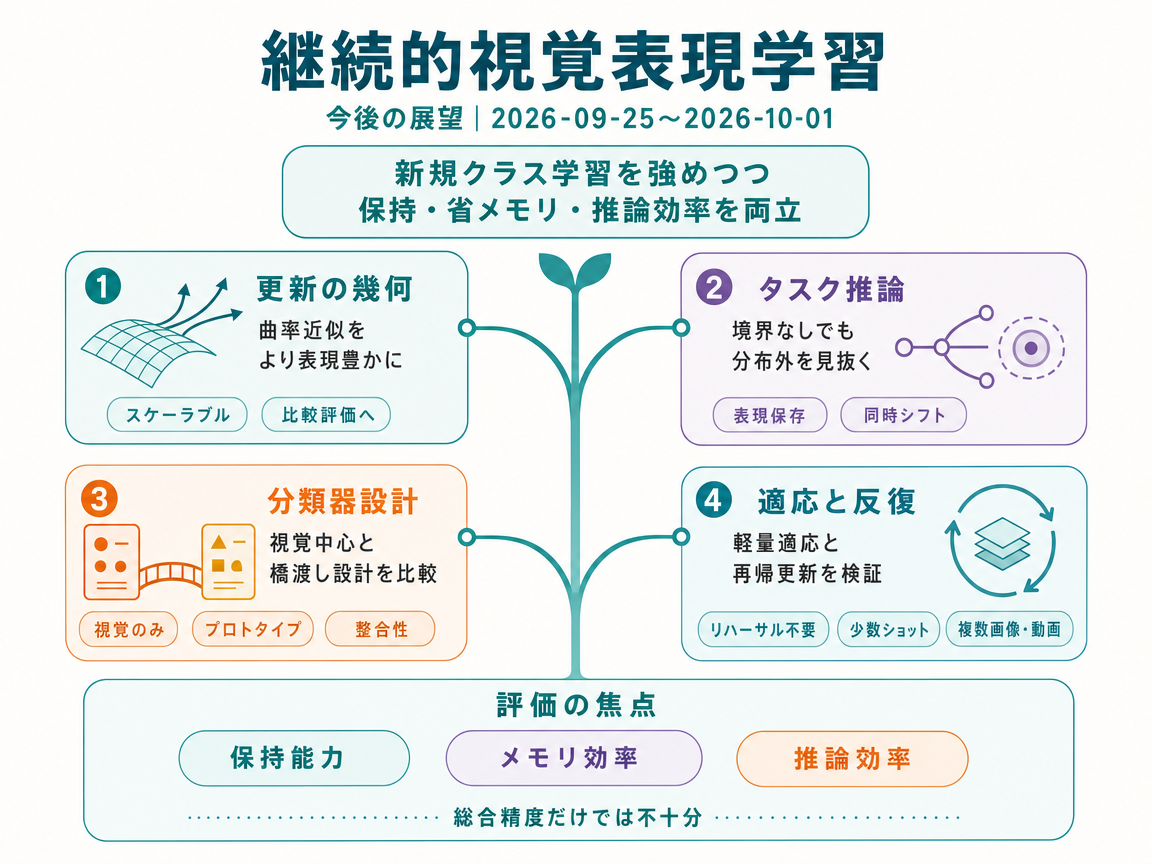
今後は、増分ベクトル変換に使う曲率近似を、表現力を高めながら大規模化できるようにする必要がある。また、タスクの振り分けに向けた分布外入力の検出を強化し、既存クラスと新規クラスの学習差を縮めることも重要である。比較実験では、更新方法、振り分け、分類器の調整が、既存知識の保持やメモリ・推論の制約を損なわずに新規クラスを改善できるかを個別に確かめるべきであり、平均正解率だけでは不十分である。クラスと入力条件が同時に変化し、タスクの境界も示されない場合、振り分けと特徴保持の評価はさらに難しくなる。一方、LoopVLは、条件をそろえた再帰処理との比較、入力に応じた反復回数、計算量をそろえた試験を提案している。学習後の監督範囲を広げれば反復的な推論を改善できる可能性があり、複数画像や動画への拡張は、固定された画像特徴を超えて証拠を統合できるかを試す機会になる。ただし、これらのマルチモーダル研究は今後の提案であり、継続学習における忘却への有効な対策として実証されたものではない。
インフォグラフィクス(日本語)
3年後を想定した動き
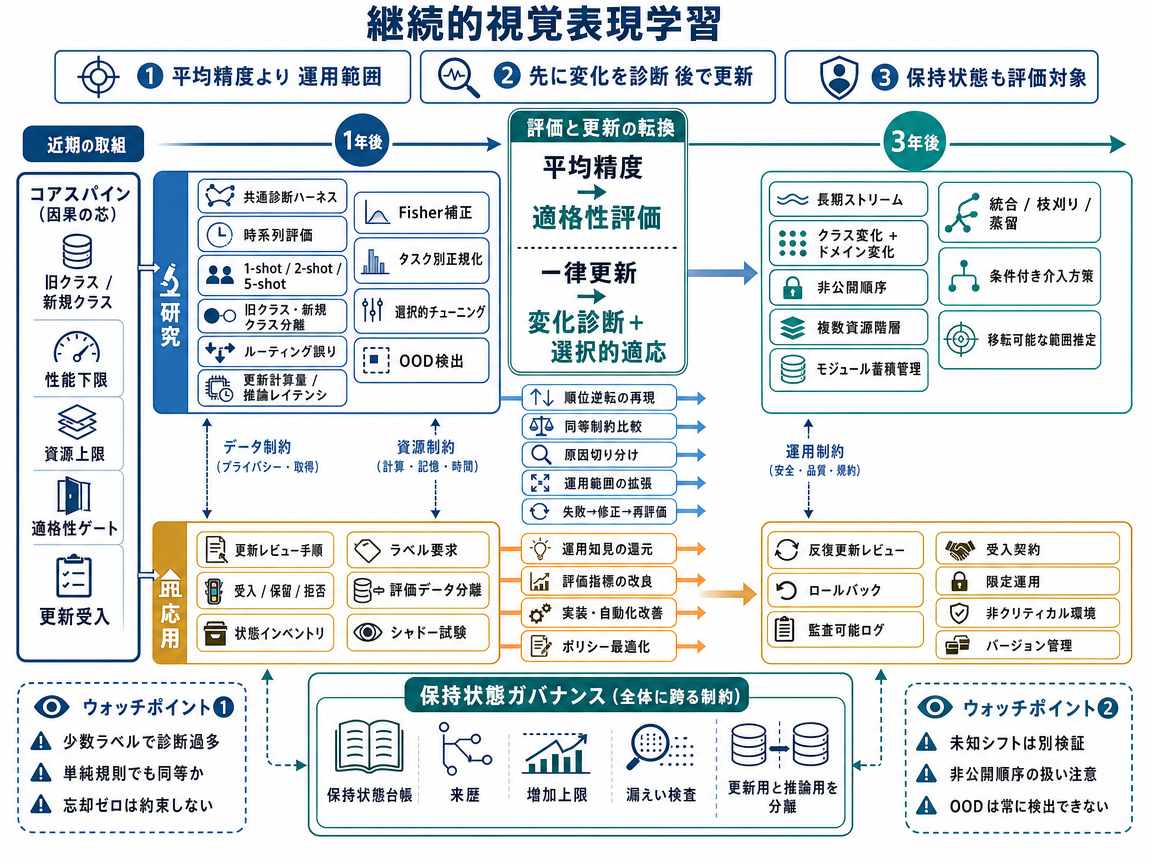
今後3年間で、このシナリオの中心は個々の学習手法の比較から、更新が事前に定めた性能要件と資源制約を満たすかを再現可能な形で試すことへ移る。1年目には、平均正解率だけで差を隠さず、既存クラスの保持と新規クラスの学習を分けて測る共通評価の枠組みを整える。振り分けの誤りと資源使用量も測定し、タスクが既知のセッションと、境界が示されない連続データを別々に評価する。その仕組みは電力網の供給能力試験に似ており、平均的に良いだけでなく、厳しい条件でも必要な機能を維持できる手法だけを合格とする。
想定する転換点は、結果を見る前に決めた要件を適用した後、少なくとも2種類の連続データ設定で手法の順位が大きく変わり、その変化を独立した2つの研究グループが再現することである。2年目には、より長いデータ列と、クラス変化と入力条件の変化が重なる試験を使い、手法を無計画に組み合わせるのではなく失敗原因を特定する。振り分けの失敗が多ければ未知入力の検出を強化し、新規クラスの学習が弱ければ対象を限定した追加調整を検討する。より精密な曲率推定については、増加する計算量に見合う効果を示す必要がある。実務チームは、現在の作業を直接変更しない試行環境で更新案を評価し、検査に失敗した場合は元に戻せるようにする。
3年目には、小さな保持要素でも更新のたびに蓄積し、大きな保存量と処理負荷になり得るため、改善が反復更新後も続くかが中心課題になる。順序を伏せたデータ列と独立に生成した変化を使い、既知のベンチマーク以外にも成果が広がるかを確認し、資源上限ごとに適した手法を明らかにする。試行が成功すれば、用途を限定した非重要システム向けに、継続更新を許容できる条件を記した再利用可能な受け入れ基準を作れる。重要な観測指標は、既存クラスと新規クラスの正解率を分け、保持される状態をすべて数えた結果が公開され、その測定によって手法の選択が変わることである。条件をそろえた試験でも順位が変わらなければ合格判定を導入する根拠は弱まり、こうしたベンチマークや医用画像を使った予行試験だけでは臨床上の有効性も証明できない。
今後3年間で、このシナリオは同じ適応手法を繰り返し使う方式から、変化の原因を診断してから更新を提案する制御機構へ重点を移す。1年目には、管理された画像データ列を使い、限られた正解ラベルで新しいクラスの出現と撮影条件の変化を区別できるかを試す。予測の確信度だけでは、この2種類の変化を混同する可能性がある。ここでの仕組みは二重制御であり、慎重に選んだ画像のラベルを問い合わせることで、直近の学習を助けながら、どの変化の説明が妥当かも判断する。公平な比較では、既存知識の保持と資源上限を同じにしたうえで、新規クラスの学習が改善する必要があり、無作為なラベル要求や単純な確信度規則も同じ厳密さで評価する。
2年目には、成功した制御機構をラベルが遅れて届く状況や複数の変化が重なる状況で試し、異なる特徴抽出器でも判断が通用するかを調べる。診断用のラベルによって誤った原因説明を見つけ、独立評価によって、過去の認識を不必要に損なわず新規クラスを改善した介入を特定する。その知見が移行できれば、不要な特徴抽出器の変更を減らし、限られたラベルと計算能力を難しい事例に振り向けられる。運用者は、監督用の待ち行列を通じてラベル要求と保留中の判断を管理する。特徴抽出器を更新すると保存済みの代表特徴が使う空間も変わるため、状態の版を記録し、互換性検査によって不整合な組み合わせを防ぐ。
3年目の目標は、用途を限定した非臨床の試行を支援する軽量な制御機構であり、変更の承認は運用者が行う。研究者は、診断と更新候補の評価にかかる費用を含めても、小さな制御機構と少数の更新方法で優位性が残るかを試す。試行が成功すれば、各介入の根拠を記録し、不確実性と資源消費を複数の視覚学習システムで確認できる共通インターフェースにつながる。主要な観測指標は、クラスの順序や変化の時期を変えても効果が残り、通常のラベル選択と単純な更新計画の組み合わせを上回ることである。診断がラベル上限を使いすぎる場合や効果が別の設定に移らない場合、現実的な成果は自律的な更新制御ではなく、用途を絞った診断支援になる。
今後3年間で、このシナリオでは既存知識の保持と新規クラスの学習の両立に加え、保持される状態の記録が継続学習の設計を強く左右するようになる。1年目には、古い画像を削除した後にも残る情報について、その由来、容量、増加量を記した台帳を作る。この記録では、将来の更新に必要な資源と、画像の分類だけに必要な資源を区別し、小さな実行用モデルの背後に隠れた依存関係を明らかにする。初期のプライバシー試験では、保持情報から学習データへの収録有無や画像の機微な内容を推測できるかを調べるが、攻撃が失敗しても安全性の証明にはならない。
この仕組みは開示によるフィードバック循環であり、状態の増加が見えると評価者から質問が生まれ、その質問が上限の明確な設計を促す。そうした設計が実用的であれば、導入側も更新要件をより明確に定められる。正解率と並べて台帳項目を示すベンチマークや、試行導入で同様の情報開示が求められることが、この循環が始まったことを示す初期の観測指標になる。2年目には、保持要素を小さくする方法を試し、既存知識の保持、振り分け精度、新規クラスの学習への影響を測る。再利用可能な監査ツールを使えば、各試行で保持状態の許容範囲を定め、保存量の上限と更新ごとの受け入れ試験を明示できる。
3年目には、単発の情報開示を超え、状態の累積的な増加と、既存クラスおよび新規クラスの性能を同時に検査する管理された更新工程へ進む。記録には変更を受け入れた理由を残し、タスク境界が不明なデータ列では定期的な状態保存と、問題のある更新を停止または取り消す手順を設ける。36か月ごろには、台帳の付録が参加する研究発表の場や少数の導入仕様書で一般化し、固定された保持状態の上限内で研究する動きを促す可能性がある。ただし、少数例から学ぶ場合の性能差は残り、保存量が同じでも、保持する情報の種類が違えばプライバシー上の危険性も同じとは限らない。共通の報告規則が導入側の更新基準と結び付けばこの流れは強まるが、導入側が採用しなければ、測定方法の改善だけが残り、設計方針までは変わらない可能性がある。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- A Bag of Tricks for Few-Shot Class-Incremental Learning - 著者: Shuvendu Roy, Chunjong Park, Aldi Fahrezi, Ali Etemad / <See Details on Fugu-MT> / ライセンス: CC-BY-SA-4.0
- Class Incremental Learning with Task-Specific Batch Normalization and Out-of-Distribution Detection - 著者: Xuchen Xie, Yiqiao Qiu, Run Lin, Weishi Zheng, Ruixuan Wang / <See Details on Fugu-MT> / ライセンス: CC-BY-SA-4.0
- Closing the Oracle Gap: Increment Vector Transformation for Class Incremental Learning - 著者: Zihuan Qiu, Yi Xu, Fanman Meng, Runtong Zhang, Linfeng Xu, Qingbo Wu, Hongliang Li / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Online Versatile Incremental Learning: Towards Class and Domain-Agnostic Adaptation at Any Time - 著者: Jae-Ho Lee, Min-Yeong Park, Jun-Yeong Moon, Jung Uk Kim, Gyeong-Moon Park / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- Visual Branch is What You Need for CLIP-based Class-Incremental Learning - 著者: Tao Hu, Zhen-Hao Xie, Jingcai Guo, De-Chuan Zhan, Da-Wei zhou / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- LoopVL: Recurrent Visual Intelligence - 著者: Zhe Qian, Ziyang Gong, Zhongxing Xu, Hehan Li, Zhonghua Wang, Fei Luo, Mingxuan Wang, Xue Yang, Shiwei liu, Yanbiao Ma, Junchi Yan, Jungong Han / <See Details on Fugu-MT> / ライセンス: CC BY 4.0