サマリー
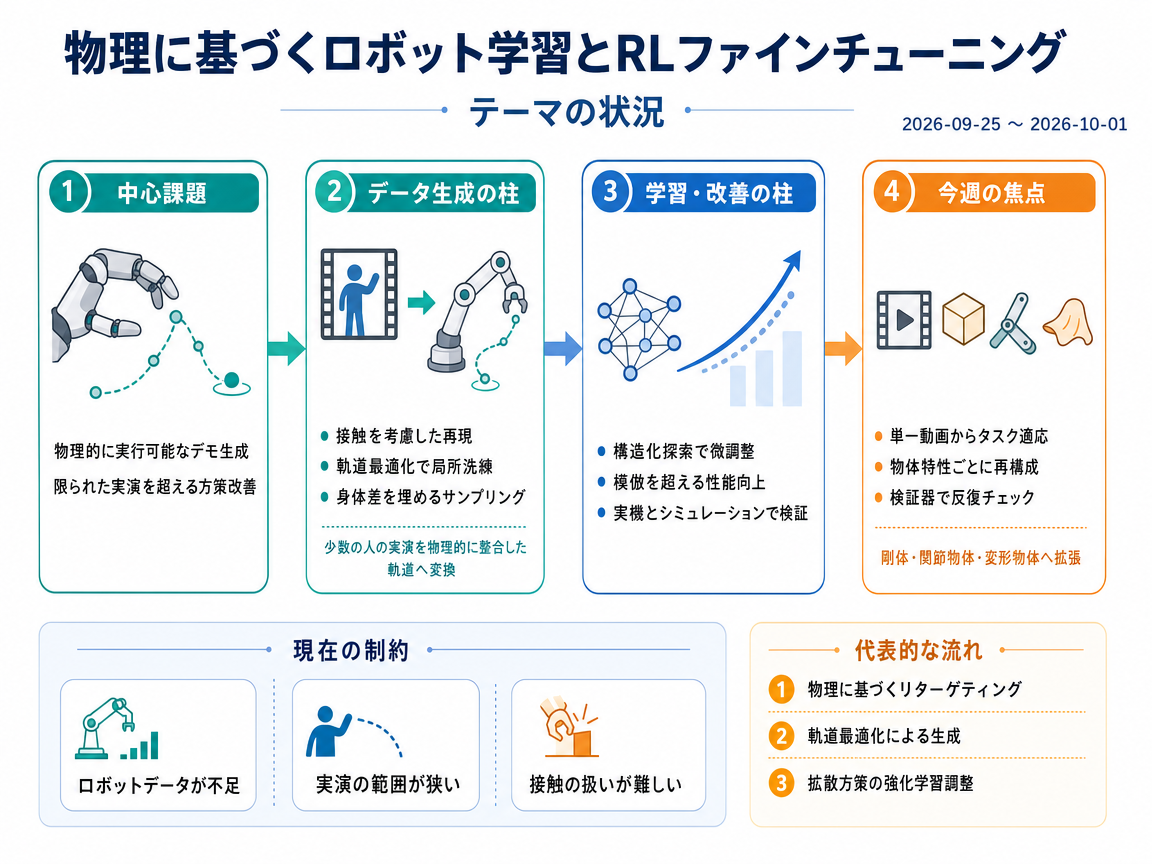
今週のテーマは、物理的に裏付けられたデモンストレーション生成と強化学習によるファインチューニングを結び付け、ロボットデータの不足とデモンストレーションの限られたカバレッジという課題に取り組むものである。DexAgentによる今週の成果は、単一の人間動画からのタスク適応的かつ検証誘導型の軌道生成を新たに加える。これは、接触を考慮したリターゲティング、軌道最適化、構造化された方策探索に関する先行研究を基盤としている。
テーマの状況
代表的な論文のIntroductionは、相互に関連する2つのボトルネックを指摘している。1つ目は、接触の多いマニピュレーションのために、スケーラブルで動力学的に実行可能なデモンストレーションを得ることである。2つ目は、それらのデモンストレーションのカバレッジと品質を超えて方策を改善することである。SPIDERは、段階的に緩和される仮想接触ガイダンスを伴うシミュレーションベースのサンプリングを用いて、人間とロボットの身体性の違いを埋める。Physics-Driven Data Generation for Contact-Rich Manipulation via Trajectory Optimizationは、少数の人間のデモンストレーションを大域的なガイダンスとして用い、それらを局所的に洗練して、異なる身体性や物理パラメータにわたって物理的に整合した軌道を生成する。Diffusion Policy Policy Optimizationは、拡散のデノイジングをMDPとして扱うことで学習側の課題に取り組む。これにより構造化された探索を伴う方策勾配ファインチューニングが可能となり、シミュレーションと実機の両方で評価されている。
DexAgent(2609.35318v1)による今週の成果は、データ生成の方向性を、剛体・関節物体・変形物体に対するタスク適応的なワークフローへと拡張する。そのIntroductionでは、物体特性に応じたシミュレーション再構成、サブゴール依存の動作生成、反復的な物理的妥当性検証が説明されている。新たに開発されたスキルと検証器は、動画をまたいで再利用できるよう保持される。代表的な研究と合わせると、これは2つの目標を示している。すなわち、デモンストレーションの転移を物理的に信頼でき適応可能なものにすること、そしてRLファインチューニングを用いて模倣を超えて性能を向上させることである。
- Diffusion Policy Policy Optimization
- Physics-Driven Data Generation for Contact-Rich Manipulation via Trajectory Optimization
- SPIDER: Scalable Physics-Informed Dexterous Retargeting
- DexAgent: An Agentic Human2Sim2Robot Framework for Dexterous Manipulation with Self-Evolving Tool Library
インフォグラフィクス(日本語)
今週の進展
DexPolicy: Scheduled Exploration for Trajectory-Guided Dexterous Manipulation <See Details on Fugu-MT>
DexPolicyは、器用なマニピュレーションにおける強化学習の探索スケールの明示的な制御を研究している。 ベースラインのPPOが500万ステップ後も初期の行動ノイズ付近で終わることを動機として、PPO、クリティック不要のGRPOによる継続学習、フローを用いないPPO設定を比較している。
DexWeave: Learning Dexterous Humanoid Loco-Manipulation from Human Demonstrations <See Details on Fugu-MT>
DexWeaveは、人間のデモンストレーションからの学習を、器用なヒューマノイドのロコマニピュレーションへと拡張する。 相互作用整合的な動作と解剖学を考慮した全身方策学習を組み合わせ、その方策を実機のUnitree G1ヒューマノイドに展開している。
PrefPI: Preference-Guided Steering into Out-of-Distribution Behaviors <See Details on Fugu-MT>
PrefPIは、反復的な選好誘導型ステアリングにより、事前学習済みの生成型ロボット方策を改善する。 デモンストレーションの模倣を超えて選好による教師信号を加え、選好ラベル付き軌道わずか150本で実機上の新たな挙動に到達している。
DexAgent: An Agentic Human2Sim2Robot Framework for Dexterous Manipulation with Self-Evolving Tool Library <See Details on Fugu-MT>
DexAgentは、シミュレーション再構成と軌道最適化により、単一の人間動画を物理的に裏付けられたロボット学習用軌道へと変換する。 検証器誘導型の洗練と再利用可能なツールライブラリを加えており、そのデータで学習した方策は11の実世界タスクにおいてベースラインより3.5倍高い成功率を達成している。
DexTaG: Tactile-as-Guidance in Reinforcement Learning for Dexterous Manipulation <See Details on Fugu-MT>
DexTaGは、器用なマニピュレーションのための触覚誘導型強化学習フレームワークを導入する。 触覚ガイダンスを用いて、グローブで取得した人間の動作をロボットハンドで直接実行することを妨げる運動学的ギャップに対処している。
FoLD: Force-Informed Learning for Dexterous Articulated Object Manipulation <See Details on Fugu-MT>
FoLDは、器用な関節物体マニピュレーションの学習に力の情報を取り入れる。 人間のデモンストレーションとロボットの現在の相互作用状態から補償的な力場を計算し、タスクや身体性をまたいでベースラインを上回っている。
今後の展望
今後の展望(要約)
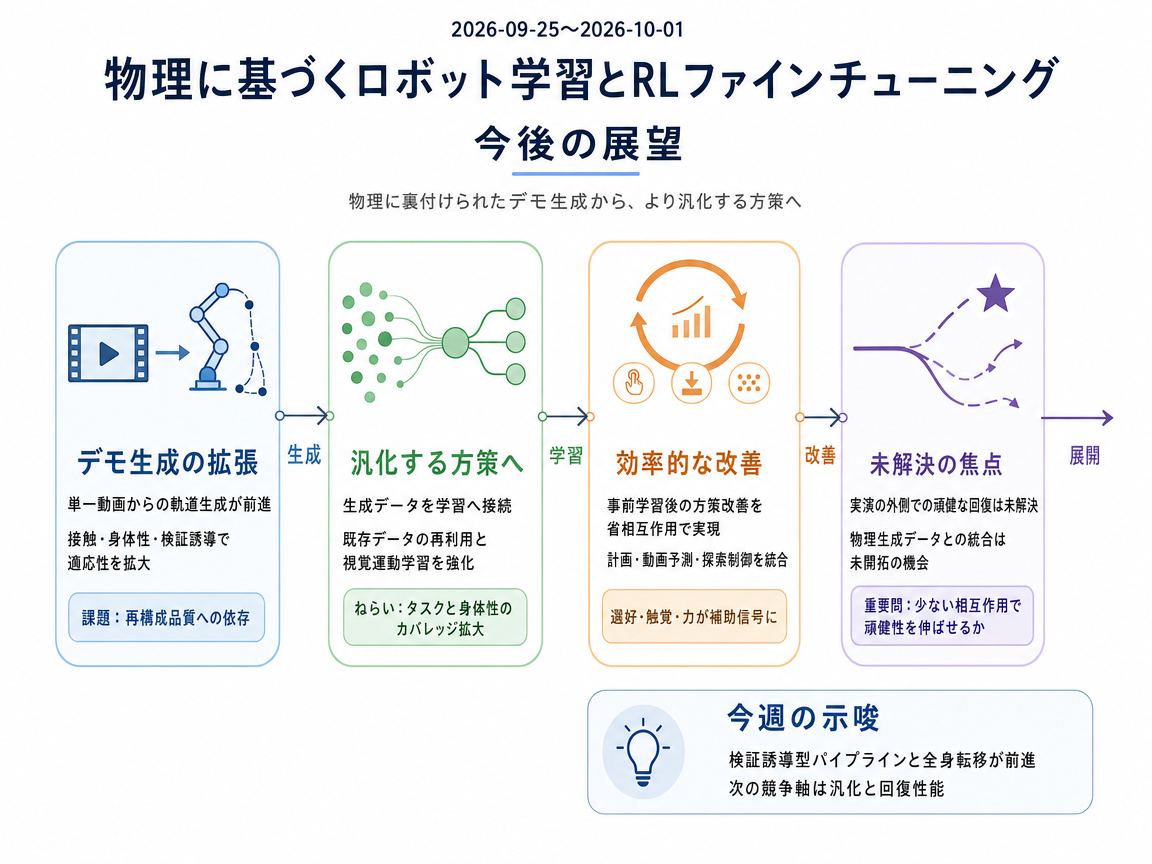
次の焦点は、物理法則に基づいて生成した実演を、異なる作業やロボット機体にも一般化できる方策へ結び付けることである。SPIDERは再構成の品質に左右される一方、軌道最適化の研究では、過去のデータの再利用、合成画像による学習、実演範囲を超えた計画能力の改善が提案されている。DexAgentとDexWeaveは対応範囲を広げるが、失敗からの確実な回復は未解決である。DPPOは事前学習後に計画や動画予測を利用して、必要なロボット操作回数を減らす方法を提案しているが、視覚を使った実機評価はさらに必要である。今週取り上げた探索制御とフィードバック誘導の手法も、方策を改善する補完的な道筋となる。これらが少ない操作回数で回復能力を高め、物理シミュレーションで生成したデータと有効に組み合わせられるかは、今後の研究課題である。
インフォグラフィクス(日本語)
3年後を想定した動き
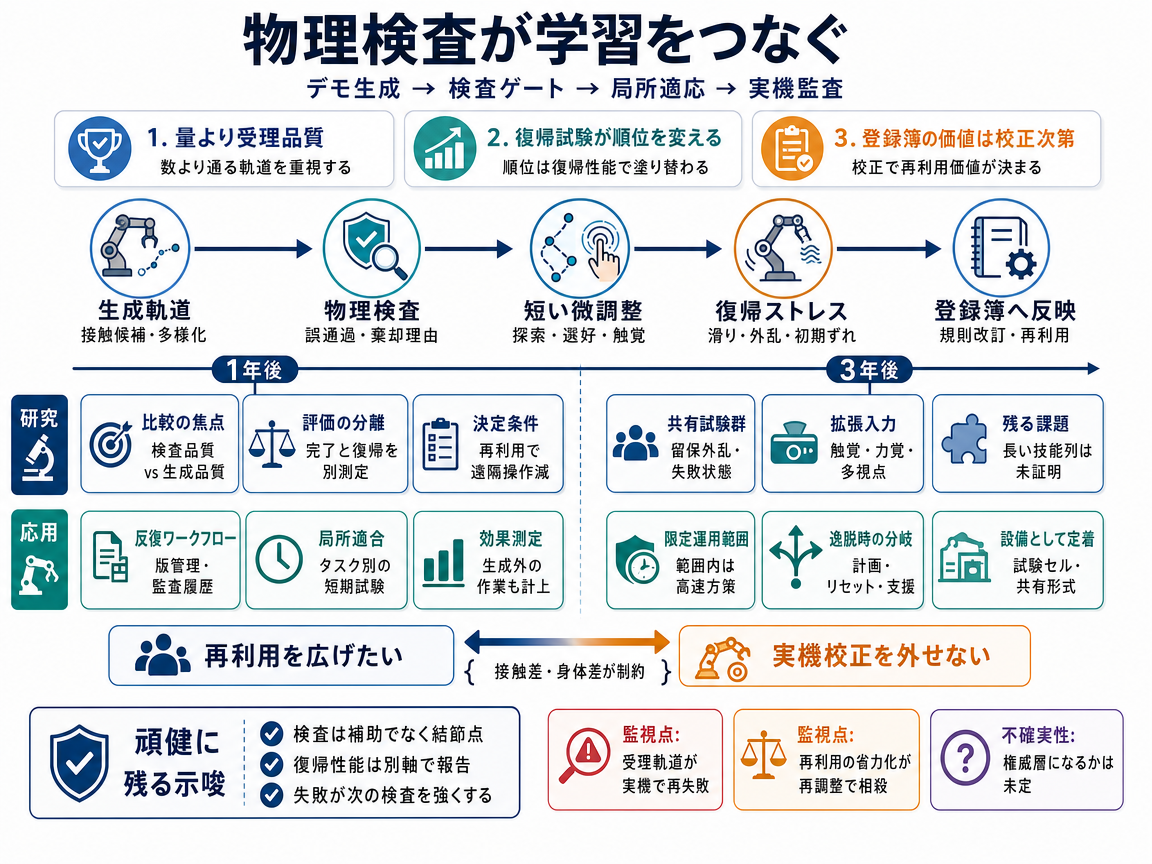
3年間でこのシナリオは、物理的に実行可能な実演の生成から、検査済みの学習データと実機で確認した方策を結ぶ再利用可能な流れへ進む。初年度には、実機試験に進む前にシミュレーション上の動作データ群を検査する。これは、資源を投入する前に品質を確認する種子認証の考え方に近い。研究者は合格したデータ群で方策を学習し、フィードバック手法を一つずつ試す。実機での失敗を学習データまでさかのぼって調べられるよう、十分な履歴も残す。最初の判断基準は、再利用した技能や検査によって、実機性能を落とさずに新たな人手による実演を減らせるかである。乱れた初期状態からの回復性能は、通常の作業成功率とは分けて測定する。
2年目には、過去の動作データをロボットの身体構造と制御方式に合わせて調整し、この流れに取り込める可能性がある。ただし、別のロボットには固有の試験が引き続き必要になる。計画や動画予測は実演条件の少し外側を補い、高速な学習済み方策は十分に試験された範囲内を担当する。接触が重要な作業では接触センサーが役立つが、計画の遅延と実機操作回数を確認しなければ、作業負担が本当に減るかは判断できない。
3年目には、研究室が検査済みデータ群、再利用可能な検査、関連する作業群向けの方策を小規模な登録簿として管理できるようになる。実機での失敗から検査の弱点が分かれば、次の学習と試験で同じ問題を繰り返す前に、類似の不良軌道を除外できる。合成画像による視覚学習は、精密な接触動作が実機でも維持されると確認できた場合に限って導入する。選ばれた人型ロボットの技能も蓄積し得るが、それだけで長い行動列を確実に実行できるとは限らない。
主な観測点は、生成速度や登録数ではなく、実機性能を保ちながら適応に必要な労力が減るかである。合格した軌道で実機失敗が繰り返されれば、検査の仕組みへの信頼は損なわれる。手作業による再構成やシミュレーター調整が削減分を打ち消す場合も同様である。既存の実演作成手順がより少ない総労力で同等に機能するなら、この検査段階を追加する利点は小さい。
3年間でこのシナリオの焦点は、慣れた作業の完了から、実行中の問題から回復する能力へ移る。物理法則に基づく実演生成は、実行可能な動作を提供する。その後の学習では、制御された探索とより豊かなフィードバックによって方策を改善する。これまでの研究は、利用可能な軌道の供給を増やし、一部では実機への移行も示した。しかし、実演状態から大きく外れた状況での確実な回復はまだ実現していない。
提案される仕組みの中心は、評価方法の変更である。研究者は、滑り、予期しない接触、未知の初期状態が起きた後に、ロボットが制御を取り戻せるかを試す。主な観測点は、慣れた作業の完了率だけでなく、こうした外乱の下で回復性能が高まるかである。再利用可能な物理的妥当性の検査は、データ生成と方策改善を結び付ける可能性がある。
ただし、提示された情報だけでは、この組み合わせが実際に機能するとは確認できない。今週の根拠は編集された研究要約であり、年ごとの進展を示す実証結果は含まれていない。このため、実演生成から回復能力の改善までを一体化した信頼できる流れは、3年後の確定的な成果ではなく、引き続き研究の方向性として捉えるべきである。
3年間でこのシナリオは、生成された実演の受け入れ手順が補助的な道具にとどまらず、ロボット学習を組織する中心層になるかを問う。初年度には、無効なのに検査を通過した軌道を誤受け入れとして測定し、実機結果と比較する。これにより、検証による効果を、データや再構成の改善による効果と区別する。研究室は各軌道が合格した理由を記録し、実演範囲外での回復能力も試験する。さらに、誤りの検出力を弱めずに、検査を別の物体やロボットへ移せるかを調べる。
2年目には、局所的に成功した検査が共有基盤へ発展する可能性がある。研究グループは失敗例を提供し、機体の提供者は特定のロボット向けの較正手順を整備する。この仕組みは半導体製造の検査に似ており、生成量が増えるほど、一貫した受け入れ基準の価値が高まる。利用者がすべての生成例を毎回詳しく調べることは難しいためである。参加者が失敗例を持ち寄れば、検査が改善され、検証作業の重複を減らせる可能性がある。ただし、この循環には、明示された実機較正の下で誤り率を一定範囲に抑える必要がある。試験対象が剛体以外へ広がるほど、その条件は重要になるが、共通の許容上限はまだ示されていない。
3年目には、交換可能な生成器が候補軌道を作り、共有検証層が方策学習に使うデータを受け入れる形が考えられる。定義済みの作業群向けに監査済み軌道を提供する仕組みや、検査記録を求める評価基盤も現れ得る。研究では、同じ学習条件の下で実機回復が改善するかを調べ、別の構成要素による効果を検証の成果と取り違えないようにする。適応の高速化が期待できるのは、較正試験で既に扱われた機体や技能であり、任意の新しい作業ではない。
主な観測点は、受け入れ率や検査資産の数ではなく、繰り返しの検証作業を減らしながら実機での回復性能を高められるかである。物理的に実行可能であることだけでは、回復能力を証明できない。シミュレーターで承認された接触も、実機では失敗する可能性がある。同じ条件で比較した研究に優位性がなければ、検証は局所的には有用でも、分野全体の共通受け入れ層にはならない。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- Diffusion Policy Policy Optimization - 著者: Allen Z. Ren, Justin Lidard, Lars L. Ankile, Anthony Simeonov, Pulkit Agrawal, Anirudha Majumdar, Benjamin Burchfiel, Hongkai Dai, Max Simchowitz / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Physics-Driven Data Generation for Contact-Rich Manipulation via Trajectory Optimization - 著者: Lujie Yang, H. J. Terry Suh, Tong Zhao, Bernhard Paus Graesdal, Tarik Kelestemur, Jiuguang Wang, Tao Pang, Russ Tedrake / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- SPIDER: Scalable Physics-Informed Dexterous Retargeting - 著者: Chaoyi Pan, Changhao Wang, Haozhi Qi, Zixi Liu, Homanga Bharadhwaj, Akash Sharma, Tingfan Wu, Guanya Shi, Jitendra Malik, Francois Hogan / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- DexAgent: An Agentic Human2Sim2Robot Framework for Dexterous Manipulation with Self-Evolving Tool Library - 著者: Youhui Wang, Yunzhu Li, Li Fei-Fei, Jiajun Wu, Huang Huang / <See Details on Fugu-MT> / ライセンス: CC BY 4.0