サマリー
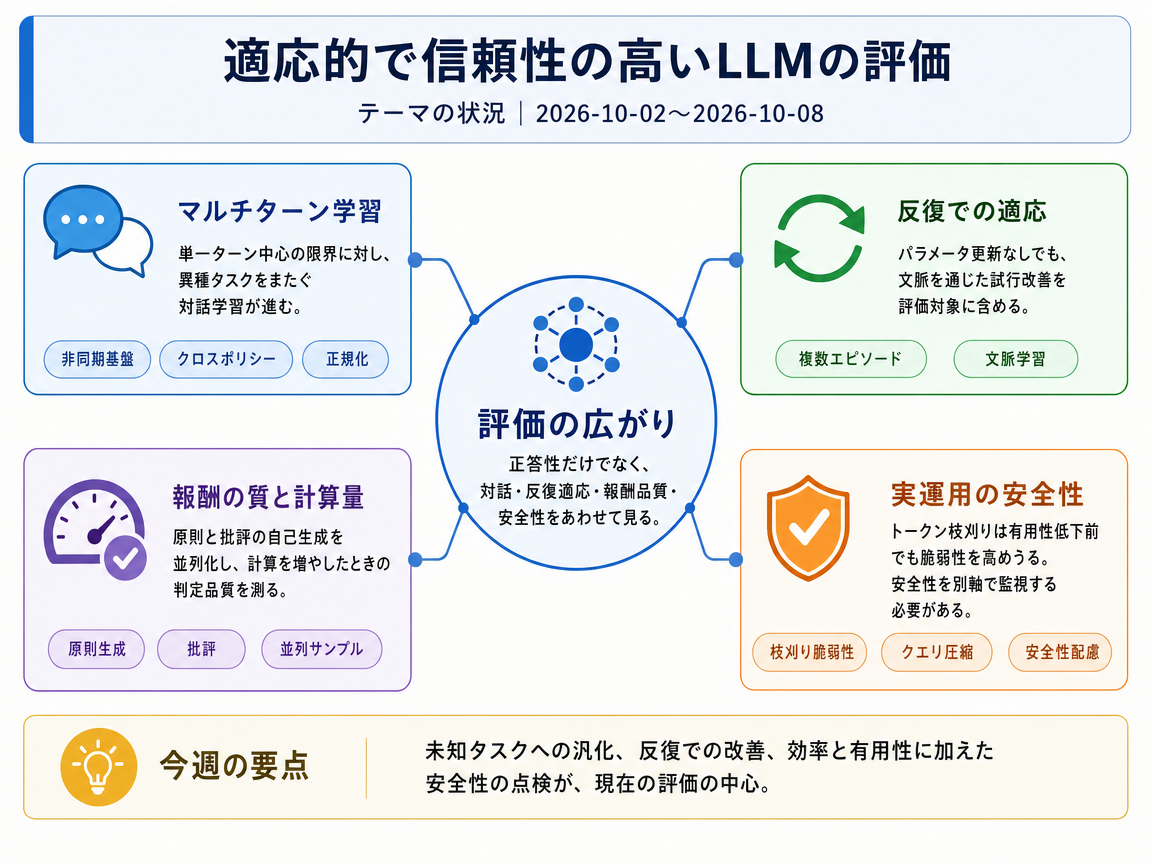
代表的な研究は、LLMの評価を単一ターンの正答性から、マルチタスクの対話、反復試行を通じた学習、推論計算量を増やした際の報酬品質へと広げている。今週の追加的な知見は、この信頼性への関心をマルチモーダルな実運用へと拡張し、トークン枝刈りによる高速化が、タスク有用性が低下する前の段階でもジェイルブレイク脆弱性を高めうることを報告している。
テーマの状況
代表的な論文のIntroductionは、汎用LLMエージェントの構築における相補的な限界を指摘している。LLM向けの強化学習(RL)は、主に単一ターン・単一タスクの設定に限られてきた。実運用されたモデルが継続的な対話を通じて改善することはまれである。一般領域の報酬には、数学やコーディングの一部に存在するような明示的な正しさの検証が欠けている。AgentRLは、非同期インフラ、クロスポリシーサンプリング、タスクアドバンテージ正規化によって、異種混在のマルチターン学習に取り組む。Orbitは、マルチエピソードのメタRLを用い、パラメータ更新なしにコンテキストのみで反復試行にわたる適応を学習させる。Inference-Time Scaling for Generalist Reward Modelingは報酬側の方向性を加え、自己生成した原則と批評を並列サンプリングと組み合わせることで判定を改善する。これらの論文は総じて、未知タスクへの汎化、試行を重ねることによる改善、報酬品質を計算コストと併せて評価する必要性を示している。
今週の Understanding and Mitigating Token-Pruning-Induced Vulnerabilities in VLMs(2610.09703v1)の知見は、実運用時の安全性という観点を加える。同論文のIntroductionによれば、いくつかのトークン枝刈り手法はタスク有用性が低下する前にマルチモーダル・ジェイルブレイクへの脆弱性を高める一方、クエリベースの圧縮は安全性を向上させうる。提案手法のSafety-Aware Pruningは、無害な視覚コンテキストを復元し、注意を再配分する。検証された設定では、効率と有用性を維持しつつ攻撃成功率を低減したと報告されている。これは、適応能力を重視する代表的研究を補完し、効率やタスク精度の測定だけでは信頼性の欠陥を見逃しうることを示している。
- Inference-Time Scaling for Generalist Reward Modeling
- AgentRL: Scaling Agentic Reinforcement Learning with a Multi-Turn, Multi-Task Framework
- Scaling In-Context Online Learning Capability of LLMs via Cross-Episode Meta-RL
- Understanding and Mitigating Token-Pruning-Induced Vulnerabilities in VLMs
インフォグラフィクス(日本語)
今週の進展
MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement <See Details on Fugu-MT>
MiMo-V2.6は、オムニモーダルなモデルファミリー向けに非同期RLの計算規模を拡大し、最大100万トークンのコンテキストを扱う。 MoEルーターを固定し、報酬ハッキングに対する多層的な防御を加えることで、大規模学習を安定化させている。
Measuring and Mitigating Solution Mode Collapse in RLVR <See Details on Fugu-MT>
本研究は、RLVRによる事後学習が、精度が向上する一方で確率を少数の解法モードに集中させうることを示している。 提案手法Re:Maxは、検出されたモードごとに検証済みの例を1つリプレイバッファに保存し、保存されたモード全体にわたって均等に学習する。
Long-MDR: Long-Context Reinforcement Learning for Multimodal Deep-Research Agents <See Details on Fugu-MT>
Long-MDRは、マルチターンのエージェント型RLをマルチモーダルなディープリサーチへと拡張し、128kのコンテキストと75ターンのツール対話で学習する。 RLで学習した9Bモデルは、比較対象の7B〜9Bエージェントの中で6つのベンチマークのうち5つで首位となった。
Which Preferences to Train On? End-to-End Multi-Objective Alignment with an Adversarial Preference Distribution <See Details on Fugu-MT>
MAESTROは、多目的アラインメントを選好分布上のミニマックス問題として定式化し、プロンプト条件付きの単一ポリシーをRLでエンドツーエンドに学習する。 最大3つの目的において、1回の学習で大半のタスクにおいて最良のフロンティアに到達し、学習コストは比較手法の中で最も低い。
今後の展望
今後の展望(要約)
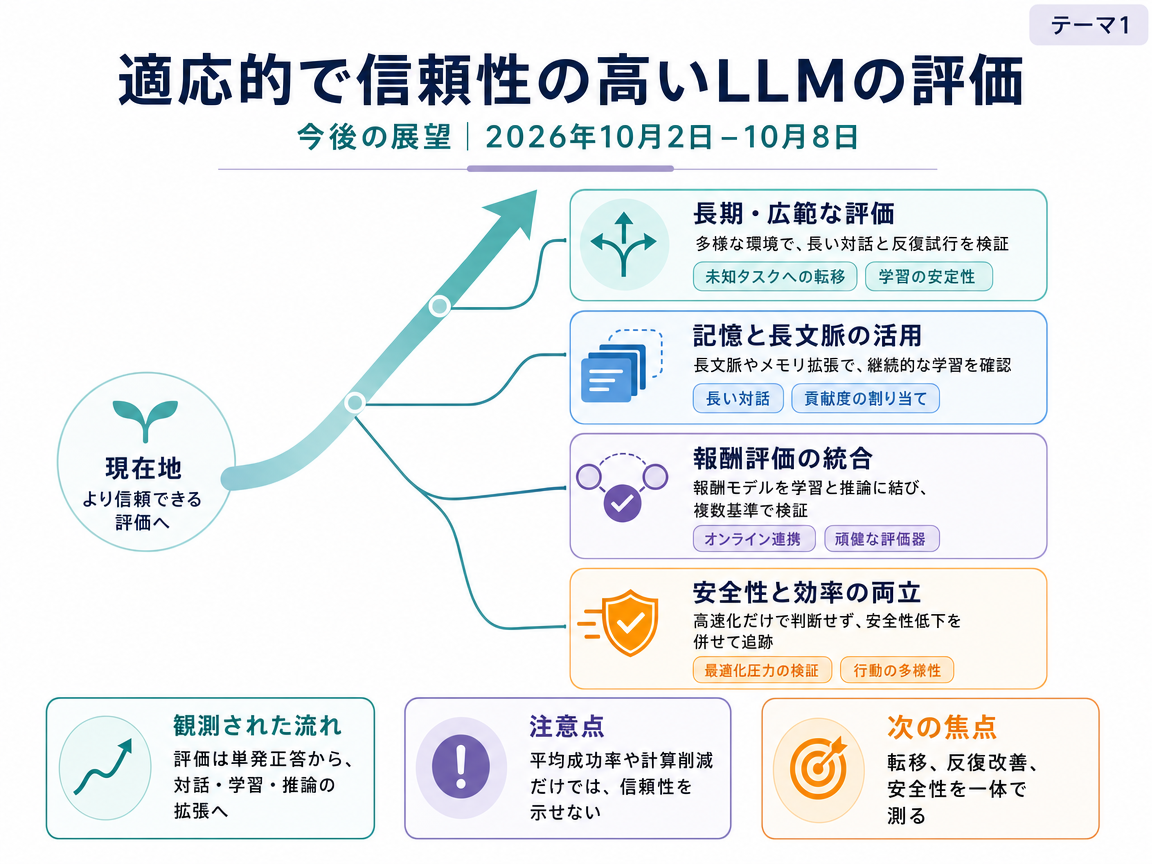
今後は、より多様な訓練環境に加え、記憶と結果への寄与を適切に割り当てる仕組みを整え、長い対話の中で適応するエージェントを幅広く評価する方向が重要になる。100万トークン規模のRL訓練や75ターンに及ぶマルチモーダル研究は、この方向を具体化しているが、対話が長いだけでは信頼できる学習の証拠にはならない。評価では、未知の課題への転移と試行を重ねた際の改善を測り、同時に訓練の安定性と計算コストを追跡する必要がある。また、正解率の向上によって、有用な解法の多様性が失われていないかも確認すべきである。もう一つの方向は、報酬の評価をエージェントの訓練や推論とより密接に結び付け、オンラインRLとオフライン評価を相互に活用することだ。報酬信号は複数の基準で検証し、最適化が進んでも妥当性を保つかを調べなければならない。トークン削減では通常の課題性能より先にマルチモーダル安全性が低下する可能性があるため、高得点や計算量の削減だけを信頼性の証拠とせず、安全性と効率を一体で評価する必要がある。
インフォグラフィクス(日本語)
3年後を想定した動き
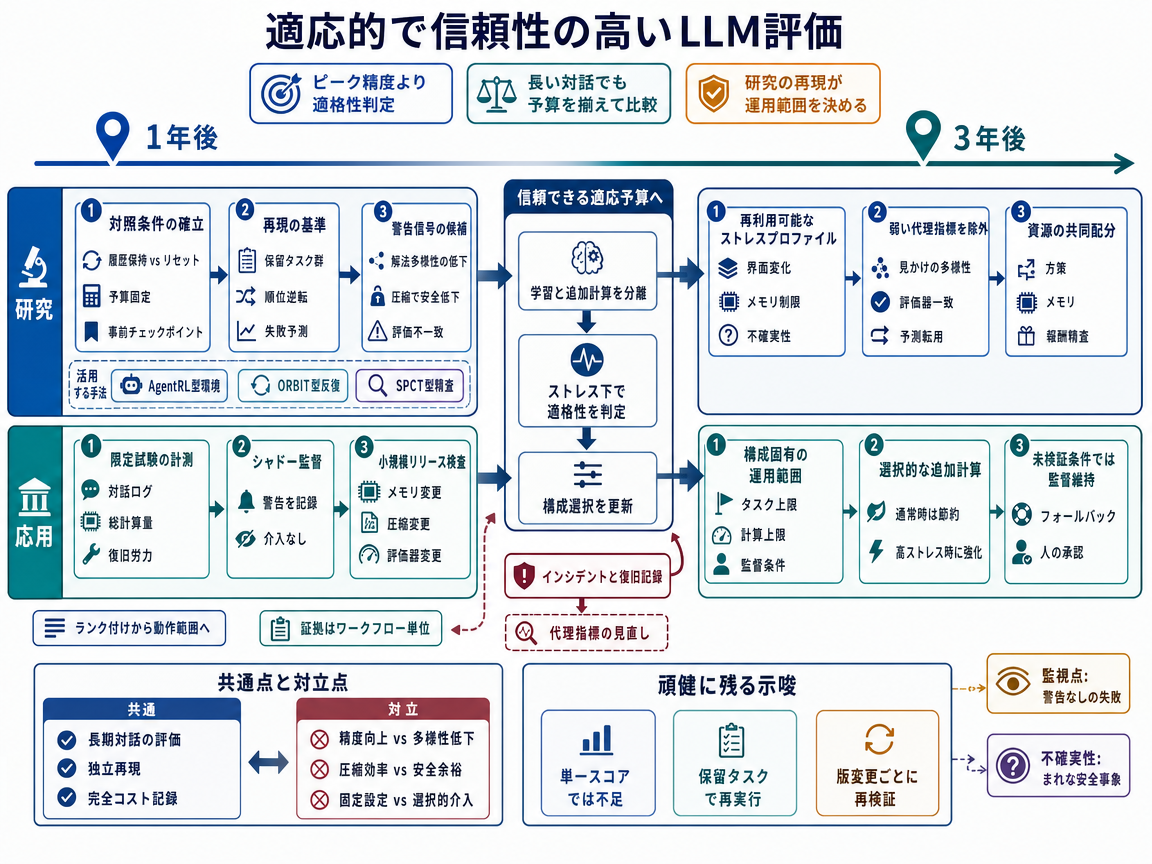
今後3年間で、この経路はエージェント評価の中心を、目立つ成功率から、明確に定めた条件内で確実に適応できるという証拠へ移す。仕組みは、厳しい運転条件で電力システムを試験する考え方に似ており、表面的な能力よりも、条件が悪化したときに何が役立ち続けるかを重視する。1年目には、総計算量をそろえた上で、対話履歴を保持した場合、初期化した場合、順序を変えた場合の未知課題への再試行を比較する。これにより、実際の学習と、単に試行回数を増やした効果を区別しやすくなる。監督付きの試験運用では、失敗の内容と回復に必要な手間も記録する。
2年目へ進む条件は、少なくとも二つの未知の課題群で独立試験を行い、その結果がシステムの順位を変え、単発の得点よりも試験運用中の失敗を正確に予測することである。良い結果が得られれば、加えた擾乱や構成上の限界を、結果の不確実性とともに示す再利用可能なストレス特性を作れる。開発者は特定の弱点を修正し、未使用のテストを再実行できるため、単に文脈を拡大するのではなく、証拠に基づいて改善する循環が生まれる。記憶や圧縮方式を変更した場合は、関係するリリース検査を再実施する。これにより、過去の結果がすべての新構成に当てはまると決めつけずに、重複する試験を減らせる。
3年目には、こうした統制された検査が実際の作業での失敗も予測できるかを、障害と回復の記録を使って確かめ、役に立たない指標を除外する。別の解法は、最初の方法が失敗した場合や操作方法が変わった場合の回復に役立つときに限り、有用な多様性とみなす。予測が成立する範囲では、追加の記憶や強い報酬評価を必要な場所だけに使い、検証済みの条件内でより長い作業を認められる。重要な監視の手掛かりは、独立再現された順位変化に続いて構成別のリリース検査を行い、それが試験運用の結果を改善することである。同じ計算量で見かけ上の学習が消える場合や、通常の正解率だけで同程度に予測できる場合、この経路の根拠は弱まるため、未知の条件では引き続き監督が必要になる。
この経路では、長時間動作するエージェントに能動的な監督機構を組み合わせ、性能悪化の兆候を監視して失敗前に対応する。制御工学から取り入れた実行時保証の考え方であり、公開前の試験だけに頼らず、利用中のシステムを継続的に確認する。1年目には動作条件を変え、評価器間の不一致や解法の多様性の低下が、未知課題で有効な警告になるかを調べる。初期の試験運用では提案を記録するだけにとどめ、その後、文脈の復元や独立した再検討の要求など、元に戻せる対応を警告時に試す。
次段階へ進む条件は、総計算量をそろえた上で、少なくとも二つの未知の課題群における事前定義済みの違反を減らし、試行間の学習も損なわないことである。無作為な介入と固定的で慎重な設定を比較対象にし、すべての課題を常に厳しく調べる方法より監督機構に価値があるかを確かめる。2年目には、記憶の変更で修復できる失敗と、作業を続ける前に停止や人間の確認が必要な失敗を区別する。成功した介入については、独立検証された回復記録を作り、警告の精度向上に用いる。同時に、この仕組みが人間の確認担当者へ作業を移しているだけではないかも測定する。
3年目には、版が管理されたエージェントと監督機構の組を評価対象とし、有用な適応が実証された条件に応じて権限を設定できる。記憶機構や報酬モデルを変更した場合は対象を絞って再試験し、以前の証拠がどこまで有効か、再調整にどれだけ費用がかかるかを調べる。回復記録から、有用な探索を保ちながら過度な中断や確認費用を避けられると分かれば、範囲を限定した上で、より広い作業を許可できる。重要な監視の手掛かりは、拒否や作業放棄による見かけ上の改善ではなく、総費用をそろえた条件で違反の減少が独立に確認されることである。警告なしに失敗が起きる場合や固定的な厳格監視の方が優れる場合、この経路の根拠は弱まり、取り消せない操作には慎重な権限設定と人間による上書きが引き続き必要となる。
この経路では、圧縮や適応によって変更されたエージェントに、元のシステムの信頼性をそのまま引き継がせず、自ら信頼性を実証するよう求める。仕組みは、さまざまな条件で車両の排出量を調べる試験に似ており、固定された実験室の外で変更版と元のシステムを比較し、許容できる差を定める。1年目には、追加の計算量を考慮しながら、攻撃への耐性、解法の多様性、未知課題での学習を一対一で比較する。初期報告は提供者の審査に利用できるが、決定的な段階は、大規模な利用組織が数値基準を実際に適用し、独立機関も妥当な費用で同等の判定を出せるようになることである。元のシステム自体が安全でない場合は比較が誤解を招くため、絶対的な最低安全基準と不確実性の推定も必要になる。当初は、完全な拘束制度よりも限定的な試験運用の方が現実的である。
この要件が実用化できれば、2年目には試験を長い作業へ広げ、自動評価器の判断を独立に検証できる成果と照合する。提供者は合格した構成を正確に特定し、許可を得て選択した運用履歴を再現することで、承認後に蓄積した文脈が動作を変えないかを確かめる。利用組織の要件は、測定された弱点を提供者が修正する動機になる。共有試験環境は重複した準備作業を減らし、試験機関が失敗記録に基づいて基準値を改善する助けになる。
3年目には、対象となる派生版を更新するたびに自動リリース検査を行い、既知の課題一覧だけでなく、新しいストレス条件も加えられる。研究では、この検査が性能低下を効率よく検出できるかを調べ、適応手法には必要な能力を維持した証拠を求める。望ましい成果は、すべての派生システムが信頼できるという一般論ではなく、指定された作業に使える実用的なリリース・監視ゲートである。重要な監視の手掛かりは、比較条項が実際に適用され、独立試験の判断が一致し、基準を満たさない派生版の却下が記録されることである。判断の不一致が続けばこの仕組みの根拠は弱まり、自動評価器には合格しても検証可能な課題で失敗する場合は、より確実に成果を確認できる作業に用途を限定する必要がある。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- Inference-Time Scaling for Generalist Reward Modeling - 著者: Zijun Liu, Peiyi Wang, Runxin Xu, Shirong Ma, Chong Ruan, Peng Li, Yang Liu, Yu Wu / <See Details on Fugu-MT> / ライセンス: CC-BY-SA-4.0
- AgentRL: Scaling Agentic Reinforcement Learning with a Multi-Turn, Multi-Task Framework - 著者: Hanchen Zhang, Xiao Liu, Bowen Lv, Xueqiao Sun, Bohao Jing, Iat Long Iong, Zhenyu Hou, Zehan Qi, Hanyu Lai, Yifan Xu, Rui Lu, Hongning Wang, Jie Tang, Yuxiao Dong / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Scaling In-Context Online Learning Capability of LLMs via Cross-Episode Meta-RL - 著者: Xiaofeng Lin, Sirou Zhu, Yilei Chen, Mingyu Chen, Hejian Sang, Ioannis Paschalidis, Zhipeng Wang, Aldo Pacchiano, Xuezhou Zhang / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Understanding and Mitigating Token-Pruning-Induced Vulnerabilities in VLMs - 著者: Shuailong Wang, Xinyu Lyu, Shengming Yuan, Jingkuan Song, Heng Tao Shen, Lianli Gao / <See Details on Fugu-MT> / ライセンス: CC BY 4.0