サマリー
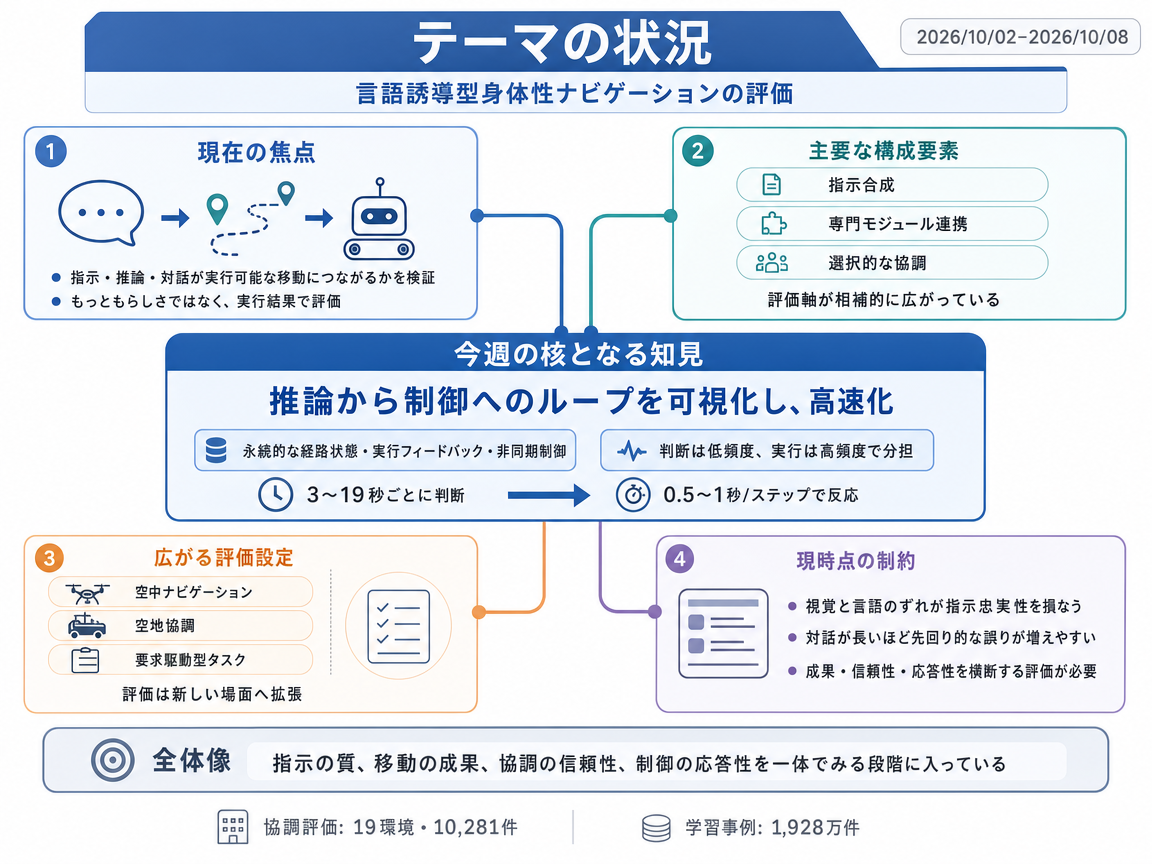
本テーマの中心は、言語モデルによる指示・推論・コミュニケーションが、単にもっともらしいテキストにとどまらず、実際に有効な身体性ナビゲーションにつながるかを評価することである。代表的研究は、プラットフォーム横断の指示合成、専門モジュールに支援されたナビゲーション、過剰なエージェント間対話のリスクを扱っている。今週のNavGPT-3の知見はこうした懸念を実行フィードバックと非同期制御へ広げ、他の新規論文は評価を空中、協調、要求駆動型の設定へと拡張している。
テーマの状況
代表的な論文のIntroductionは、相補的な評価上の課題を示している。「Can LLMs Generate Human-Like Wayfinding Instructions?」は、プラットフォーム固有で労力のかかる指示データセットという問題に、学習不要の合成で取り組む。その結果は、人間による評価と下流のナビゲーション性能の両面から検証されている。NavGPT-2は、ノイズの多い視覚からテキストへの変換、脆弱なプロンプト設計、言語モデルによるナビゲーションと専門エージェントとの性能差を指摘しており、これがVLMの推論とナビゲーションモジュールを組み合わせる動機となっている。ObjectNavのコミュニケーション研究は、コミュニケーションが多いほど良いとは限らないことを示した。選択的な協調は支援なしのベースラインより性能を向上させたが、完全な協調は性能を低下させ、やり取りが長いほど先回り的なハルシネーションが増える傾向が見られた。
今週の「NavGPT-3: Harnessing Context in a Hierarchical Navigation Runtime」(2610.10787v1、暫定)の知見は、このベースラインを推論と物理的実行のインターフェースへと拡張する。そのIntroductionでは、永続的な経路状態、検査可能な実行フィードバック、そして計画・実行・監視の非同期化が述べられている。言語モデル単独では3〜19秒に1回しか判断できないのに対し、実行をVLAに委ねることで最小反応時間が1ステップあたり0.5〜1秒に短縮されると報告している。これらの論文は総じて、指示の忠実性、ナビゲーション成果、コミュニケーションの信頼性、そして推論から制御へのループの応答性を横断する評価の必要性を示している。
- Can LLMs Generate Human-Like Wayfinding Instructions? Towards Platform-Agnostic Embodied Instruction Synthesis
- NavGPT-2: Unleashing Navigational Reasoning Capability for Large Vision-Language Models
- Is Generative Communication between Embodied Agents Good for Zero-Shot ObjectNav?
- NavGPT-3: Harnessing Context in a Hierarchical Navigation Runtime
インフォグラフィクス(日本語)
今週の進展
Speaking the Navigator's Language: Trajectory-Grounded Instruction Translation for Frozen Aerial VLN Agents <See Details on Fugu-MT>
TGITは、指示を凍結された空中ナビゲーターのための軌跡に基づくコマンドへ変換する。 OpenFlyの成功率を31.03%から11.33%へ低下させる指示の不一致を対象とし、指示忠実性の問題を空中ナビゲーションへ拡張している。
AirGroundVLN: A Large-Scale Benchmark for Goal-Oriented Air-Ground Collaborative Vision-and-Language Navigation <See Details on Fugu-MT>
AirGroundVLNは、言語誘導型ナビゲーションの評価を空中・地上エージェントの協調へと広げる。 19環境にわたる10,281エピソードを提供し、協調メモリと空中誘導型計画を組み合わせたフレームワークも併せて提示している。
NavGPT-3: Harnessing Context in a Hierarchical Navigation Runtime <See Details on Fugu-MT>
NavGPT-3は、階層型ナビゲーションランタイムによりR2R-CEで最先端の性能を、RxR-CEで人間レベルの結果を報告している。 非同期制御と、1,928万件の事例で学習しシーンの変化に応じて視覚トークンを割り当てるVLAとを組み合わせている。
WareFly-VLA: A Vision-Language-Action Framework for UAV Navigation and Human Tracking in Smart Warehouses <See Details on Fugu-MT>
WareFly-VLAは、身体性言語評価を倉庫内でのUAVによる人物探索・位置特定・追跡へと拡張する。 リークのないエピソード単位のプロトコルのもと、4つのオープンソースVLAアーキテクチャを2つの制御レートでベンチマークしている。
SuperNav: An Agentic Navigation System for Any Task in Any Scene <See Details on Fugu-MT>
SuperNavは、ナビゲーション評価をインスタンスレベル、複数物体、要求駆動型のタスクへと広げる。 そのエージェントハーネスはナビゲーション固有のファインチューニングなしで事前学習済みMLLMを用い、評価対象のベースラインを上回る結果を報告している。
今後の展望
今後の展望(要約)
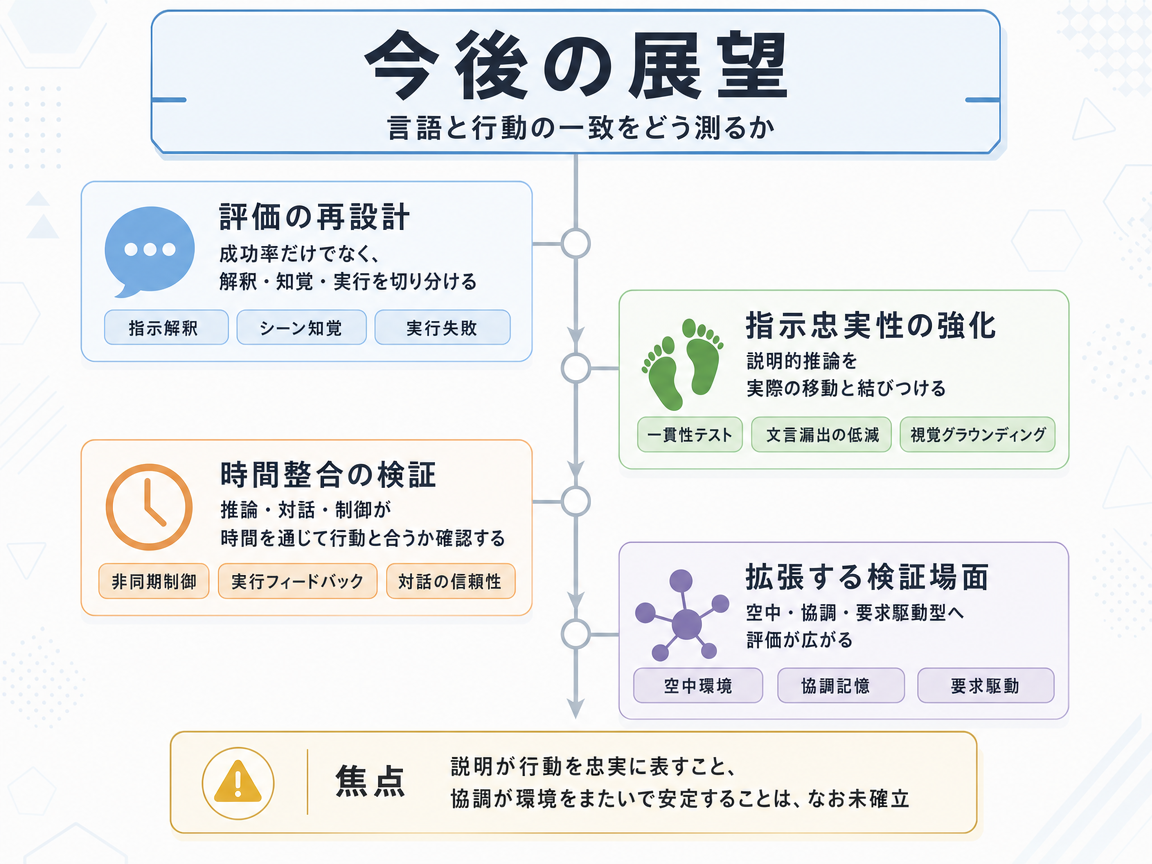
ナビゲーションの評価では、指示への忠実さや説明上の推論を、実際の行動と結び付ける必要がある。優先課題は、異なる環境間での一貫性を高め、生成した指示が参照文の表現をそのまま写す傾向を抑え、写真とは異なる視覚表現でも状況を正しく把握できるようにすることだ。テストでは成功の有無だけでなく、指示の解釈、場面の認識、行動の実行のどこで失敗したかを区別すべきである。さらに、推論や説明が時間を通じて行動と一致するかも重要になる。非同期制御と協調用メモリは、実行時のフィードバックや応答性を通じて、この一致を検証する環境を提供する。ObjectNavの知見からは、実際には起きていない行動を起きたとみなす誤りや、自己位置推定の誤りも検査する必要がある。NavGPT-3の暫定結果は計画と制御の連携改善を示唆するが、説明の忠実さや環境をまたぐ協調の信頼性はまだ確立していない。
インフォグラフィクス(日本語)
3年後を想定した動き
長期的には、ナビゲーション用の言語とロボットの行動を一体として評価する方向へ進むだろう。流暢な指示と目的地への到達を別々に採点するだけでは不十分である。従来研究では、生成された指示が知覚の誤りを引き継ぐ場合がある。説明が実際の行動と食い違うことも示されている。エージェント間の対話が長くなるほど、かえってナビゲーションが悪化する場合もある。そこで、移動についての発言が観測された実行結果に裏付けられているかを確認する必要がある。
今週の報告は、この評価に使える二つの補完的な環境を示している。軌道に基づく指示変換は、基盤モデルを変更せずに、空中を移動する機体向けの指示へ適応させる。非同期ランタイムは、持続的な経路情報と実行時のフィードバックを組み合わせ、計画と制御を異なる速度で動かす。複数ロボットの協調作業や倉庫内の作業により、これらの仕組みを検証できる場面も広がる。
中心的な監視課題は、宣言された行動を後の判断に使える事実とみなすために、どの程度の証拠が必要かという点である。これにより、評価計画を従来より具体化できる。ただし、提供された説明には年ごとの明確な到達目標がなく、NavGPT-3に関する主張も暫定的である。
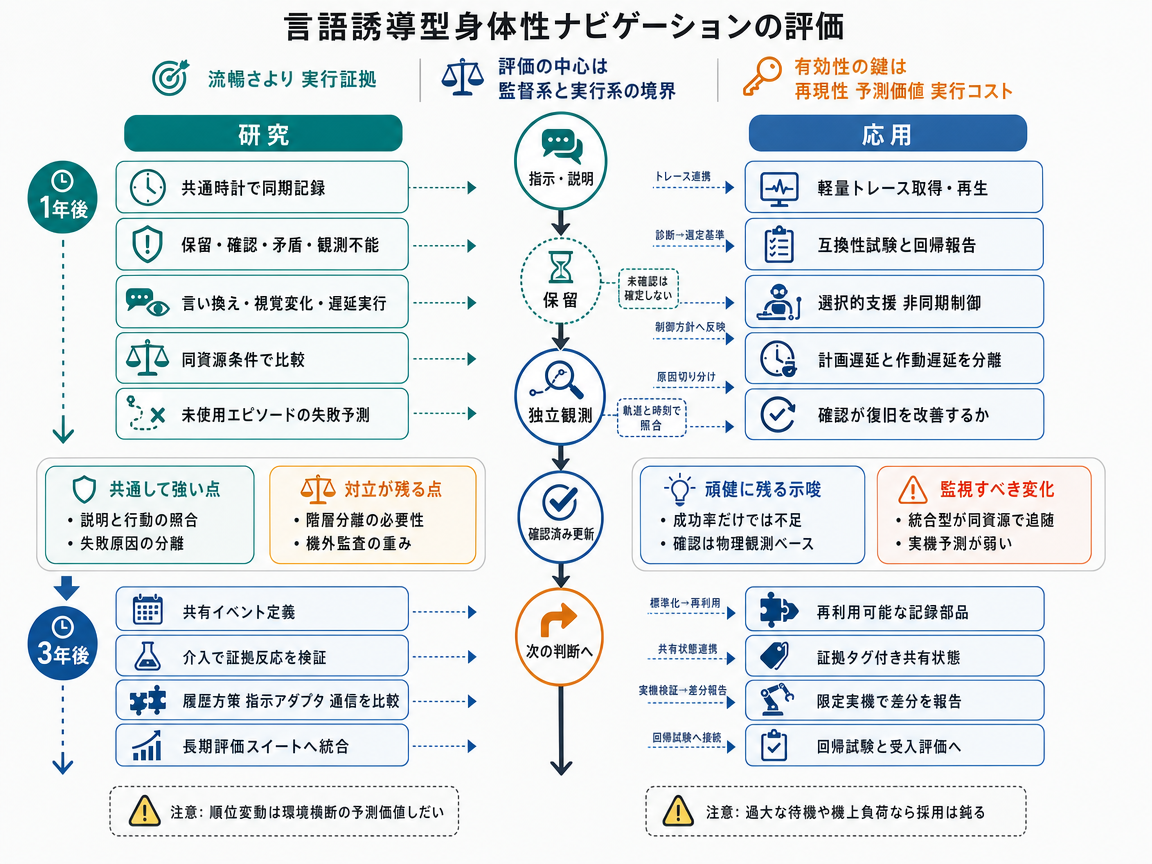
今後3年間で、経路を割り当てる低速な言語監督部と、直近の状況に対処する高速な移動方策との役割分担が明確になる可能性がある。初年度には、計画の間隔と、障害物を観測してから反応するまでの遅延を共通の時間軸で測る。指示変換については、表現の変更や未知の視覚スタイルがあっても意味を保ち、参照文をそのまま写さないかを検査する。範囲を限定した試作では、命令と観測を対応付けて記録する。これにより、別の生成メッセージではなく、実際の観測証拠によって移動を確認できる。
2年目には、再利用可能な経路記録と検証規則によって、研究機関同士が接続部分の失敗を比較しやすくなる。記憶機構が行動だけでなく説明も改善するかを試すこともできる。実用的な試験では応答時間の上限と検証済みの代替動作を事前に定め、機器の条件が許せば小型の監督機構を利用する。この仕組みは、低速な指示役が経路を割り当て、高速な制御役が直近の状況に対応する運行管制に似ている。ただし、割り当てられただけの移動を完了済みとは扱わない。記録された失敗を基に処理順序や確認規則を修正することで、モデルの大型化だけに頼らず、検証を進歩の中心に置ける。
3年目には、空中と地上の機体が組む作業や、複数ロボットによる監督付き実証へ広がる可能性がある。支援は、状態情報の古さや自己位置の不確かさなど、測定された限界を超えた場合にだけ求める。ただし、その基準値は一律に決めず、環境ごとに調整しなければならない。共通ベンチマークでは、検証済みの引き継ぎが制御を遅らせずに意思疎通を改善するかを評価し、総合的な成功率に隠れた失敗も明らかにできる。注目すべき兆候は、経路状態を扱う接続方式が独立に再利用され、未完了の行動を完了済みとみなす誤りが再現可能な形で減ることである。一方、同じ機器と計算条件で、統合型の方策が同等に信頼できる推論と制御を実現すれば、このシナリオの妥当性は弱まる。この類比は権限分担と検証を理解する助けにはなるが、安全性や共通標準の成立を保証しない。
今後3年間で、検証可能な行動記録が、ナビゲーション結果を受け入れるための条件になる可能性がある。初年度には、システムの発言を観測された移動と対応付け、計画上の出来事と制御手順の時刻をそろえる。これにより、タスクの成功だけでは見えない不一致を発見できる。支援なし、選択的支援、全面的な協力を比較し、通信が本当に役立つかを調べる。指示変換については、利用者の要求を保っているかを評価する。初期段階で決定的な節目となるのは、単なる記録ツールの導入ではなく、裏付けのない説明を同等の証拠として認めないベンチマークや試験の登場である。
中心となる仕組みは照合であり、時刻情報と確認記録を使って、システムの宣言を測定された実行結果と一致させる。信号が送られただけでは実際のデータ伝送を証明できないのと同じ考え方である。一つの検査が新たな不一致を明らかにし、それが追加検査の必要性を高める可能性がある。そのため、ナビゲーション能力が大きく向上しなくても、評価手法だけが広がることはあり得る。2年目には、共通のイベント形式を使い、システム変更後も同じ検査を繰り返せるようになる。研究者は、記憶機構が行動と説明の両方を改善するかも調べる。機体上の計算資源が足りない場合は外部の計算機で記録を比較できるが、欠落した出来事や通信負荷を測定する必要がある。検査系自体にも検証が必要であり、知覚が誤っていれば、移動システムの誤りを検出せず再現してしまう。
3年目には、こうした規則を採用する計画が、検証可能な行動記録のない試験を制限する可能性がある。また、要求の難しい部分を捨てる指示変換器も厳しく評価されるだろう。試作機は高速な制御、低速で調査可能な計画、両者を照合する層を組み合わせられるが、無制限の実環境導入が可能だとは限らない。最も強い兆候は、成功率だけでなく記録された移動証拠が、ベンチマークへの参加や試験継続の条件になることである。ただし、連続的な移動は部分的にしか完了していない場合があり、ロボット分野には普遍的な時計も自動的な強制機構もない。各機体の内部だけで信頼できる検証が実現すれば、外部検査を必須の関門にするという強い主張は弱まるが、診断技術の普及は続くだろう。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- Can LLMs Generate Human-Like Wayfinding Instructions? Towards Platform-Agnostic Embodied Instruction Synthesis - 著者: Vishnu Sashank Dorbala, Sanjoy Chowdhury, Dinesh Manocha / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- NavGPT-2: Unleashing Navigational Reasoning Capability for Large Vision-Language Models - 著者: Gengze Zhou, Yicong Hong, Zun Wang, Xin Eric Wang, Qi Wu / <See Details on Fugu-MT> / ライセンス: CC-BY-SA-4.0
- Is Generative Communication between Embodied Agents Good for Zero-Shot ObjectNav? - 著者: Vishnu Sashank Dorbala, Vishnu Dutt Sharma, Pratap Tokekar, Dinesh Manocha / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- NavGPT-3: Harnessing Context in a Hierarchical Navigation Runtime - 著者: Gengze Zhou, Yicong Hong, Jiazhao Zhang, Xunyi Zhao, Jian Zhou, Zixing Lei, Zun Wang, Chongyang Zhao, Xionghui Chen, Stephen Gould, Anton van den Hengel, Qi Wu / <See Details on Fugu-MT> / ライセンス: CC BY 4.0