サマリー
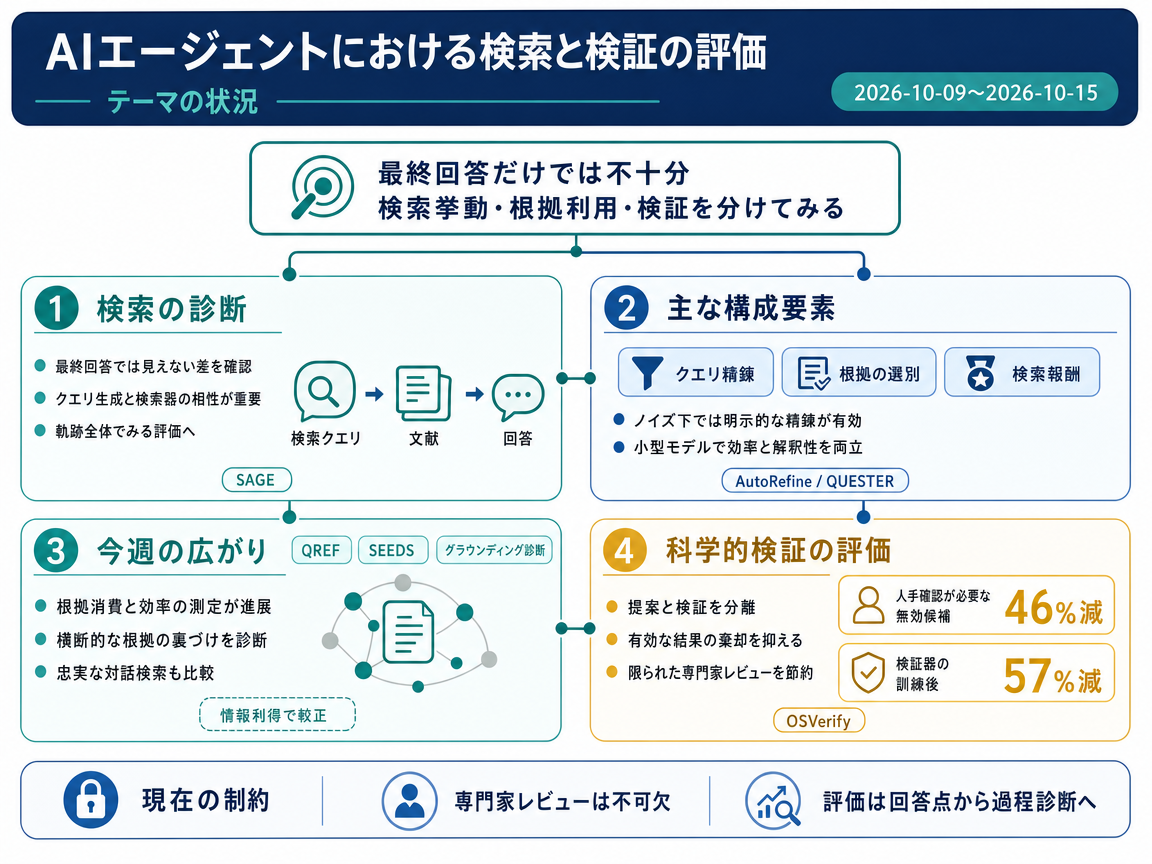
代表的な研究は、検索をエージェント推論の一構成要素として評価し、生成されたクエリ、検索器の能力、エビデンス利用の間にある、最終回答スコアだけでは明らかにならない不整合を浮き彫りにしている。今週のエビデンスは、軌跡レベルのグラウンディング診断とエビデンス効率の測定を加えた。さらに評価の焦点を科学的検証へと広げ、有効な結果の棄却を抑えつつ、専門家レビューの前にどれだけ無効な成果を除外できるかを測定している。
テーマの状況
代表的な論文のIntroductionは、最終回答のみを評価するのではなく、検索挙動を診断する必要性を強調している。SAGEは20万本の論文を対象とする1,200件の科学検索クエリを提供し、検証可能な短答式の質問と自由記述型の研究タスクを組み合わせている。その評価では、キーワード指向のエージェントのサブクエリが、LLMベースの検索器の意味理解能力にもかかわらず、BM25をLLMベースの検索器より約30%有利にすることが示された。AutoRefineは補完的な弱点に取り組む。すなわち、ノイズを含む検索文書と結果のみに基づく報酬ではエビデンス選択への手がかりがほとんど得られず、これが明示的な精錬と検索固有の報酬の動機となっている。QUESTERは効率性と解釈可能性の観点を加える。BM25向けのキーワードクエリを生成するよう小型LLMを訓練し、検索の有効性とクエリレイテンシで評価するとともに、ニューラルインデックスの再構築を回避している。
今週の「One-Sided Verification Under Limited Expert Review」(2610.18089v1)のエビデンスは、この構成要素レベルの評価の視点を科学的検証へと広げる。そのOSVerifyフレームワークは、誤りの提案とその検証を分離する。有効な解が誤って棄却される数を制約しつつ、無効な候補がどれだけ棄却されるかを測定する。Introductionでは、人間によるレビューを要する無効候補がベースラインに比べて46%減少し、検証器の訓練により57%まで減少したと報告されている。これにより、限られた専門家レビューの能力が中心的な評価制約となる一方、人間の専門家は科学的妥当性を確立するうえで不可欠な存在と位置づけられている。
- Search and Refine During Think: Autonomous Retrieval-Augmented Reasoning of LLMs
- QUESTER: Query Specification for Generative Retrieval
- SAGE: Benchmarking and Improving Retrieval for Deep Research Agents
- One-Sided Verification Under Limited Expert Review
インフォグラフィクス(日本語)
今週の進展
QREF: Improving DeepSearch Agents by Aligning Search with Reasoning via Query Refinement and Evidence Filtering <See Details on Fugu-MT>
QREFは、クエリ精錬とエビデンスのフィルタリングにより、検索を進行中の推論と整合させる。 現在の推論意図に条件づけてクエリを書き換え、検索バッチと推論目的の両方に関連するエビデンスのみを保持する。
SEEDS: Preview-Guided Evidence Admission for Search Agents <See Details on Fugu-MT>
SEEDSは、ローカルコーパスとライブのウェブ検索の両方を用いて、9つの知識集約型QAベンチマークで選択的エビデンス採用を評価する。 評価を回答品質からエビデンス消費へと拡張し、検索効率の向上と全エビデンス消費の大幅な削減を報告している。
Benchmarking and Training Reward Models for Cross-Source Evidence Grounding in Search Agents <See Details on Fugu-MT>
本研究は、きめ細かな6層の決定木を用いて、検索エージェントにおけるソース横断的なエビデンスのグラウンディングをベンチマークする。 診断の対象を最終回答から、検索軌跡全体にわたるグラウンディングの判断へと移している。
Faithful Query Resolution for Conversational Search <See Details on Fugu-MT>
本研究は、BM25およびSPLADE検索のもとで、5つの対話型クエリ生成構成を比較する。 ユーザーの言い回しを保持する最小限のリゾルバと、学習済みの書き換えと生の発話のランク融合とを対比する、忠実性に焦点を当てた比較を加えている。
Information-Gain Calibrated On-Policy Distillation for Deep Search Agents <See Details on Fugu-MT>
本研究は、ディープサーチのクエリが検索前の文脈のみから教師付けされる失敗モード「エビデンス盲目な教師付け」を特定する。 検索後の情報利得を用いて、実際に検索されたエビデンスに向けてクエリの選好を較正する。
今後の展望
今後の展望(要約)
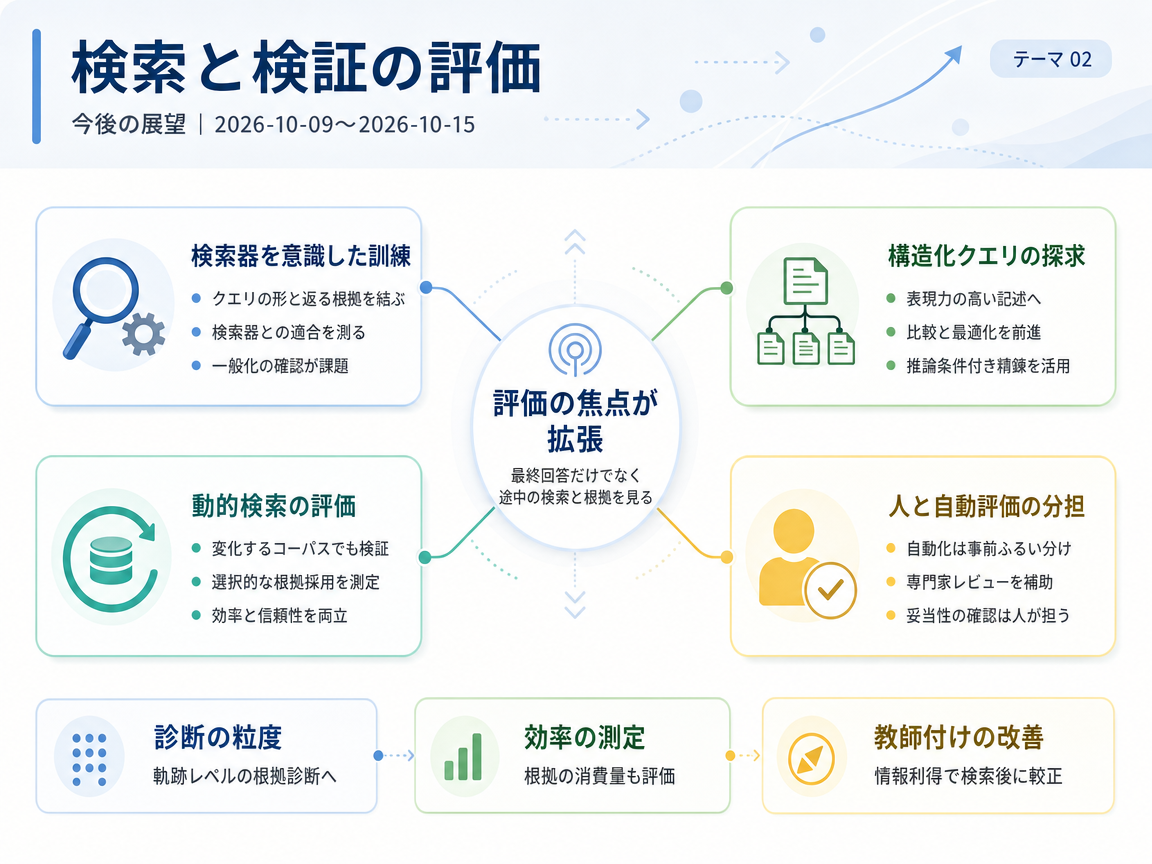
次に有力なのは、最終回答の正しさだけでなく、検索で得た証拠がどれほど役立つかを評価し、その結果を学習にも反映する方向である。SAGEはこの方向性を示す一方、エージェントの設計や学習方法によって結果が変わり得ると注意を促している。QUESTERは、より豊かな構造化クエリと追加の最適化を提案する。今後は、更新され続ける文書集合を使った評価や、回答が証拠を適切に利用しているかの詳しい検査も重要になる。AutoRefineは、より大規模なモデル、意味を考慮した回答評価、変化する情報源を用いた試験を計画している。利用する証拠を選別する仕組みと検索過程の診断は、効率性と信頼性の測定に役立つ可能性がある。自動検証は確認作業を減らせるが、科学的妥当性に関する専門家の判断を置き換えるべきではない。
インフォグラフィクス(日本語)
3年後を想定した動き
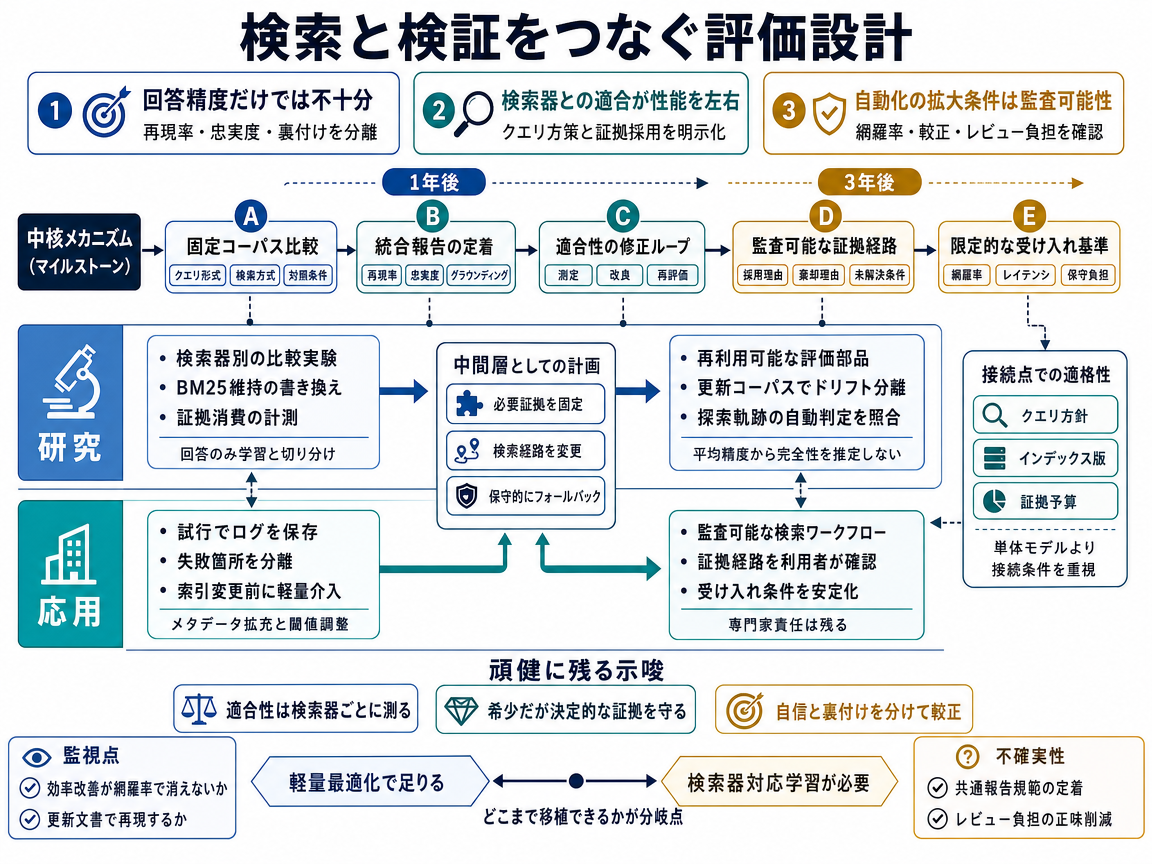
今後3年間の標準的な進展では、検索部品の性能比較から、回答の根拠を保存する監査可能な研究手順へと重点が移る。出発点となるのは、エージェントが作るクエリと、それを受け取る検索方式の相性を調べる評価である。1年目には、固定した文書集合を使ってクエリの形式を比較し、関連文書の網羅性や利用者の意図が保たれているかを測る。さらに、回答が証拠によって十分に支えられているかも確認する。初期の文献検索では、こうした記録から失敗箇所を特定し、検索基盤を交換する前に低コストなクエリ修正を試す。
2年目には、更新される文書集合と固定版を比較する再利用可能な評価ツールが整う。これにより、情報源の変化による影響と、クエリ方針の不適合による影響を区別できる。研究者はクエリ生成を証拠の選択や改善と結び付け、あるエージェントで得た改善が別のエージェントにも通用するかを検証する。ここでは、測定された不一致が修正を導き、その後に得られた証拠が修正の効果を示すというフィードバックループが働く。また、高い回答確信度が本当に強い証拠の裏付けを伴うかも調べる必要がある。
3年目には、採用または除外された文章の理由を利用者が追跡できるよう、成功した手順が証拠の経路を保存する。評価では、一つの正解を見つける能力と、幅広い研究課題に必要な資料を十分に集める能力を区別する。構造化クエリは明示的な制約の表現に役立ち、専門家の注釈との比較は検索過程全体に対する自動判定の信頼性を検証する。重要な監視指標は、処理時間や専門家による確認を過度に増やさず、証拠の有用性と網羅性が繰り返し改善することである。ただし、まれでも結論を左右する証拠を保護した評価で効率向上が消えるなら、この進路の妥当性は弱まる。科学的妥当性には引き続き専門家の判断が必要であり、異なるエージェントや更新後の文書集合で失敗が続く場合は、広範な導入を見送る根拠となる。
対抗シナリオでは、クエリの表現だけを改善するのではなく、研究エージェントと検索ツールの間に独立した計画層を置く。データベースのクエリ計画を参考にし、課題が必要とする証拠と、その証拠を得る手順を分離する考え方である。1年目には、否定表現や期間制限のような難しい意味を保てる、限定的な証拠要件記述方式を試験する。初期の文献検索では利用者が計画を確認できるように表示し、自動振り分けは管理された試験に合格した課題だけに導入する。
拡大の条件は、少なくとも二つのエージェント設計と二つの文書集合版で、実行と専門家確認を合わせた負担が減ることである。同時に、利用者の意図や証拠の網羅性を大きく損なってはならない。2年目には、更新される文書集合への対応が中心となる。更新後は有効な検索経路に関する古い見積もりが信頼できなくなるため、ツールは古くなった計画を検出し、必要なら慎重な検索に戻る。研究者は、別々の文書にある主張を結び付ける検索も検証する。個々の文章が関連していても、それらを組み合わせた結論が正しいとは限らないからである。関連研究を整理した表は、欠けている候補や未確認の項目を見えるようにし、利用者が不完全な検索を発見して人による確認へ回す助けとなる。
3年目には、少数の導入組織が、検証済みの検索接続機能と再実行可能な処理記録を共有する可能性がある。その記録から無駄な手順を見つけて後の経路選択を改善できるため、計画層だけの効果をエージェント全体とは分けて評価できる。効果が続く場合、未解決の証拠要件を利用者に示したまま、計画層に検索方法と作業量を調整する限定的な権限を与えられる。重要な監視指標は、研究結論を変え得る珍しい証拠を失わずに、再利用可能な計画が修正時間を短縮することである。単純なクエリ書き換えがより小さな負担で同じ成果を出すなら、大規模な計画基盤の必要性は弱まり、科学的妥当性は引き続き専門家が判断する。
もう一つの可能性は、エージェントと検索システムの相性を文書化し、それを科学情報検索での利用条件にできるかを問う進路である。システムが正しい回答を出しても、決定的な証拠を見逃したり、関連研究の収集が不完全だったりすることが出発点となる。1年目には、エージェントと文書集合を固定したまま、クエリ形式と検索方式を変える対照実験を行う。これにより、両者を接続する部分の影響を切り分けられる。研究チームは結果を簡潔な相性資料にまとめ、評価で使ったクエリ方針や検索方式を記録する。文書集合の版も同じ資料に明記する。
2年目に要件を強化できるのは、相性の問題が単発の試験だけでなく、実際の作業でも繰り返し重大な失敗を起こす場合に限られる。研究者は、成功した構成が別のエージェントや更新後の文書でも機能するかを試す。同時に、証拠に対する自動判定を専門家の評価と比較する。組織がこの確認を受け入れ条件に採用した場合、システム更新後には、指定された索引とエージェントが引き続き適合することを示す新たな証拠が必要になる。この仕組みは、部品単体の能力だけでなく、接続点での動作も確認する電力システムの接続規則に似ている。ただし、研究用の文書集合には単一の運営主体がないため、承認手続きは各組織が個別に運用する可能性が高い。
3年目には、参加組織が一つのモデルをあらゆる研究作業に適用できると見なさず、特定の検索構成を承認するようになる可能性がある。各承認には、試験済みの接続方式と適用限界を記録し、回答品質や証拠の網羅性を別々に測る。独立した網羅性検査によって、読む文書を減らした結果として重要な証拠が隠れていないかを確認し、システム変更後には再試験を求める。最も明確な監視指標は、診断結果を公表するだけでなく、更新後の利用継続に新しい相性証拠を実際に要求する運用である。一方、持ち運び可能なクエリアダプターが異なるエージェントや変化する文書集合でも安定して働くなら、版ごとの承認の必要性は弱まる。科学的妥当性の判断は、引き続き専門家が担う。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- Search and Refine During Think: Autonomous Retrieval-Augmented Reasoning of LLMs - 著者: Yaorui Shi, Shihan Li, Chang Wu, Zhiyuan Liu, Junfeng Fang, Hengxing Cai, An Zhang, Xiang Wang / <See Details on Fugu-MT> / ライセンス: CC-BY-SA-4.0
- QUESTER: Query Specification for Generative Retrieval - 著者: Arthur Satouf, Yuxuan Zong, Habiboulaye Amadou-Boubacar, Pablo Piantanida, Benjamin Piwowarski / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- SAGE: Benchmarking and Improving Retrieval for Deep Research Agents - 著者: Tiansheng Hu, Yilun Zhao, Canyu Zhang, Arman Cohan, Chen Zhao / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- One-Sided Verification Under Limited Expert Review - 著者: Fan Nie, Haotian Ye, Shurui Liu, Zihao Wang, Stefano Ermon, James Zou / <See Details on Fugu-MT> / ライセンス: CC BY 4.0