サマリー
今週のテーマは、言語モデルの評価をデータ効率、多言語カバレッジ、圧縮、指示追従と結びつけるものである。代表的研究は、子ども規模のデータによる指示チューニング、二言語エンコーダ–デコーダモデル、言語横断的な圧縮を検討している。今週の研究は、多言語BabyLMのデータ研究、言語別の圧縮・要約ベンチマーク、そして品質と指示遵守を別々に採点する翻訳評価を加えている。
テーマの状況
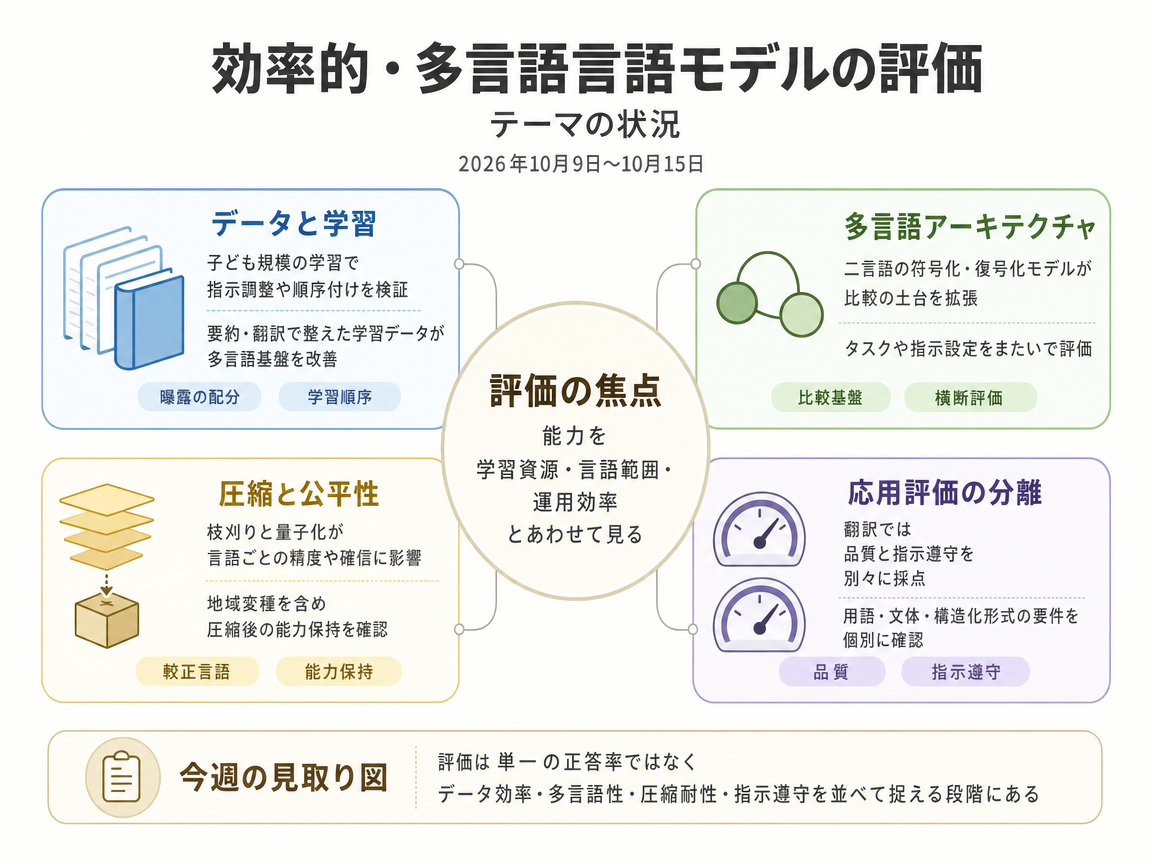
代表的な研究の序論は、異なるデータ・アーキテクチャ・デプロイ上の制約のもとで言語モデルが何を学習するかという観点から評価を位置づけている。CLASS-ITは、子ども規模の言語入力で学習したBabyLMが、対話型と質問応答型の指示チューニング、およびカリキュラム順序付けから恩恵を受けるかを問う。OpenBAは、タスクやプロンプト設定を横断して評価されたオープンな二言語エンコーダ–デコーダモデルにより、アーキテクチャ上のベースラインを広げている。Towards Inclusive NLPは、枝刈りと量子化がアラビア語、英語、カンナダ語における精度と確信度にどう影響するかを検討している。これらの研究は総じて、能力を学習資源、言語カバレッジ、デプロイ効率とあわせて評価する必要性を示している。
WMT2026におけるQwen-MT-Lumen(2610.19758v1)による今週の知見は、この問題意識を専門翻訳へと広げ、汎用LLM翻訳器は用語、文体、構造化形式に関するきめ細かな要件を確実に守ることに苦戦すると論じている。その序論では、段階的適応、オンライン選好最適化、オンポリシー蒸留を組み合わせ、23の翻訳方向をカバーする14Bシステムを説明し、翻訳品質と指示追従について別々のLLM判定スコアを報告している。これは、一般的なタスク性能とユーザー制約への遵守を区別することの、具体的なアプリケーションレベルの事例を示している。
- OpenBA: An Open-sourced 15B Bilingual Asymmetric seq2seq Model Pre-trained from Scratch
- CLASS-IT: Conversational and Lecture-Aligned Small-Scale Instruction Tuning for BabyLMs
- Qwen-MT-Lumen at WMT2026: Instruction-Specialized Translation via Quality-Aware Training and On-Policy Distillation
インフォグラフィクス(日本語)
今週の進展
Qwenfant: Train Big Character-level BabyLMs on Concise Parallel Text <See Details on Fugu-MT>
Qwenfantは、LLMで要約・翻訳した学習データを用いて多言語BabyLMのベースラインを改善した。 関心を指示チューニングの選択からデータ準備へと移し、投稿時点で多言語トラック1位となった。
Language Exposure Matters: Distribution and Order in Multilingual BabyLM Pre-training <See Details on Fugu-MT>
本研究は、英語・オランダ語・中国語の限定データ事前学習において、言語への曝露の配分と順序を評価した。 カリキュラムの問いを多言語設定に拡張し、特定言語が優勢な一部の混合が均衡した曝露を上回ることを見出した。
Evaluating Large Language Models for Multilingual Abstractive Summarization: A Comprehensive Study of English and Bengali <See Details on Fugu-MT>
本研究は、規模を揃えた英語・ベンガル語の要約データセットで、8つのクローズド/オープンウェイトLLMを語彙・意味・事実性・LLM-as-a-Judgeの指標によりベンチマークした。 英語のいくつかの語彙指標で首位のモデルがベンガル語ではその優位を保てず、言語依存的な性能が明確になった。
Lightweight but Linguistically Fair? Quantisation Robustness across Bavarian, German, and English <See Details on Fugu-MT>
本研究は、BAVGROUNDベンチマークを用いて、バイエルン語・標準ドイツ語・英語における学習後量子化を評価した。 圧縮評価を、地域変種が標準語と同程度に確実に能力を保持するかという問いへと拡張した。
Calibration Language Shapes Block-Influence Pruning in Multilingual Language Models <See Details on Fugu-MT>
本研究は、英語で較正したブロック影響度に基づく枝刈りがインド諸語に転移するかを3つの小型モデルで検証した。 英語・ヒンディー語・マラーティー語・タミル語のデータを用い、較正言語の選択を多言語圧縮の変数として加えた。
Qwen-MT-Lumen at WMT2026: Instruction-Specialized Translation via Quality-Aware Training and On-Policy Distillation <See Details on Fugu-MT>
Lumenは、WMT2026システムについて翻訳品質と翻訳指示への追従を別々のスコアとして報告した。 段階的学習は、汎用的な翻訳品質だけでなく、用語・文体・構造化出力の要件を対象としている。
SEA-HELM Audio: Evaluating Multilingual ASR-LLM Pipeline Performance Across SEA-HELM Subsets <See Details on Fugu-MT>
SEA-HELM Audioは、テキストベンチマークをASR–LLMパイプラインへ拡張し、5言語で合成音声入力とテキスト入力を比較した。 多言語評価に入力モダリティを加え、タミル語で40%超という最大の性能低下が見られた。
今後の展望
今後の展望(要約)
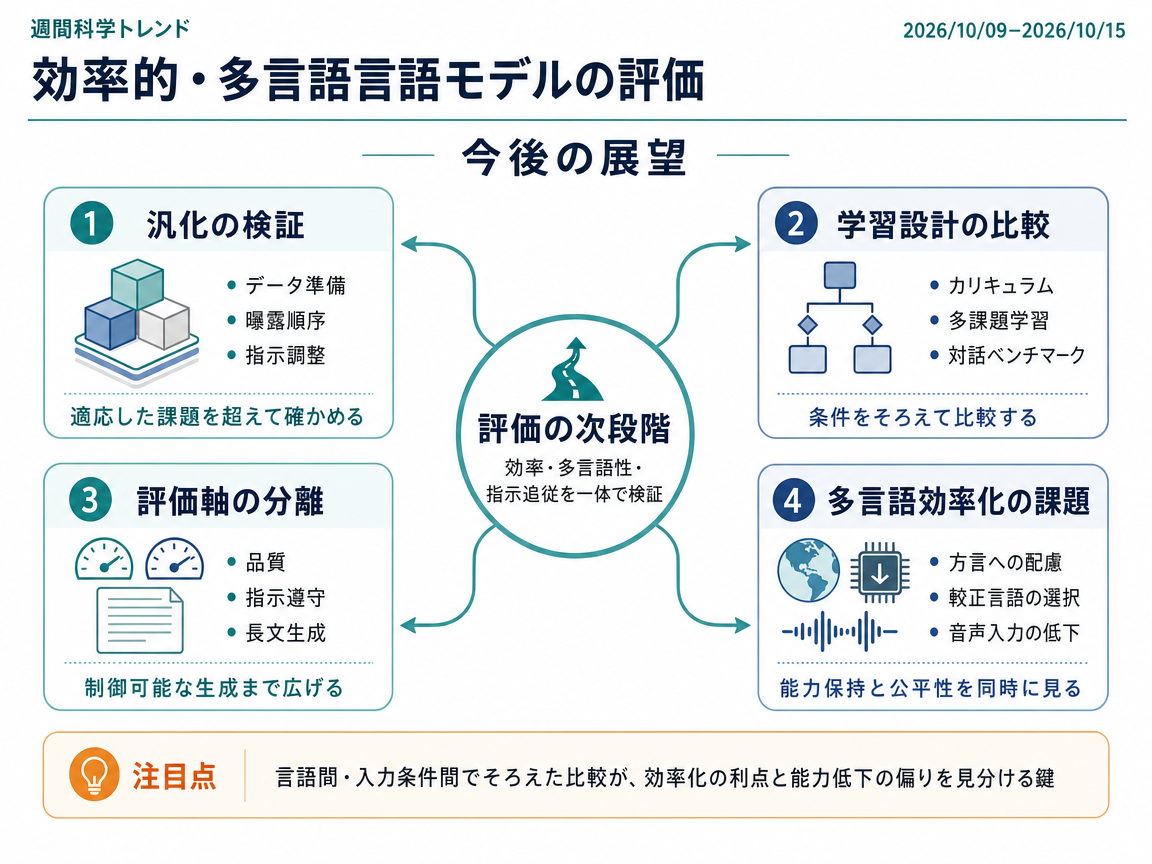
今後の研究では、データ準備、学習データを見せる順序、指示チューニングの改善が未知の課題にも移るかを検証し、多言語かつ少量データの研究を具体的な比較対象にする必要がある。対話型ベンチマークでは、翻訳や長文生成を含め、課題そのものの品質と指示への適合度を分けて評価すべきである。多言語モデルの圧縮では、方言に配慮した試験に加え、事実にない生成や偏りを体系的に調べる必要がある。地域変種を対象とする量子化や言語横断的な枝刈りについては、どの能力が残るのか、校正にどの言語を使うべきかが重要な論点になる。言語間で条件をそろえ、さらにテキスト入力と音声入力を比較することで、計算資源の削減が一部の能力だけを大きく損なっていないかを明らかにできる。
インフォグラフィクス(日本語)
3年後を想定した動き
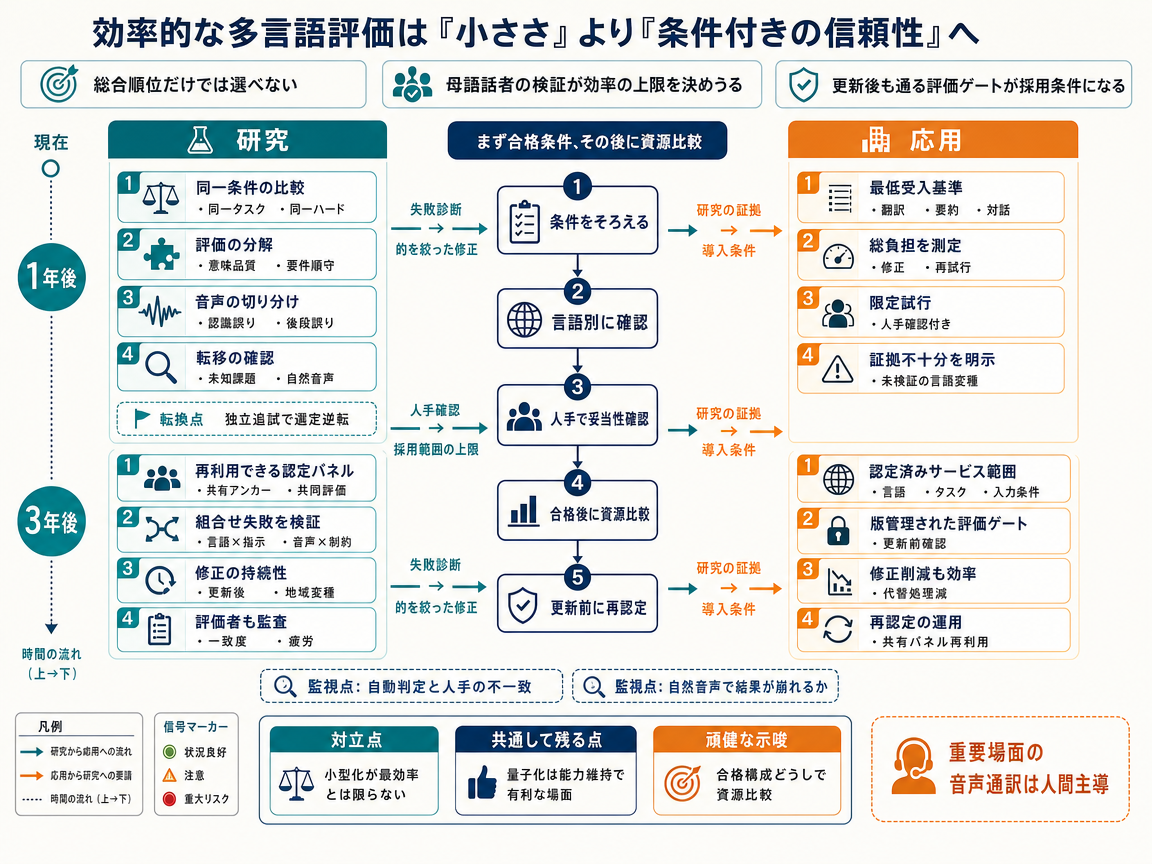
初年度には、データ準備や適応による改善が未知の課題でも保たれるかを調べ、元のモデルと圧縮モデルを同じ条件で比較する。対象となる各言語の結果は別々に示し、全体スコアで地域固有の失敗が隠れないよう、意見が分かれた出力を二言語に通じた評価者が確認する。翻訳試験では、出力の品質と指示への適合度を分けて測る。音声試験では、音声認識の誤りとモデル自体の誤りを区別し、合成音声と自然音声も比較する。転換点となるには、実用上重要な選択の差が二つの独立した比較で再現され、人間の評価者がそれを確認し、試行結果に基づいて構成が変更される必要がある。試行では、能力だけでなく、許容できる結果を一件得るための計算資源と修正作業も測定する。
二年目には、まず最低要件を満たす構成を特定し、その後で資源使用量を比較するようになる。小さいモデルを自動的に優先することはしない。送電網の比喩が示すように、公称上の容量が安定した出力を保証しないのと同様、圧縮だけでは実際の利用条件での効率を保証できない。特定の弱点を直したモデルは、未知の課題による独立試験を受け、成功した試行だけが検証済みの適用範囲を広げる。
三年目までには、この手順が、修正の効果が更新後も残るか、別の地域変種にも移るかを確かめる再利用可能な評価方法になり得る。言語条件、指示条件、音声条件を組み合わせた試験も必要になる。個別に合格しても、それらを同時に扱えるとは限らないためである。システムを変更する前には版ごとの確認を行い、新しい地域変種や入力形式には新たな証拠を求める。注目すべき兆候は、確認済みの失敗によってモデルの選択が繰り返し変わり、資源削減を保ったまま修正後の適用範囲が広がることである。全体順位だけで許容可能な性能を予測できる場合や、未知の試験で改善が消える場合、この道筋の可能性は低下する。最終的に得られるのは特定の作業向けの適格性であり、あらゆる用途に通用する信頼性の証明ではない。
初年度には、モデルだけでなく評価方法も検証し、自動判定と母語話者の評価がどの程度一致するかを言語ごとに調べる。慎重に確認した少数の基準例を人間の小規模な評価班が整備し、再利用可能な比較を支えるとともに、未知の課題で適応効果の移りやすさを試す。音声研究では、自然なアクセントと雑音の影響を確認する。用途別の試行では、技術的な資源使用量に加えて評価者の作業時間も記録し、必要な総作業量を明らかにする。この設計が重要なのは、人間による確認がモデルの実行や適応より高い負担になるとは、現時点の証拠からまだ断定できないためである。
決定的なきっかけは、一部の言語で自動判定と人間の評価の一致度が大幅に低いという結果が再現され、必要な確認作業が対応可能な量を超えることである。二年目には、その圧力によって、人間が検証した知見と自動判定だけに基づく主張が区別され、システム選択で信頼される結果も変わり得る。レンタル養蜂箱の比喩が示すのは、限られた確認能力が既に需要のある領域へ移り、再利用可能な基準例を持つ言語に研究がさらに集まる仕組みである。意見の分かれた出力に確認作業を集中させることはできるが、複数の自動評価器が同じ誤りを共有する可能性があるため、無作為の人手監査も必要になる。
三年目までには、共有の評価班がモデルの挙動をより広く検証できるようになる。用途別の確認表には、検証済みの適用範囲と確認担当者を明記する。確認内容が最新に保たれている領域ではシステムを拡張しやすくなり、音声を扱う作業には修正と引き継ぎの手順が組み込まれる。地域コミュニティとの協力や組織間の共同支援により、見過ごされてきた言語変種にも信頼できる評価を広げられる可能性がある。
監視すべき指標は、評価者の確保にかかる遅れ、受理された主張ごとの確認時間、検証済み範囲の広がりである。基準例の再利用は不足を和らげるが、例が広く知られたり古くなったりすれば保守が必要になる。広い言語に移せる自動評価器が独立監査に合格する場合や、地域主導の取り組みによって有資格者による確認を低い負担で拡大できる場合、このシナリオの可能性は低下する。
出発点となるのは、効率をより厳密に定義することである。小型または低コストのモデルでも、想定用途に必要な能力を保たなければならない。短期的な比較では、地域言語での性能、指示への適合度、音声入力への対応を調べる。一般的なベンチマークの総合点だけでは、十分な証拠にならない。これまでの試験条件では、強い枝刈りより量子化のほうが有望だった。ただし、その結果から普遍的な合格基準を定めることはできない。
三年間の展開としては、名称を明示した参照モデルと比較し、用途ごとに利用可否を決める方向が考えられる。後発医薬品の比喩が示すように、低コストの候補が参照対象に十分近い性能を持つことを確認してから、特定の用途で認める仕組みである。注目すべき証拠はモデルの大きさそのものではなく、想定された条件で必要な能力が保たれているかどうかである。
一方、示された説明には、週ごとの詳しい結果が含まれていない。また、年ごとの具体的な導入手順も示されていない。そのため、このシナリオが支持するのは条件付きの方向性であり、既に確立された適格性確認制度ではない。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- OpenBA: An Open-sourced 15B Bilingual Asymmetric seq2seq Model Pre-trained from Scratch - 著者: Juntao Li, Zecheng Tang, Yuyang Ding, Pinzheng Wang, Pei Guo, Wangjie You, Dan Qiao, Wenliang Chen, Guohong Fu, Qiaoming Zhu, Guodong Zhou, Min Zhang / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- CLASS-IT: Conversational and Lecture-Aligned Small-Scale Instruction Tuning for BabyLMs - 著者: Luca Capone, Alessandro Bondielli, Alessandro Lenci / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Qwen-MT-Lumen at WMT2026: Instruction-Specialized Translation via Quality-Aware Training and On-Policy Distillation - 著者: Hao Wang, Yangyang Liu, Xiaohu Zhao, Heng Liu, Zifu Shang, Tianhao Li, Ruize Gao, Jialong Tang, Liangying Shao, Haoran Wei, Baosong Yang, Linlong Xu, Longyue Wang, Weihua Luo / <See Details on Fugu-MT> / ライセンス: CC BY 4.0