サマリー
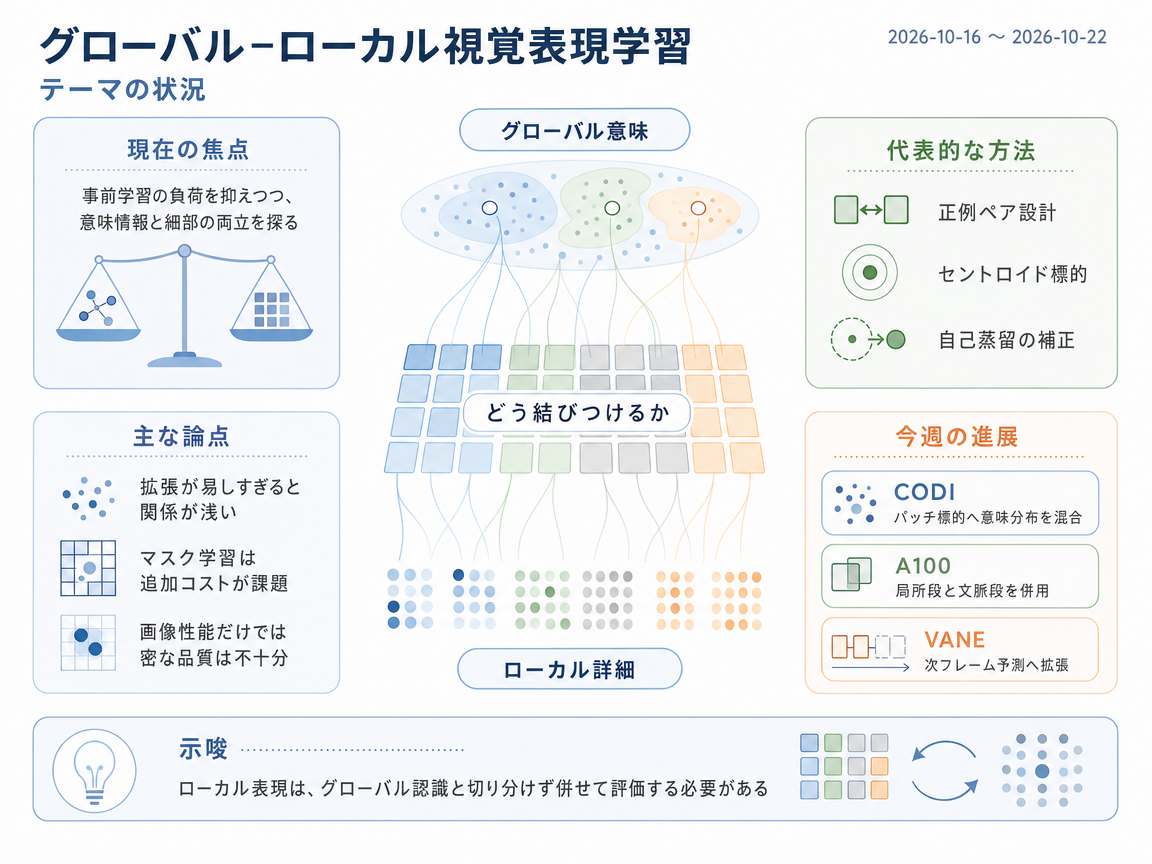
今週のテーマは、自己教師あり視覚モデルが事前学習のオーバーヘッドを抑えつつ、グローバルな意味情報とローカルな詳細をどのように結びつけるかである。代表的な研究は、正例ペアの設計とセントロイドに基づくマスク画像モデリングに取り組んでいる。今週のCODIは、パッチトークンに対する意味的教師信号の偏りを補正することでこの焦点を拡張し、画像レベルの性能向上だけでは密な転移の品質は保証されないことを示している。
テーマの状況
代表的な論文のIntroductionは、自己教師あり視覚学習における相補的な弱点を指摘している。「Enhancing Contrastive Learning Inspired by the Philosophy of ‘The Blind Men and the Elephant’」は、独立にサンプリングされたデータ拡張が、自明であるか網羅性に欠ける正例ペアを生みやすいと論じる。同論文のJointCropとJointBlurは、ペアの拡張パラメータを連動させることで、より難しいグローバル–ローカル関係を作り出す。「Centroid-centered Modeling for Efficient Vision Transformer Pre-training」は、マスク画像モデリングにおけるパラメトリックなトークナイザと冗長なデコーダのコストを問題とする。k-meansのセントロイドをパッチのターゲットとして用い、わずかな追加事前学習コストでセントロイドのインデックスと画素を同時に学習する。
今週の「CODI: Improving Self-Supervised Vision Transformers with Cross Distillation」(2610.30639v1)は、このグローバル–ローカルの問題意識を、自己蒸留において意味情報がどのようにパッチへ伝わるかという点に広げている。同論文のIntroductionによれば、クラストークンの選択的なアテンションにより、アテンションの低いパッチは意味的な更新が弱くなり、DINOv2型の事前学習の後半では密な転移性能が低下しうる。CODIは、教師のクラストークン分布をわずかな割合でマスクされたパッチのターゲットに混合する。条件を揃えたDINOv2の対照モデルに対し、分類と密な予測の各設定で改善を報告している。これらの論文を総合すると、ローカル表現の品質はグローバルな認識性能とともに向上すると仮定するのではなく、併せて評価すべきであることが示唆される。
- Centroid-centered Modeling for Efficient Vision Transformer Pre-training
- Enhancing Contrastive Learning Inspired by the Philosophy of "The Blind Men and the Elephant"
- Self-Distillation for Supervised Fine-Tuning
- TamedFlow: Trajectory-Aware Distillation\\for Teacher-Assisted Diffusion Sampling
- MoDDiT: Simple Token Routing in Diffusion Transformers
- CODI: Improving Self-Supervised Vision Transformers with Cross Distillation
インフォグラフィクス(日本語)
今週の進展
CODI: Improving Self-Supervised Vision Transformers with Cross Distillation <See Details on Fugu-MT>
CODIは、教師のクラストークン分布をパッチトークンのターゲットに混合することで、パッチの意味表現を強化する。 DINOv2型の学習ではパッチへの教師信号が不均一であるのに対し、CODIは条件を揃えた事前学習設定で密な予測と画像レベルの性能の向上を報告している。
A100: A Hybrid Vision Foundation Model for Agricultural Plant Image Analysis <See Details on Fugu-MT>
A100は、ローカル特徴のためのMBConvステージとグローバル文脈のためのTransformerステージを組み合わせ、300万枚のラベルなし農業画像で自己教師あり事前学習を行う。 グローバル–ローカル表現学習を特化領域に持ち込み、バックボーン凍結時に作物分類精度95.37%を報告しており、これはImageNet-12Kのベースラインを2.56ポイント上回る。
Learning from Next-Frame Prediction: Towards Unified and Scalable Visual Representation Learning <See Details on Fugu-MT>
VANEは、自己教師あり視覚事前学習を埋め込み空間での次フレーム予測へと拡張する。 静止画像の目的関数を超え、モデルおよびデータのスケーリング特性の改善と、予測・認識・密な知覚の大半のベンチマークで最高水準の結果を報告している。
今後の展望
今後の展望(要約)
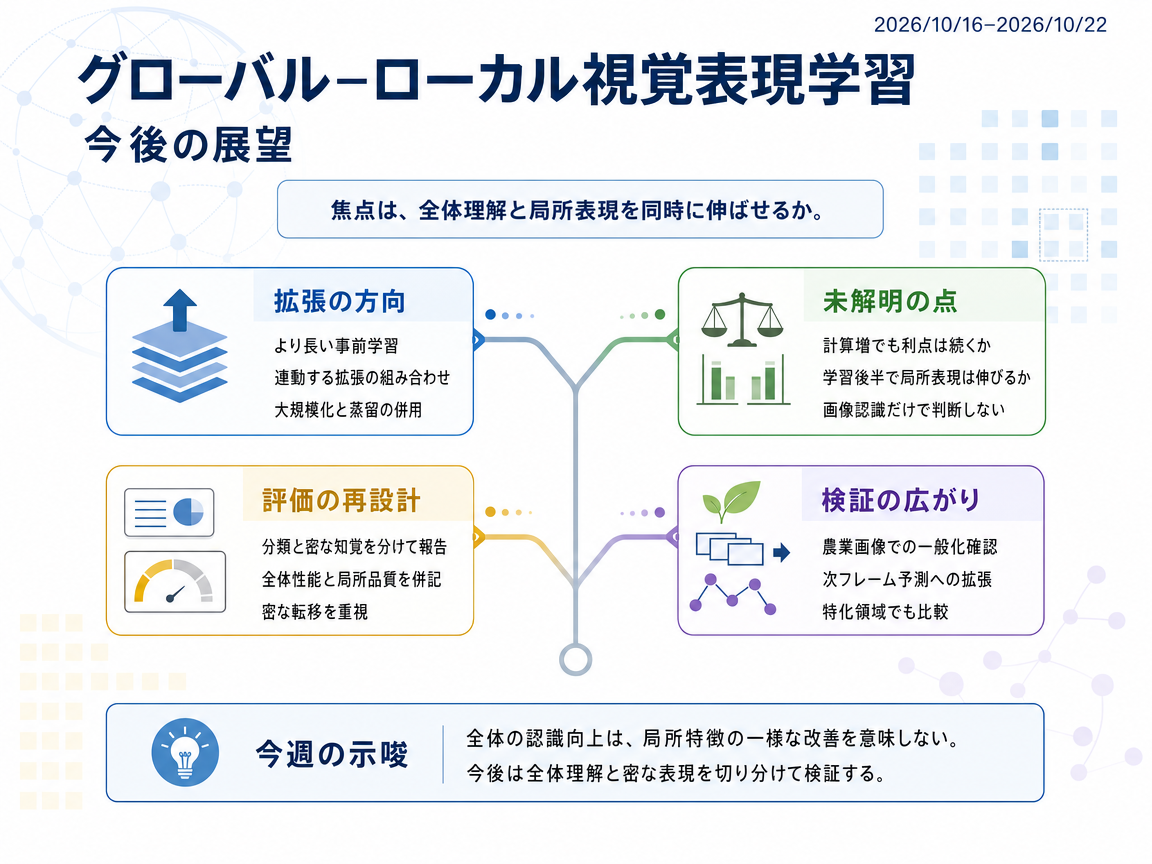
今後は、より長い事前学習と連携させた画像拡張を試すとともに、重心ベースの学習を大規模化し、蒸留で補完する必要がある。ただし、計算資源を増やした場合にも効果が続くかは未確認である。CODIが示す重要な論点は、こうした拡張が局所的なパッチ特徴やセグメンテーションなどの密なタスクを、特に学習後半でも改善できるかどうかである。農業画像や次フレーム予測も、別の用途への転用可能性を調べる試験になる。評価では、画像全体の分類性能と局所領域を扱う性能を分けて報告すべきであり、画像全体の認識向上だけでは局所特徴の改善を証明できない。
インフォグラフィクス(日本語)
3年後を想定した動き
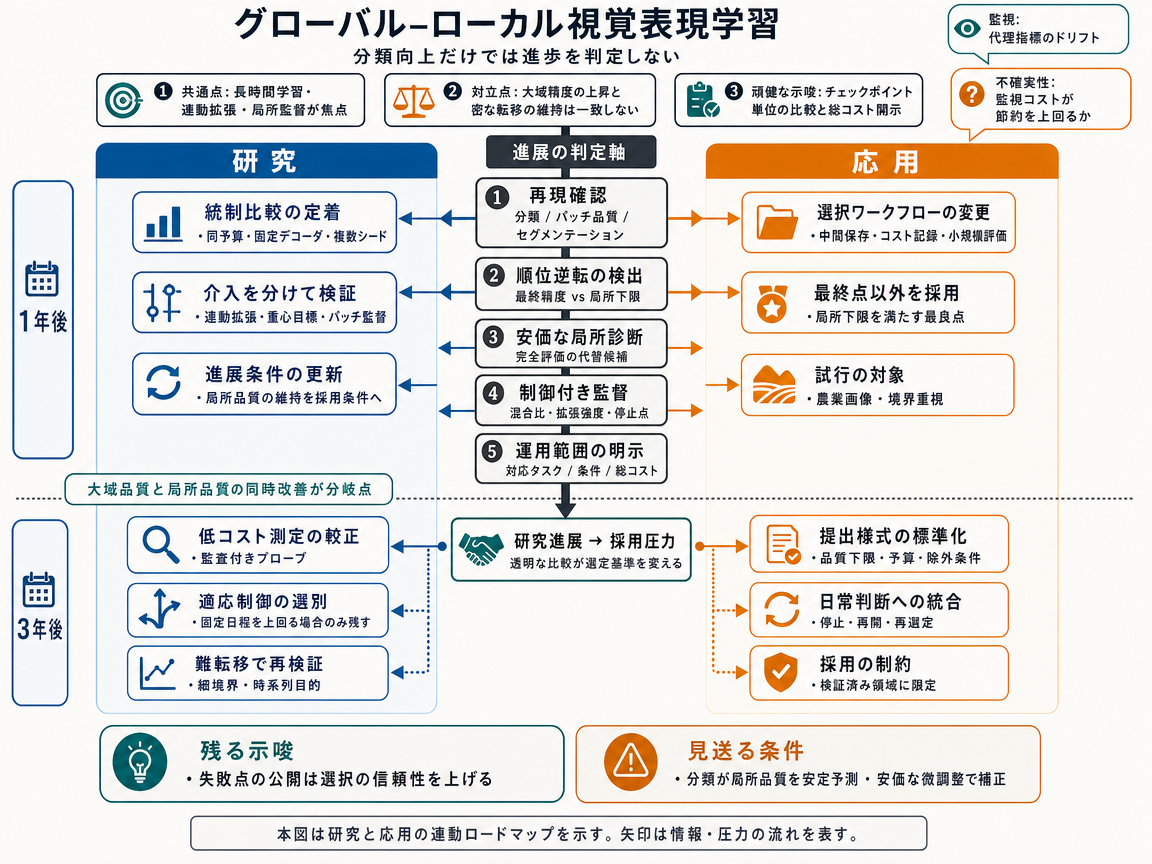
今後3年で、この経路では、最終的な分類スコアだけでなく、画像全体を扱うタスクと局所タスクの両方で確認された性能に基づいてバックボーンを選ぶようになる。バックボーンとは、複数の下流アプリケーションが共通して利用する基盤的な視覚モデルである。同じ画像を使う場合でも、アプリケーションごとに必要な能力は異なる。1年目には、保存した学習途中のチェックポイントを比較し、長時間の学習が認識性能を高める一方でセグメンテーションを弱めるかを検証する。セグメンテーションは、画像内の領域ごとにラベルを割り当てる処理である。実験では、画像拡張の変更とパッチへの教師信号の変更を切り分け、同程度の計算量で比較する。さらに実験を繰り返し、結果の再現性を確かめる。
重要な監視指標は、分類性能だけで付けた順位と、局所タスクの性能を最低基準以上に保つチェックポイントの順位が、再現可能な形で食い違うことである。この食い違いが評価誤差を超えて複数の学習条件で現れれば、複合的な用途では学習途中のチェックポイントを選べるようになる。2年目には、低コストなパッチ測定から、完全なセグメンテーション評価の結果を十分正確に予測できるかを調べる。ただし、測定が不正確なら目的のタスクに弱いバックボーンを選ぶおそれがあるため、定期的な監査が必要になる。信頼できる検査が整えば、長時間学習の途中で教師信号を調整しやすくなり、対応できるタスクと総計算コストも再利用可能な報告書に記録できる。
3年目には、既知のベンチマークだけに頼らず、学習に使っていない農業画像や時間的な予測課題で、より厳しい試験を行う。パッチが意味をよく捉えていても、セグメンテーションに必要な細部を失う可能性があるため、細い境界や画像内の異なる領域を詳しく調べる。成功した場合は、どのチェックポイントがどのタスクに適するかを、明示した評価条件の範囲内で示せるようになるが、あらゆる用途への転用や本番導入まで保証するものではない。学習記録から弱点を見つけ、学習方法を修正し、下流タスクで確認された効果を根拠に検査を継続するという循環が、この経路を支える。統制実験で性能低下が消える場合や、分類性能から局所品質を安定して予測できる場合、または反復評価の負担が便益を上回る場合には、この経路の重要性は低下する。
提案されている方向は、固定された一つの教師信号の組み合わせを使い続けるのではなく、有用な学習信号が不足している場所に応じて調整することである。重心ベースの目標は、比較的低いコストでパッチ単位の指導を与える。連携させた画像拡張は、学習時に使う複数の画像ビューの関係を意図的に作る。CODIはさらに、画像全体について教師モデルが持つ情報の一部を、パッチ単位の目標へ混ぜる方法を示している。
これらの要素から、学習の進行に応じて教師信号を変える研究経路が考えられる。特に、長時間学習の後半に不足する局所的な情報を補える可能性がある。ただし、提示された内容では、各要素を統合したシステムも、年ごとの開発手順も実証されていない。個別の成果が得られていても、それだけで適応的な方法全体の効果を示すことはできない。
中心となる監視課題は、こうした調整が画像認識だけでなく、局所特徴も改善するかどうかである。長い学習の後半でも局所品質が保たれるかを、特に注意して確認する必要がある。規模を拡大した場合には、各要素が互いを妨げずに機能することも検証しなければならない。したがって3年間の可能性は、構成要素が組み合わせても有効であり、大規模な学習でも局所品質を維持できると示されることに依存する。
今後3年で、この経路では、参加する研究プログラムが計算資源を提供する条件として、画像認識と局所特徴の品質を別々に検査するようになる。出発点は、学習後半に分類性能が向上しても、画素や領域を扱うタスクへの転用性能が低下する可能性である。1年目には、両者の性能曲線を再現し、より強い要件を設ける前に、通常の学習スケジュール変更で不一致を解消できるかを調べる。計算資源を提供するプログラムは、同程度の計算量で比較できるチェックポイント報告規則を作成できる。農業画像や検査画像を使う試行では、用途に合ったセグメンテーションの合格基準を別に定める。
決定的な監視指標は、報告が資源利用の要件となり、アプリケーションがモデルを受け入れるかどうかにも影響することである。必須の試験が変われば、研究者が対処すべき弱点も変わるため、任意の評価表を追加するだけの場合とは効果が異なる。2年目には、参加プログラムが学習後半の実際の性能低下と評価上のばらつきを区別し、タスクごとの許容範囲を調整する。研究者は、連携した画像ビューとパッチ目標の組み合わせを試し、追加した蒸留が計算効率を大きく損なわずに局所品質を保つかを確認する。再現可能な監査ツールが整えば、検査を継続しやすくなり、その結果を資源提供や学習方法の合否判断に反映できる。
3年目には、チェックポイント監査が参加プログラムの標準的な処理工程となり、選ばれたバックボーンを未使用の農業画像や検査データで再評価する可能性がある。次フレーム予測へ広げる場合は、静止画像向けのベンチマークをそのまま使わず、時間変化を測れる試験が必要になる。評価タスクを定期的に入れ替え、異なる領域で検査を繰り返せば、固定されたセグメンテーション試験だけへの過剰な最適化を抑えられる。独立した追試と、より適切なバックボーン選択を示す試行結果が得られれば、この経路の根拠は強まる。ただし、提示された証拠だけでは本番環境への導入まで確認されていない。学習スケジュールの変更だけで問題が解決する場合や、必須報告が受け入れられない場合、または監査から有用な情報が得られない場合には、結果は限定的または任意の報告にとどまる。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- Centroid-centered Modeling for Efficient Vision Transformer Pre-training - 著者: Xin Yan, Zuchao Li, Lefei Zhang, Bo Du, and Dacheng Tao / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Enhancing Contrastive Learning Inspired by the Philosophy of "The Blind Men and the Elephant" - 著者: Yudong Zhang, Ruobing Xie, Jiansheng Chen, Xingwu Sun, Zhanhui Kang, Yu Wang / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Self-Distillation for Supervised Fine-Tuning - 著者: Wenxuan Zhu, Bang An, Shuming Liu, Wenqing Cui, Tianqi Xu, Bing Li, Yibo Yang, Peter Wonka, Bernard Ghanem / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- TamedFlow: Trajectory-Aware Distillation\\for Teacher-Assisted Diffusion Sampling - 著者: Shuaiqi Cheng, Jiahao Zhang, Boyuan Gu, Siyu You, Yuxi Chen, Haiying Xu, Zexin Lu, Huiyu Zhou, Xuming Hu / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- MoDDiT: Simple Token Routing in Diffusion Transformers - 著者: Jarek Liesen, Matthew T. Jackson, Benjamin Ellis, Shimon Whiteson, Jakob N. Foerster / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- CODI: Improving Self-Supervised Vision Transformers with Cross Distillation - 著者: Siran Dai, Qianqian Xu, Peisong Wen, Yang Liu, Xiaochun Cao, Qingming Huang / <See Details on Fugu-MT> / ライセンス: CC BY 4.0