サマリー
今週の研究は、予測的世界モデルやより豊かな接触フィードバックを統合することで、反応的制御を超えるロボットマニピュレーションシステムに焦点を当てている。代表的な論文は、物理的推論を身体的インタラクションを通じて学習し、物理的整合性のベンチマークで評価すべきと主張し、巧緻なスキルには簡略化された信号を超える触覚センシングが必要であるとしている。今週の進展論文は、触覚を活用したポストトレーニング、不確実性に基づくゲーティングによるセンシング、長期的タスクのための構造化された計画により、これらの方向性を強化している。
テーマの状況
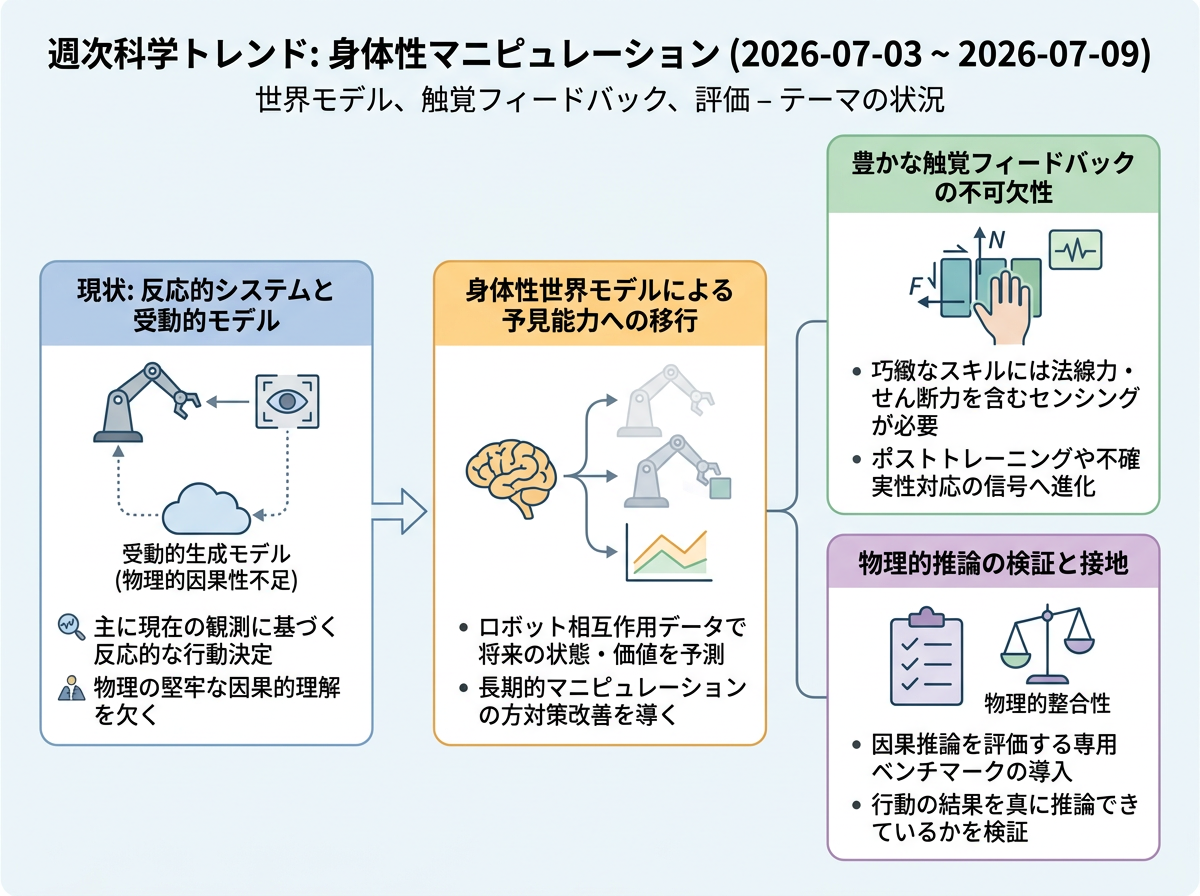
現在のマニピュレーション向け視覚言語行動(VLA)システムは大部分が反応的であり、将来のシーン変化を予測するのではなく、現在の観測に基づいて行動を決定している。受動的な動画生成モデルはフォトリアリスティックな出力を生成できるが、物理の堅牢な因果的理解を欠いており、真の物理的推論を必要とするシナリオでは失敗することが多い。これに対し、近年の研究では、大規模なロボットインタラクションデータで訓練された身体性世界モデルを、将来の状態と価値を予測して方策改善を導くことで、長期的マニピュレーションに予見能力を提供する手段として位置づけている。
このテーマは予測モデルの構築にとどまらず、それらの検証と接地にまで及ぶ。代表的な論文の一つは、物理的整合性、因果推論、指示追従を評価するために特別に設計されたベンチマーク(WoWBench)を導入しており、モデルが行動の結果について真に推論しているかどうかを検証する動きを反映している。別の論文は、巧緻なマニピュレーションがより豊かな接触フィードバックに依存することを強調しており、制御されたスライディングやハンド内並進には法線力とせん断力を含む触覚センシングが必要であり、特に簡略化されたシミュレーション信号ではsim-to-real転移に不十分である場合に重要であるとしている。
- Learning In-Hand Translation Using Tactile Skin With Shear and Normal Force Sensing
- WoW: Towards a World omniscient World model Through Embodied Interaction
- GigaBrain-0.5M*: a VLA That Learns From World Model-Based Reinforcement Learning
インフォグラフィクス(日本語)
今週の進展
TACO: TActile World Model as a Self-COrrector forScalable VLA Post-Training <See Details on Fugu-MT>
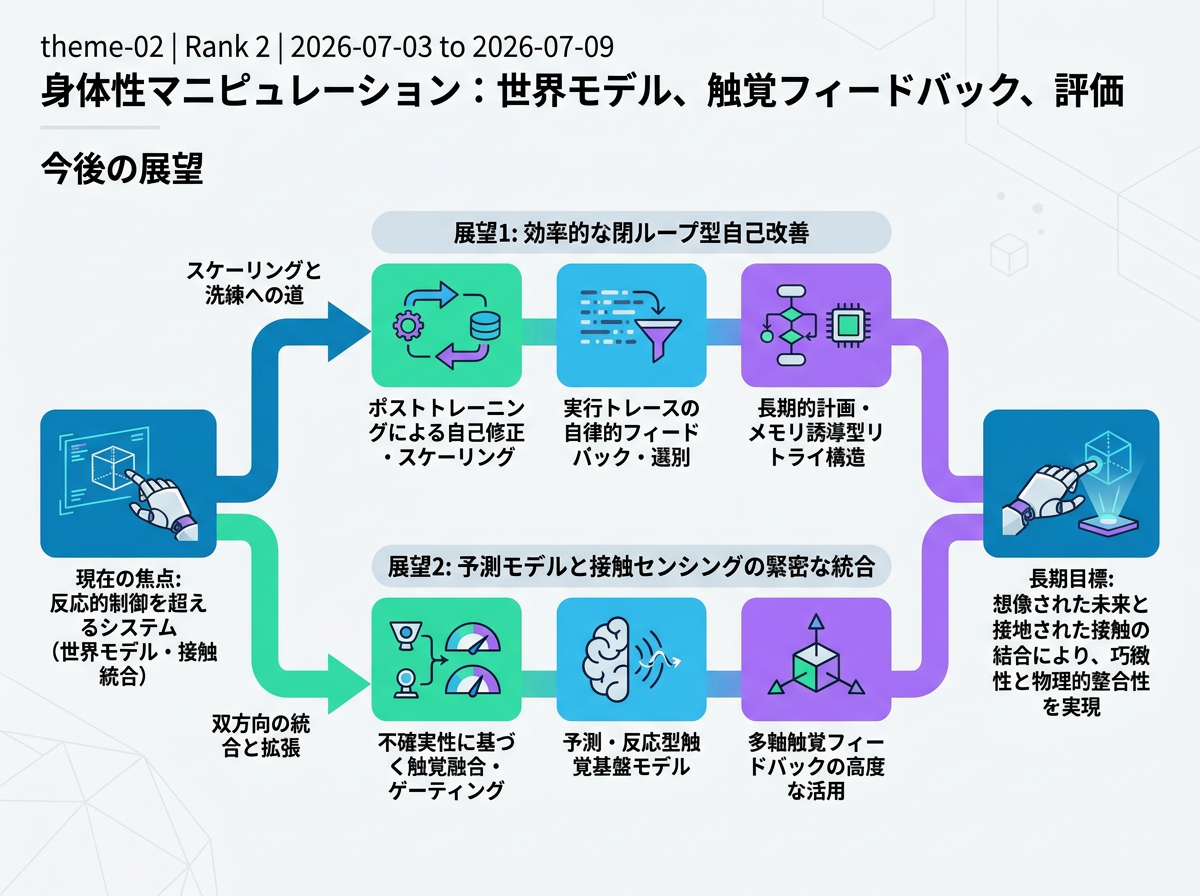
TACOは触覚対応世界モデルを用いて、接触の多いマニピュレーションタスクにおけるVLA方策のポストトレーニング中に自己修正を行う。 触覚フィードバックを実行時の制御入力としてのみ使用するのではなく、スケーラブルなポストトレーニング信号に変換している。
Feeling the Unexpected: ResTacVLA for Contact-Rich Manipulation via Residual Tactile Representation <See Details on Fugu-MT>
ResTacVLAは疎な触覚信号をより密な残差表現に変換し、接触の多いマニピュレーションに活用する。 視覚事前情報の不確実性に基づいて触覚統合を適応的にゲーティングし、予期しない接触下でのマルチモーダル融合を洗練している。
TouchWorld: A Predictive and Reactive Tactile Foundation Model for Dexterous Manipulation <See Details on Fugu-MT>
TouchWorldは巧緻マニピュレーション向けに予測的かつ反応的な触覚基盤モデルを提示する。 予見と即時触覚応答を別々のモジュールとして扱うのではなく、単一モデルに統合している。
Cortex: A Bidirectionally Aligned Embodied Agent Framework for Long-horizon Manipulation <See Details on Fugu-MT>
Cortexは高レベルVLMから低レベルVLAへ実行可能なサブタスク計画を伝達することで、長期的マニピュレーションに対処する。 標準的なVLA方策の純粋に観測駆動型でマルコフ的な性質を克服するため、双方向の計画構造を追加している。
Harness VLA: Steering Frozen VLAs into Reliable Manipulation Primitives via Memory-Guided Agents <See Details on Fugu-MT>
Harness VLAはメモリ誘導型エージェントフレームワークを通じて、凍結されたVLAをリトライ可能な接触の多いプリミティブに誘導する。 ワンショットの反応的方策に頼るのではなく、実行トレース、成功ルール、失敗モデルに基づいて行動選択を接地している。
CoorGrasp: Coordinated Contact Control for Adaptive Dexterous Grasping Under Uncertainty <See Details on Fugu-MT>
CoorGraspは形状・姿勢の不確実性下での適応的巧緻把持のための触覚駆動モデル予測制御器を提案する。 不確実な把持実行中に協調的な接触制御を導入し、触覚フィードバックの役割を簡略化された二値信号を超えて拡張している。
今後の展望
今後の展望(要約)
当面の身体操作研究では、必要な場面に絞った世界モデルの展開、より大規模な相互作用データ、実行記録を使った方策の自動改善が進む可能性が高い。計画の構造化、過去の失敗を踏まえた再試行、触覚データによる追加学習は、接触時の失敗からの回復に役立つだろう。今後は、予測された未来と物理法則に沿った触覚信号を結び付けるとともに、センサー間の干渉や不確実性、多軸の触覚情報が必要になるという課題への対応が重要になる。
インフォグラフィクス(日本語)
3年後を想定した動き
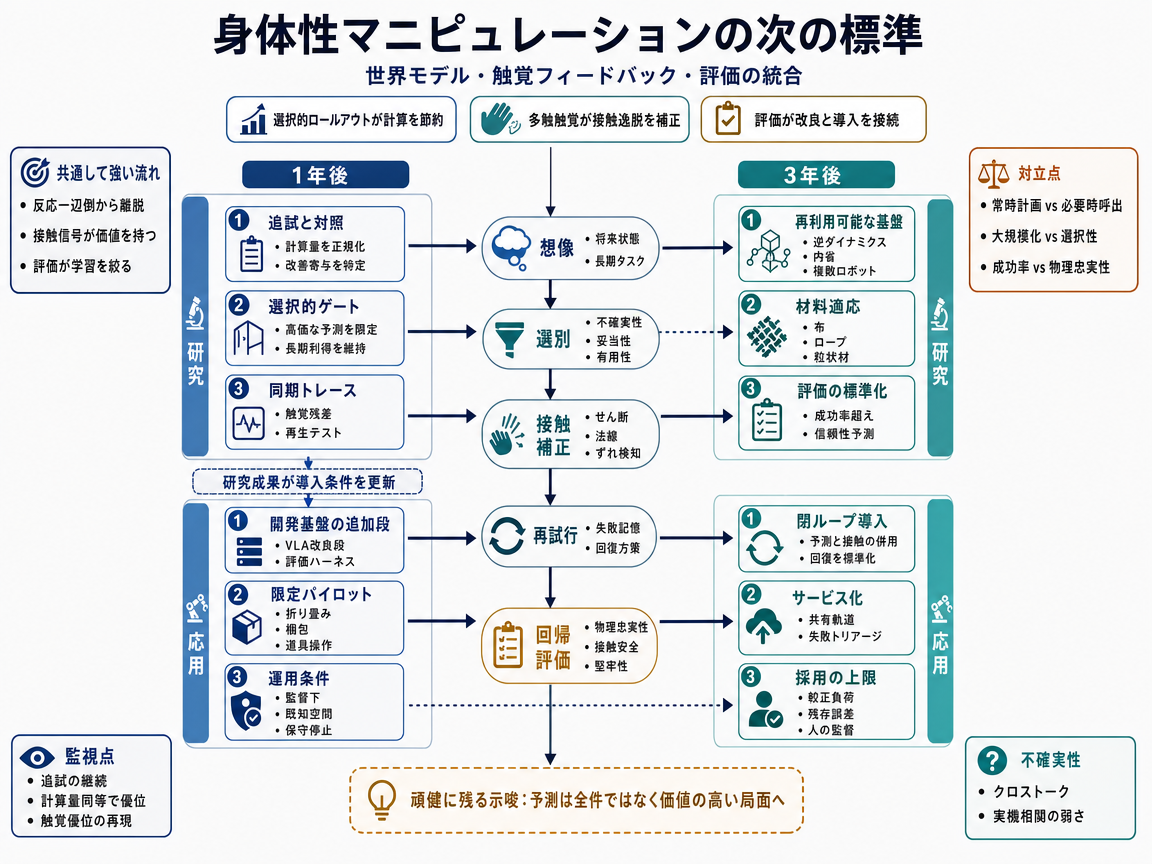
標準シナリオでは、未来予測、接触検知、物理的一貫性の確認を一つのロボット学習手順に統合する。世界モデルが将来の状態を想像し、触覚センサーが実際の接触を捉え、評価機構が基本的な物理法則に反する未来を除外する。これにより、直近の観測だけに反応し、初期の接触判断が後の動作に及ぼす影響を見落としやすい方策から前進できる。
1年目には、布を畳む作業、物を詰める作業、道具の操作など、長い手順を要する課題でこの仕組みを検証する。生成された例をすべて採用するのではなく、不確実性や物理的な妥当性、学習への有用性に基づいて想像上の軌道を選ぶ方法が増えるだろう。触覚測定は再試行の判断にも使われ、過去の失敗を次の動作に反映させる。重要な基準は、計算条件をそろえたときに、未知の接触中心課題で再現可能な改善が得られるかどうかである。さらに、物理的一貫性の評価値が実機での成功を予測できる必要がある。
2年目には、成果の出た方法が複数種類のロボットから集めた大規模データへ広がる。予測モデルと触覚モジュールの結び付きが強まり、逆動力学の仕組みが望ましい未来状態を候補行動へ変換する。物理フィルターが訓練データを整え、そのデータが信頼性を高め、成功した実行が次の更新に役立つ記録を生む循環が形成される。
3年目には、この改善基盤が、変形しやすい物体や材質に敏感な物体を扱う一部の課題を支える可能性がある。少数例から物性を推定できれば、方策全体を作り直さずに、未知の材質へ動力学モデルを適応させられる。再利用可能な研究基盤では、未来の想像、接触後の修正、再試行が標準部品として接続されるだろう。注目すべき指標は、せん断方向と法線方向の触覚を組み合わせる効果が、計算条件をそろえた複数研究機関で確認されることである。この道筋は、予測された未来が物理的に不自然なままの場合や、実機結果を再現できない場合、計算量をそろえると改善が消える場合には弱まる。
対抗シナリオでは、高コストな予測モデルを常時動かさず、必要なときだけ利用を引き上げる。通常の接触は高速な局所方策が処理し、触覚信号と予測誤差を軽量な監視機構へ送って課題の難しさを推定する。不安定さや不確実性が学習済みの基準を超えた場合にだけ、世界モデルへ問い合わせる。この仕組みは、長期的な動作性能を保ちながら、遅延と不要な想像軌道を減らすことを狙う。
1年目には、条件付きで予測を使う方式を、常時プランニングする方式や小型の統合方策と共通の計算条件で比較する。警告信号には、予想外のせん断力、繰り返される再試行、予測状態と観測状態の不一致などが使われるだろう。初期のシステムでは既存の安全機構を維持しつつ、どの時点で高度な処理へ移るはずだったかを記録する試験運用が中心になる。決め手は、危険または重要な接触事象を見逃さずに計算使用量を減らせるかどうかである。
2年目には、評価課題を通常部分と困難部分に分け、適切な時点で高度な処理へ移れたかを調べる。開発基盤には、センサー値、予測された未来、物理的な結果を同じ時間軸に並べる触覚記録装置が加わる可能性がある。すべての実行記録を同じように扱わず、情報量の多い失敗をモデル改善に優先利用できるようになる。良い失敗記録が監視機構を改善し、改善された監視機構がさらに価値の高い事例を集める循環が生まれる。
3年目には、高速な機体側の反応と低速な予測処理を分離する制御基盤へ発展する可能性がある。ロボット側では触覚方策と難易度監視を動かし、重い処理系は珍しい状態について反実仮想の展開を生成する。受け入れ試験では、課題当たりの計算量、処理移行の遅延、予測処理を利用できない場合の安全動作を報告する必要がある。重要な観測点は、触覚の残差と再試行履歴が視覚だけの場合より正確に失敗を予測するという結果が、異なるロボットでも確認されることである。この道筋は、小型の局所モデルが現実的な消費電力と遅延の範囲で同等の性能を示す場合や、触覚ノイズのため移行基準を材質やセンサー間で安定させられない場合に弱まる。
可能性シナリオの中心は、接触を多く含むロボット学習を実行記録によって管理する保証層である。この層は予測状態、触覚の証拠、実行結果を記録し、失敗を再生して比較できるようにする。また、方策を実機試験へ進めてよいかも判定する。この仕組みは、想像された未来が物理法則に反する問題と、未選別の展開を大量生成して計算を浪費する問題に対応する。
1年目には、主要な研究グループがロボットの行動を接触信号や再試行結果と時間的に同期させる。記録からは、滑り始めの見落とし、安定接触の誤予測、回復動作の反復といった問題が明らかになる。触覚シミュレーターは難しい接触変化を再現し、共通の記録形式は失敗の分類を容易にする。実用上の基準は、少数の情報量の多い失敗を再生する方が、未選別の想像軌道を大量生成するより効率よく方策を改善できるかどうかである。
2年目には、異なるロボットに共通する接触事象を中心として、小規模な実行記録集が整備される。研究者は、滑りや変形、接触予測の誤りを含む事例が、異なる方策やセンサーでも意味を保って再生できるかを調べる。方策の更新版は、まず過去記録による再生試験を受け、次に制限付きの実機試験を通過してから、より広い課題へ進むようになる。質の高い記録が失敗分類を明確にし、その分類が展開の選別を改善して、次の有用な記録を生む循環が形成される。
3年目には、世界モデルと触覚シミュレーターを、接触時や回復時に許容される動作範囲と照合できるようになる。実用システムには、校正記録、接触に関する回帰試験の結果、承認済みの動作条件が含まれる可能性がある。保証層はこれらの証拠を使い、特定の接触分類を処理できるモデルと方策の組み合わせを決める。強い観測指標は、複数種類の信号を含む実行記録データが登場し、その再生結果に基づく公開前審査が実機の失敗を予測することである。このシナリオは、再生試験の成績が実機へ移らない場合や、センサー種類が違うと比較できない場合に弱まる。大規模な一体型モデルが記録に基づく触覚検証なしで物理的な誤りを解消した場合にも、その必要性は低下する。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- Learning In-Hand Translation Using Tactile Skin With Shear and Normal Force Sensing - 著者: Jessica Yin, Haozhi Qi, Jitendra Malik, James Pikul, Mark Yim, Tess Hellebrekers, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- WoW: Towards a World omniscient World model Through Embodied Interaction - 著者: Xiaowei Chi, Peidong Jia, Chun-Kai Fan, Xiaozhu Ju, Weishi Mi, Kevin Zhang, Zhiyuan Qin, Wanxin Tian, Kuangzhi Ge, Hao Li, Zezhong Qian, Anthony Chen, Qiang Zhou, Yueru Jia, Jiaming Liu, Yong Dai, Qingpo Wuwu, Chengyu Bai, Yu-Kai Wang, Ying Li, Lizhang Chen, Yong Bao, Zhiyuan Jiang, Jiacheng Zhu, Kai Tang, Ruichuan An, Yulin Luo, Qiuxuan Feng, Siyuan Zhou, Chi-min Chan, Chengkai Hou, Wei Xue, Sirui Han, Yike Guo, Shanghang Zhang, Jian Tang, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- GigaBrain-0.5M*: a VLA That Learns From World Model-Based Reinforcement Learning - 著者: GigaBrain Team, Boyuan Wang, Chaojun Ni, Guan Huang, Guosheng Zhao, Hao Li, Jie Li, Jindi Lv, Jingyu Liu, Lv Feng, Mingming Yu, Peng Li, Qiuping Deng, Tianze Liu, Xinyu Zhou, Xinze Chen, Xiaofeng Wang, Yang Wang, Yifan Li, Yifei Nie, Yilong Li, Yukun Zhou, Yun Ye, Zhichao Liu, Zheng Zhu, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0