サマリー
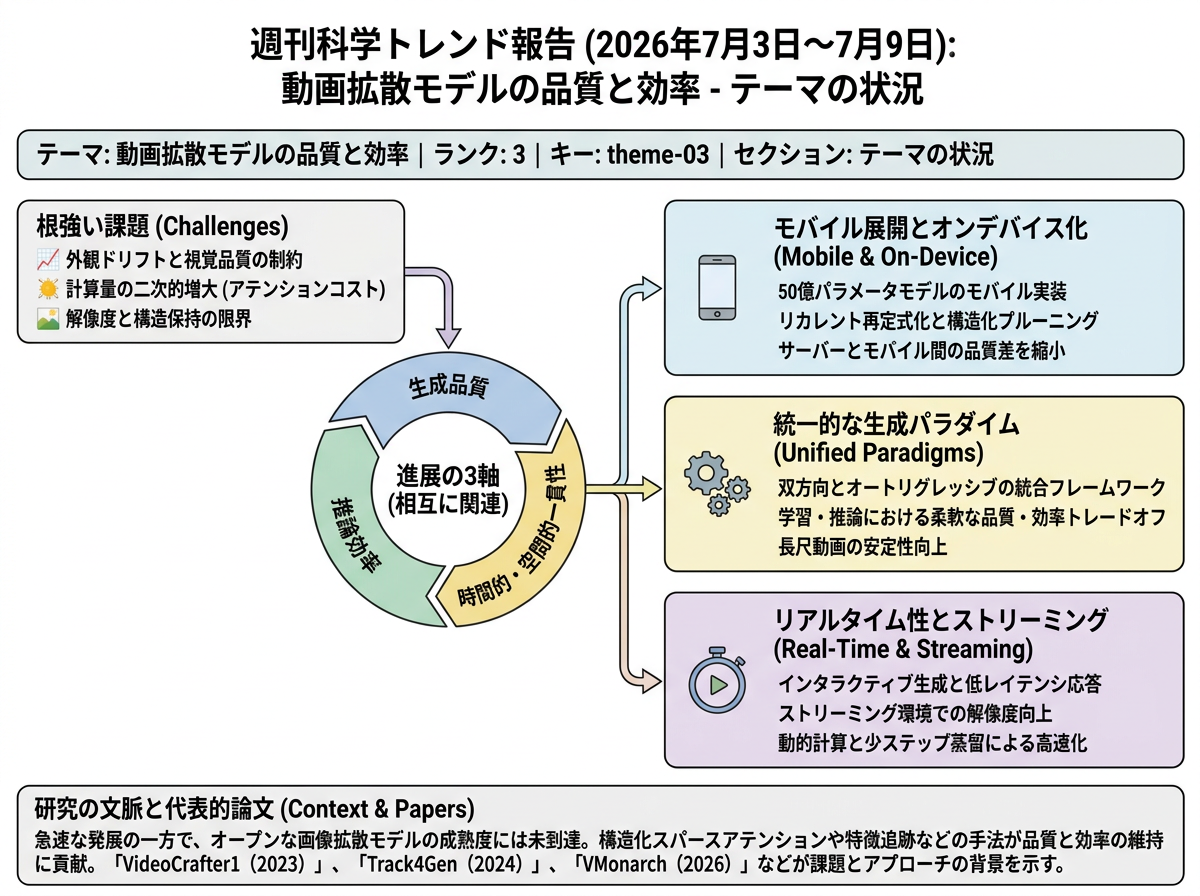
今週の動画拡散モデルに関する研究は、生成品質、時間的・空間的一貫性、推論効率という相互に関連する3つの軸で進展した。代表的な論文は、オープンな動画基盤モデルにおける外観ドリフト、解像度の制約、二次的に増大するアテンションコストといった根強い課題を浮き彫りにしつつ、今週の進捗はこれらの課題をモバイル展開、統一的な生成パラダイム、リアルタイムストリーミング環境へと押し進めている。
テーマの状況
代表的な論文の序論では、動画拡散の分野は急速に発展しているものの、オープンな画像拡散のアクセシビリティや成熟度にはまだ及ばない状況が描かれている。従来のオープンなテキストから動画・画像から動画モデルは、低解像度、不十分な視覚品質、フリッカー、目に見えるノイズ、制限された動き、入力コンテンツや構造の保持が弱いといった制約があるとされ、より新しいモデルでも、標準的な拡散の教師信号がフレーム間の空間的対応を明示的に強制しないため、外観ドリフトに悩まされている。
同時に、動画拡散トランスフォーマーをより長尺・高解像度の生成にスケールさせると、アテンションが中心的なボトルネックとなり、計算量がシーケンス長に対して二次的に増大する。代表的な研究は、構造化スパースアテンションや特徴レベルの追跡教師信号を、品質と一貫性を法外なコストなしに維持する手段として強調しており、最近の補足的な論文は同様のロジックをリカレント型、モバイル型、リアルタイム動画生成の設定へと展開している。
- VideoCrafter1: Open Diffusion Models for High-Quality Video Generation
- Track4Gen: Teaching Video Diffusion Models to Track Points Improves Video Generation
- VMonarch: Efficient Video Diffusion Transformers with Structured Attention
インフォグラフィクス(日本語)
今週の進展
MobileWan: Closing the Quality Gap for Mobile Video Diffusion <See Details on Fugu-MT>
MobileWanは50億パラメータの動画拡散モデルを市販モバイルハードウェア上に展開し、リカレント再定式化と構造化プルーニングにより480×832の5秒間動画を20秒で生成する。 大規模動画拡散をサーバー専用環境からオンデバイス展開へと移行させ、モバイルとサーバー規模の生成間の品質差を縮小した。
Flex-Forcing: Towards a Unified Autoregressive and Bidirectional Video Diffusion Model <See Details on Fugu-MT>
Flex-Forcingは双方向とオートリグレッシブの動画拡散を単一の学習・推論フレームワーク内で統合し、テスト時に柔軟な品質・効率のトレードオフを可能にする。 一つのパラダイムに固定される従来手法とは異なり、単一モデルで双方向・オートリグレッシブ・ハイブリッドモードの動作が可能となり、長尺動画の安定性が向上した。
Dynamic-in-Few-Step: Unifying Dynamic Computation and Few-Step Distillation for Efficient Video Generation <See Details on Fugu-MT>
Dynamic-in-Few-Stepは動的構造スパース性と少ステップ蒸留を組み合わせた、動画拡散の学習後高速化フレームワークを提案する。 アテンションのみの再設計ではなく、モデル全体の冗長な計算を対象とし、学習後にコストを削減する。
Vidu S1: A Real-Time Interactive Video Generation Model <See Details on Fugu-MT>
Vidu S1は標準GPUで最大42FPSのリアルタイムインタラクティブ動画生成を実現し、音声によるコンテンツ制御を可能にする。 動画拡散の効率化をオフラインバッチ生成から、レイテンシが第一級の制約となる応答性の高いインタラクティブ利用へと拡張した。
Wan-Streamer v0.2: Higher Resolution, Same Latency <See Details on Fugu-MT>
Wan-Streamer v0.2はネイティブストリーミング型の視聴覚動画拡散システムの出力を192×336から640×368に引き上げつつ、モデル側の応答レイテンシを約200msに維持する。 コンテキスト並列生成によるサービングトポロジーの再構成により、ストリーミング動画拡散システムが追加レイテンシなしに解像度を向上できることを実証した。
今後の展望
今後の展望(要約)
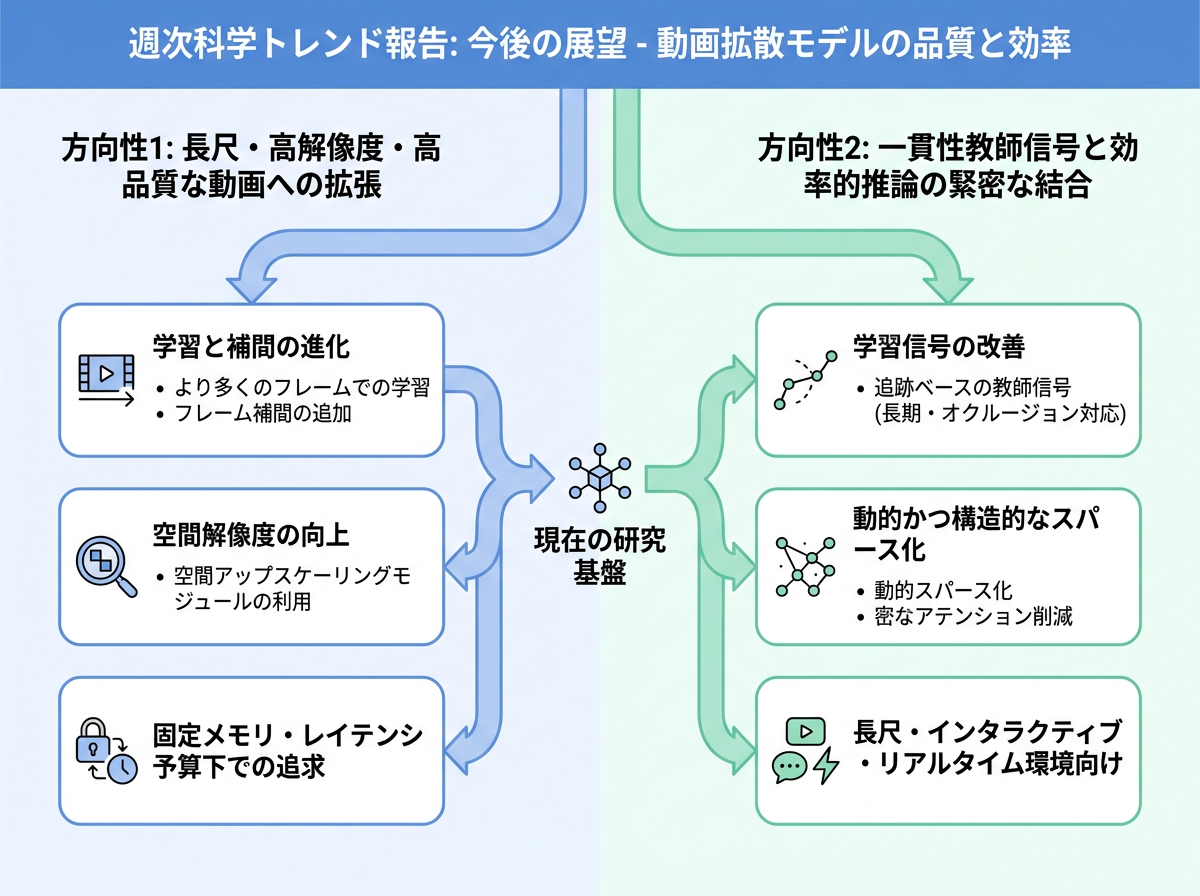
短期的な動画拡散研究では、限られたメモリと待ち時間の範囲内で、動画の長時間化、高解像度化、動きの改善が進むだろう。より多くのフレームを使う学習、フレーム補間、空間的な高解像度化が、データ品質の向上とともに主要な手法になると考えられる。一貫性を高める学習と効率的な推論の統合も進み、追跡技術が見た目のずれを抑え、動的なスパース化が注意機構の計算量を減らす。これらの進展により、生成機能の統合やリアルタイム配信が可能になり、特に長時間動画や対話型システムで活用が広がるだろう。
インフォグラフィクス(日本語)
3年後を想定した動き
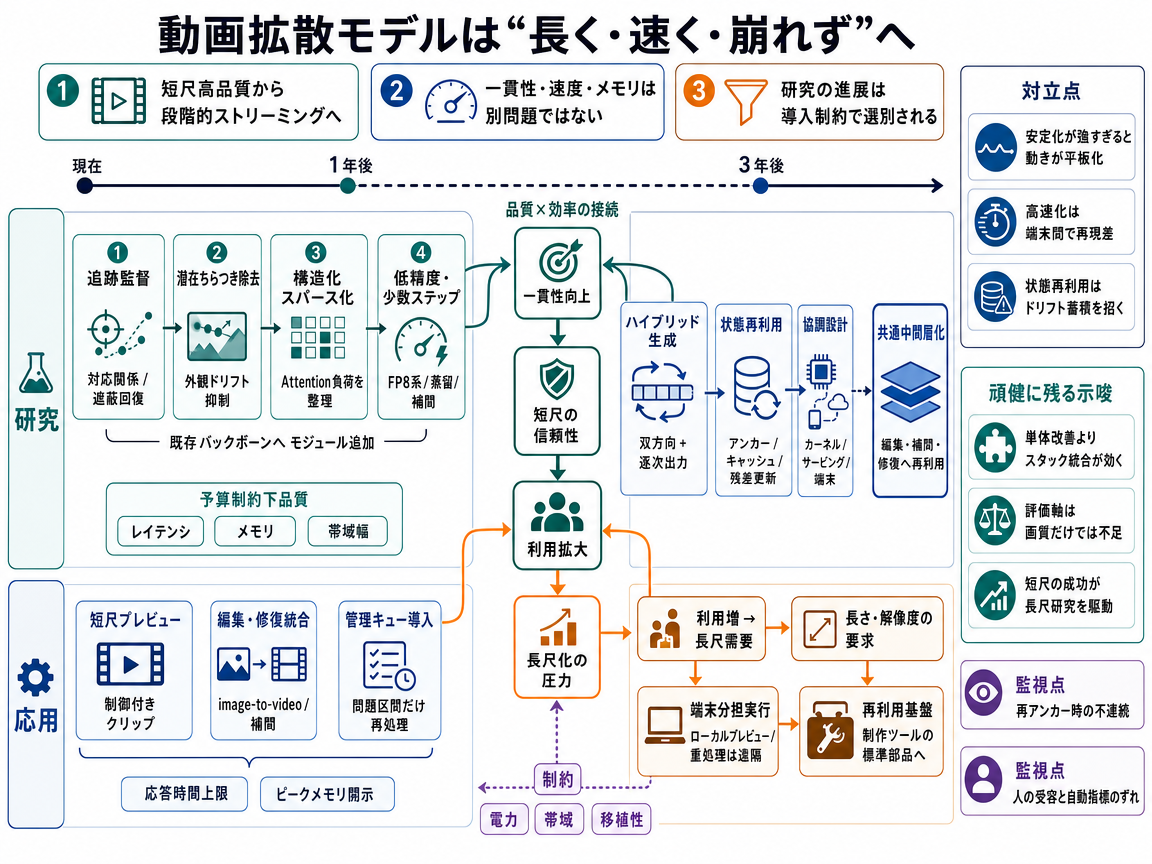
標準シナリオでは、動画生成を個別モデルの改良の集まりではなく、システム全体の課題として扱う。時間方向の安定性、出力品質、効率を同時に改善する必要がある。追跡に基づく教師信号は継続的な監視のように働き、物体の外観をフレーム間で保ちやすくする。スパース注意と低精度計算は、すべての部分に同じ計算量を使わずに処理コストを下げる。
1年目には、研究者が既存のオープンな基盤モデルへこれらの手法を追加する。追跡損失やちらつき除去機構が一貫性を改善し、構造化スパース化が現実的なメモリ制約の下で動画を長くするだろう。ただし、一貫性の制御によって望ましい動きまで弱まらないかを検証しなければならない。再現可能なシステムでは、高速生成や補間を効率的な実行環境と組み合わせ、品質と資源使用量の両方を報告するようになる。初期の応用はアニメーション、編集、修復などの制御しやすい作業が中心となり、無制限の長時間生成よりも段階的なプレビューが重視される。
2年目には、双方向の改善処理と自己回帰生成を組み合わせたハイブリッド方式が進むと考えられる。双方向処理は時間軸の前後の文脈を利用し、自己回帰処理は新しい内容を順番に生成する。遮蔽を考慮した追跡により、人や物体が一度隠れて再び現れた後も、同一性を保ちやすくなる。3年目には、移植しやすいスパース形式と小型キャッシュにより、一部の端末でローカルプレビューが可能になり、重い処理は端末とサーバーで分担される可能性がある。重要な観測点は、異なる機器でも待ち時間、メモリ、消費電力を一定にしたとき、品質が安定するかどうかである。動画の長さが伸びない場合や高速化が他の環境で再現できない場合、また動きが目に見えて静的になる場合には、このシナリオの実現性は低下する。
対抗シナリオでは、動画拡散を状態を保持する生成コーデックとして再構成する。基準となるアンカーフレームが外観と場面の意味を定め、追跡される状態が安定した情報を後続フレームへ運ぶ。残差処理は各フレームを最初から作り直さず、意味のある変化だけを更新する。制御機構は動き、不確実性、応答時間の制約に応じて、更新頻度と処理量を変える。
1年目には、研究チームが既存の動画基盤モデルへ持続的な状態を追加する。試作システムでは遮蔽対応の追跡と選択的な改善処理を試し、物体が画面外へ消えて戻った後に同一性を回復できるかを測る。また、本当の一貫性と、単に動きが止まっている状態を区別する必要がある。その後は、新しいアンカーを作る時点、動かす注意機構の量、生成ステップ数を制御機構が判断できるように学習させる。初期の用途はアニメーション、修復、対話型プレビューなどが有力であり、既存画像や編集済みフレームを信頼できるアンカーとして利用できる。
2年目には、アンカー生成、時間状態、適応制御を結び付けた統合学習システムへ発展するだろう。共通の状態インターフェースが整えば、制御機構や最適化部品を複数のオープンモデル間で移しやすくなる。長時間の実行から、遅れて生じるずれや回復失敗の証拠が得られ、更新方針の改善に使われる。3年目には、同じ基盤を設定によって切り替え、モバイル端末でのプレビュー、対話型配信、高品質な描画に対応できる可能性がある。安定した区間では処理を減らし、不確実性が上がったときには積極的に情報を更新する。重要な観測点は、同じシステム全体の資源制約の下で、適応的な更新が固定間隔の更新を上回るかどうかである。遮蔽後に誤差が蓄積する場合や制御の負担が節約分を消す場合、また単純な効率化モデルが同等の持続品質を達成する場合には、このシナリオの優位性は弱まる。
可能性シナリオでは、オープンな動画拡散モデルを運用制御層の内側に置き、すべての動画を一つのモデルだけで処理しない。この層は測定された品質と資源制約に応じて、各区間を生成、修復、人による確認へ振り分ける。追跡検査とちらつき検査がセンサーの役割を果たし、振り分け方針が失敗区間の再処理や人への引き継ぎを決める。目的は常に最高の映像品質を得ることではなく、定めた品質範囲を保ちながら、生成と修正に必要な総作業量を減らすことである。
1年目には、元の内容の保持、時間方向の安定性、十分な動きを評価する検査が整備される。システム全体は、個別モデルの結果だけでなく、一定のメモリと応答時間の制約下で評価される。回帰テストには、遮蔽、場面転換、急速なカメラ移動などの難しい事象を含める必要がある。初期導入はアニメーション、修復、組織内の可視化など、もともと人の確認が含まれる限定的な作業に向くだろう。不合格となった動画は、外観のずれや動きの抑制を示す構造化データとなり、振り分け規則の継続的な改善に役立つ。
2年目には、共通の時間評価と不確実性推定により、自動指標が信頼できない状況を制御機構が認識しやすくなる。制御層は、すべての作業を一つのモデルに固定せず、高速生成、慎重な修復、人への引き継ぎを選べるようになる。3年目には、モデルやシステムを更新するたびに自動回帰テストへの合格を求める、継続的インテグレーション型の受け入れ制御が使われる可能性がある。オープンな生成モデルは制御層の下で交換可能な部品となり、意味の判断が重要な出力については人が最終権限を持つ。重要な観測点は、自動判定の合格率が人による受け入れを正しく予測し、異なる機器でも手作業の修正時間を減らせるかどうかである。指標と評価者の判断が一致しない場合や一貫性制御で出力が静的になる場合、また修復の負担が当初の速度上の利点を失わせる場合には、このシナリオは弱まる。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- VideoCrafter1: Open Diffusion Models for High-Quality Video Generation - 著者: Haoxin Chen, Menghan Xia, Yingqing He, Yong Zhang, Xiaodong Cun, Shaoshu Yang, Jinbo Xing, Yaofang Liu, Qifeng Chen, Xintao Wang, Chao Weng, Ying Shan / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Track4Gen: Teaching Video Diffusion Models to Track Points Improves Video Generation - 著者: Hyeonho Jeong, Chun-Hao Paul Huang, Jong Chul Ye, Niloy Mitra, Duygu Ceylan, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- VMonarch: Efficient Video Diffusion Transformers with Structured Attention - 著者: Cheng Liang, Haoxian Chen, Liang Hou, Qi Fan, Gangshan Wu, Xin Tao, Limin Wang, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0