サマリー
今週のテーマは、単一ターンのテキスト品質だけでなく、対話的かつ社会的に根拠のある設定におけるLLMの行動評価に焦点を当てている。代表的な論文は、曖昧さ、ユーザーコンテキストの欠如、オープンエンドな社会的判断が現行の評価・学習パイプラインの限界を露呈させることを示し、マルチターン選好手法、人間参加型の展開、人間の判断に整合した顕示行動テストの必要性を動機づけている。
テーマの状況
代表的な論文は共通の課題を提示している。LLMは、単一の流暢な回答だけでは不十分な場面でますます利用されるようになっている。曖昧なユーザー要求に対して、モデルは明確化のための質問をする代わりに推測に基づいて回答する傾向があり、これは明確化の下流での価値を捉えられない単一ターンの選好アノテーションに起因する限界である。エグゼクティブ・コーチングなどの専門的支援場面では、効果的な支援には深い自己省察、対人コンテキストへの感受性、人間の専門家との慎重に範囲を定めた協働が求められる。さらに別の研究では、モデルの自己申告による行動傾向と現実的なシナリオでの顕示行動が乖離しており、最先端モデルでも過信や特性固有のバイアスが持続することが示されている。
これらの研究は、現実的な対話における行動へと評価の方向を推し進めている。モデルの自己報告や孤立した回答のランキングに頼るのではなく、必要な場面で明確化の質問をするか、有用なマルチターン支援を持続できるか、現実的な社会シナリオで人間の選好やコンセンサスに整合した行動を選択できるかを評価する。代表的な論文の導入部は総合的に、静的な回答評価から、社会的に有能で、コンテキストを認識し、行動的に整合したLLMの測定へという転換を記録している。
- Coaching Copilot: Blended Form of an LLM-Powered Chatbot and a Human Coach to Effectively Support Self-Reflection for Leadership Growth
- Modeling Future Conversation Turns to Teach LLMs to Ask Clarifying Questions
- Evaluating Alignment of Behavioral Dispositions in LLMs
インフォグラフィクス(日本語)
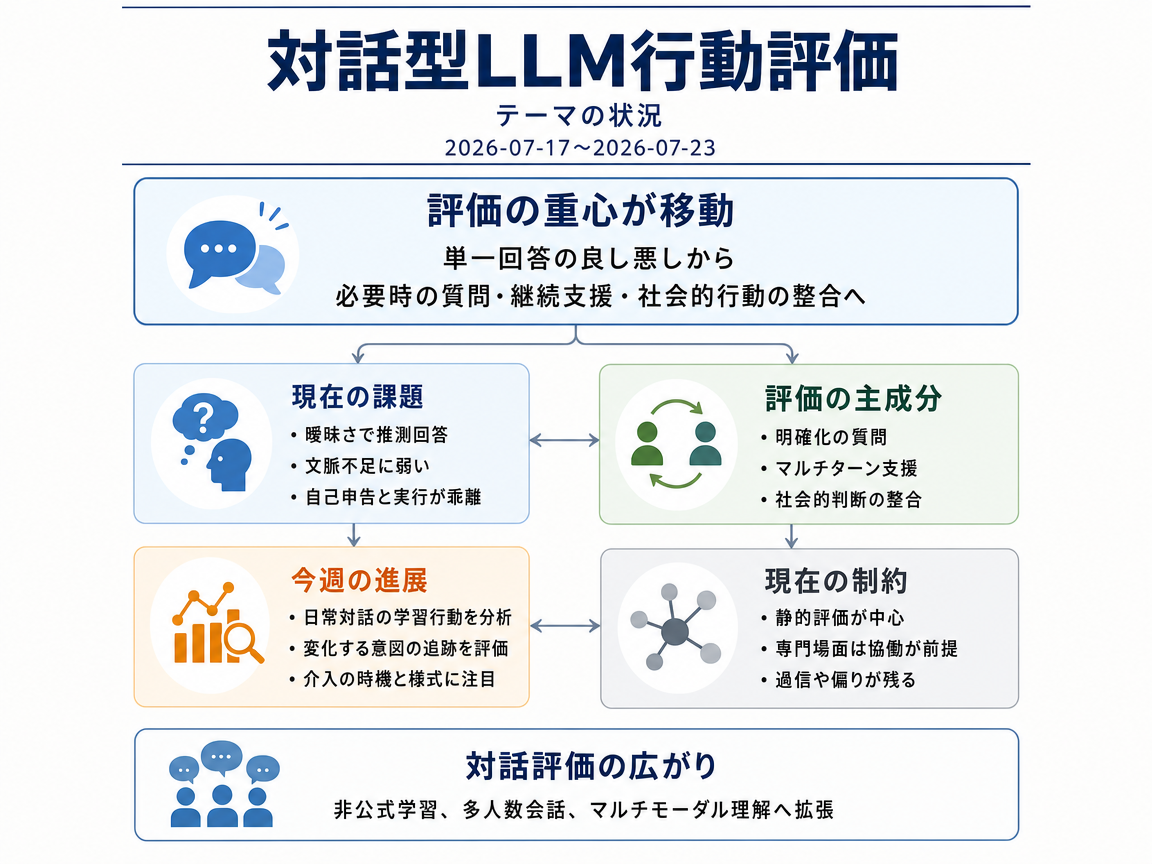
今週の進展
Informal Learning Emerges in Everyday Human-LLM Interaction <See Details on Fugu-MT>
128,569件の自然な人間-LLM対話におけるターンレベルの学習行動を分析し、日常的な対話成果への評価を拡張した。 孤立した回答品質を判断する代わりに、実際のやり取りにおける非公式学習の選択的・条件的な兆候を特定している。
LLMs Get Lost in Evolving User Intent <See Details on Fugu-MT>
静的な単一ターンタスクを、ユーザー意図が進化する動的なマルチターン対話に変換するフレームワークを提案した。 モデルがターンをまたいで変化する意図を追跡する必要がある場合、静的タスクでの高い性能が移転しないことを示した。
LLM-as-a-Coach: Experiential Learning for Non-Verifiable Tasks <See Details on Fugu-MT>
LLMのフィードバックを、オープンエンドで検証不可能なタスクのための経験的学習シグナルに転用した。 ルーブリックベースのRL信号と比較して、コーチングスタイルのフィードバックが未知のタスクでより強い汎化性能を示した。
AI Assistants Overassist <See Details on Fugu-MT>
学生が問題を推論している最中にAIチューターがいつどのように介入すべきかを評価するInt-Benchを提案した。 最終回答ではなく介入のタイミングとスタイルに評価を移行させ、現行のアシスタント行動がこの点で十分に理解されていないことを明らかにした。
MeetingToM: Evaluating Multimodal LLMs on Theory-of-Mind Reasoning in Multi-Party Meetings <See Details on Fugu-MT>
自然な多人数会議における心の理論推論のベンチマークMeetingToMを提案した。 対話型評価をマルチモーダルな社会的理解へと拡張し、社会的粒度の段階的な深化を実現した。
今後の展望
今後の展望(要約)
評価と訓練の中心は、単発の応答から、より長く状況に適応する対話へ移る可能性が高い。システムには、変化する意図を確認し、適切な応答方針を選び、人々の強い合意と正当な意見の違いの両方を反映できるかが問われる。介入のタイミングや自由度の高い助言など、現実的な社会状況に基づく評価も増えるだろう。こうした手法を確認するには、明確なプライバシー保護、安全上の制限、人間による監督を備えた大規模な比較研究が必要になる。
インフォグラフィクス(日本語)
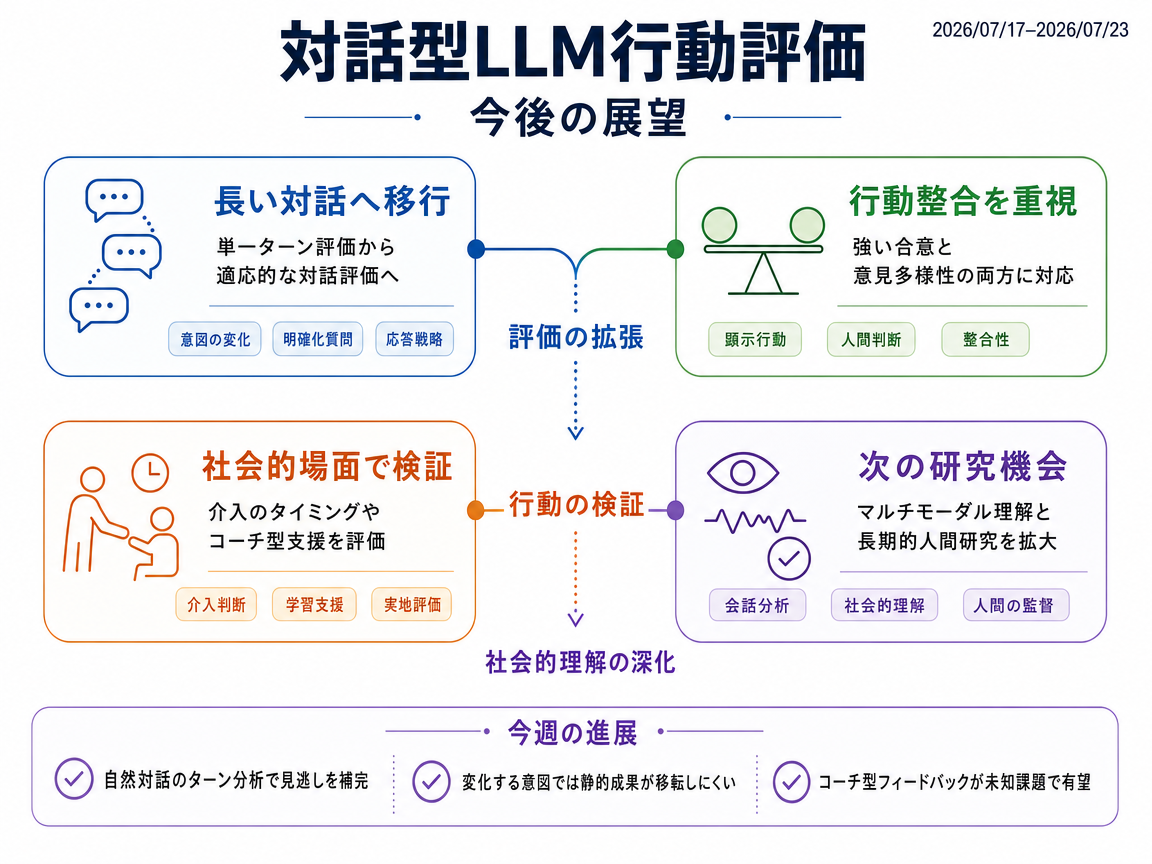
3年後を想定した動き
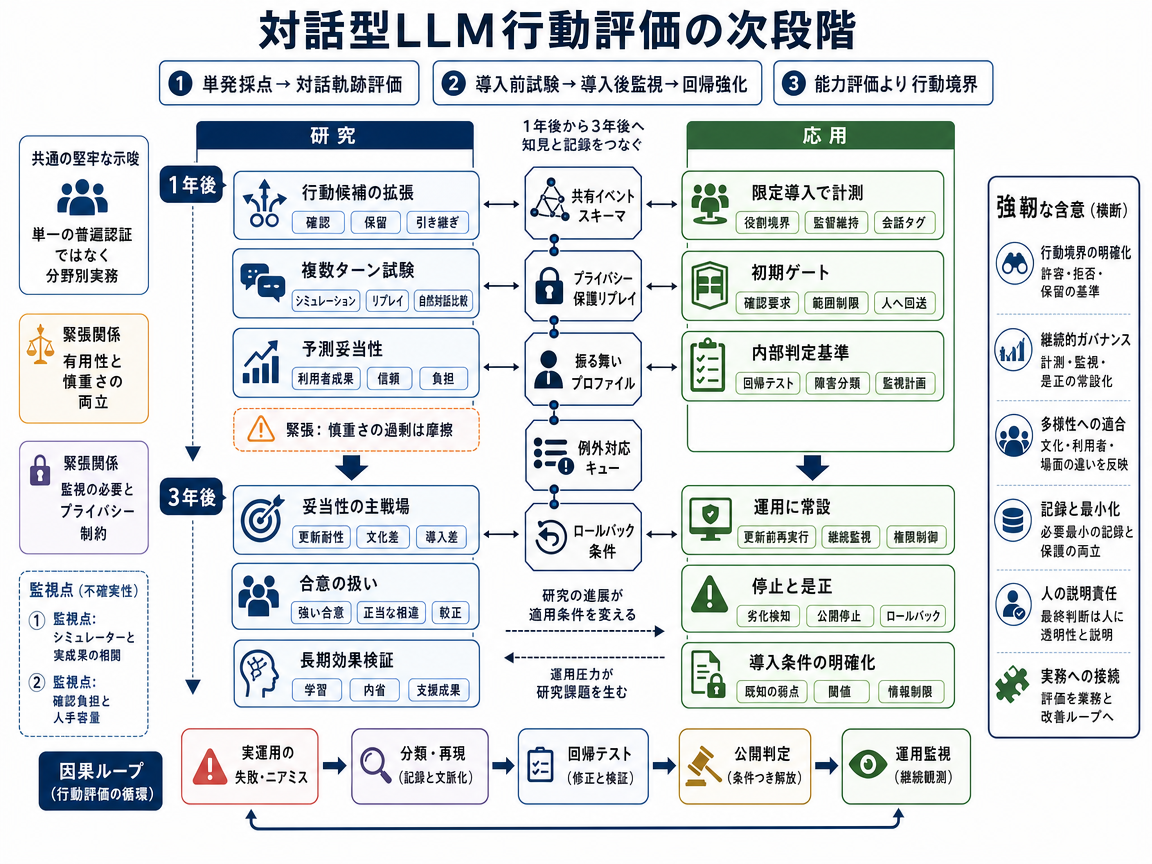
当面の変化は、個別の回答を採点する方法から、対話全体の判断を評価する方法への移行である。1年目には、アシスタントが適切な時点で回答するか、確認するか、判断を保留するかを調べるテストが整備されるだろう。研究者は後続の発話を調べ、その選択が曖昧さを解消し、適切な確信度を保ち、最終結果を改善したかを確認する。
教育支援やコーチングなどの範囲を限定した試行から、現実的な対話記録が得られる。チームは繰り返し起きる失敗を、更新後のシステムが過去の誤りを再発させないか調べる回帰テストに変換できる。これらの記録は、模擬利用者から得た結果が、異なる環境の自然な対話にも当てはまるかを示す材料にもなる。
2年目には、シミュレーター、場面集、対話再生を組み合わせた再利用可能な評価基盤が登場する可能性がある。その得点が実際の利用結果を予測できれば、各システムには、試験済みの条件と弱点を版ごとに示す説明が付くようになる。人間の評価者は、解消されない曖昧さ、慎重に扱うべき情報、不適切な自信といった例外に集中できる。
3年目ごろには、繰り返す不具合を分類して試験へ戻す、継続的な安全監視に似た保証サイクルが日常化しうる。モデル、プロンプト、接続ツールの変更時には、公開前に過去の対話を再生して動作を確認する。確認行動、引き継ぎ時期、プライバシー対応が悪化すれば更新を止めたり戻したりし、問題調査から新しい試験場面を作る。重要な観測指標は、組織が評価画面を示すだけでなく、複数ターンの回帰結果を実際の公開判断に使うことである。一方、模擬対話が自然な会話と一致しない場合や、人を対象とする研究で持続的な効果が示されない場合には、この流れは弱まる。対話行動は文脈や文化で変わるため、単一の普遍的な認証より、利用環境ごとの保証方法が広がる可能性が高い。
当面は、現在の対話から正当化できる範囲だけアシスタントに権限を与え、より長い対話を評価する方向へ進む。これはゼロトラストの考え方に基づき、一つの基準試験に合格しても、その後のすべての行動が無条件に許可されるわけではない。影響の大きい応答は、現在の意図、不確実性、予想される影響に照らして、提示前に確認される。
1年目には、同じ種類の場面で、直接回答、追加質問、人間への引き継ぎを比較する研究が進むだろう。対話記録には、選択の理由と、その後の利用者の反応が残される。提案された応答を提示前に検査する実行時ゲートについては、会話を遅くしたり曖昧にしたりせず、有害な思い込みを減らせることを比較研究で示す必要がある。初期の応用は、教育支援、コーチング、専門業務支援など、範囲を限定した環境が中心になる。試行で見つかった重大化寸前の失敗は回帰テストに変換され、運用の証拠が後の試験と動作規則を改善する循環を作る。
2年目には、確認の失敗、過剰な介入、引き継ぎの見落としについて共通の定義が生まれる可能性がある。評価対象も、モデル単体ではなく、実行時の制御と人間による確認過程を含む一つのシステムへ広がる。研究者は、妥当な意見の違いを一つの回答に押し込めず、文化や長い対話をまたいで制御が機能するかも調べる。
3年目ごろには、文脈への依存が大きい一部のシステムで、継続的な行動検査が通常の公開手順と運用手順に組み込まれる可能性がある。モデル、プロンプト、接続ツールを変更した後は、保存済みの対話経路を再生し、影響の大きい移行には人間の確認を増やす。有力な観測指標は、応答を途中で止められる標準機能が登場し、ゲートの有無を比べる対照実験が行われることである。将来の発話を模擬しても実際の反応を予測できない場合や、確認が有用性を下げる場合には、このシナリオは弱まる。ゼロトラスト制御は権限を制限できるが、目的や好みが正当に異なる場面で、唯一の正しい社会的応答を機械的に決めることはできない。
当面の変化は、一つの回答が良く見えるかではなく、対話全体での行動を測る方向への移行である。研究者は、アシスタントが意図の変化に気づき、訂正後に立て直し、必要なときに人へ制御を渡せるかを調べる。問い合わせ窓口の品質保証は、会話の確認と引き継ぎ規則がすでに存在するため、実践的な検証環境になる。
1年目には、模擬利用者、匿名化した対話再生、人間の判断を比較する研究が進むだろう。対話の経路全体に基づく軌跡指標が、単発評価では見逃される失敗を発見できるかが検証される。重要な基準は、その指標が再度の問い合わせ、責任者による判断変更、利用者の負担増加などを予測できるかである。初期の運用者は、既存の品質手順や苦情分類を、複数ターンの再生試験へ変換する可能性がある。プライバシー保護のため、会話への無制限なアクセスではなく、匿名化した記録と抽出調査が優先される。
2年目には、アシスタントの行動と利用者の反応を記述する、小規模で共通の事象形式が整う可能性がある。人間の判断が強く一致する部分には明確な制限を設け、正当な意見の違いがある部分では追加確認や人間の検討を求める。再生試験の得点が実際の結果と繰り返し一致すれば、大規模な利用組織はシステム提供者に対し、記録へのアクセスと更新通知を求めるようになる。一部の更新は、引き継ぎ判断や訂正後の回復が悪化した場合、公開を止められるようになる。
3年目ごろには、プライバシー処理された監視によって、行動が試験済みの範囲から外れるドリフトを継続的に検出できるようになる。システムは権限を狭め、人間による抽出確認を増やすか、重要な時点で責任者の承認を求める。この仕組みでは、重要な対話の分岐点を管理点とし、記録を証拠に用い、管理の失敗時に是正措置を取る。有力な観測指標は、複数の提供者が同じ再生試験を公開前の判定に使うことである。軌跡指標が実際の結果を予測できない場合や、監督費用が過大になる場合には、この流れは弱まる。社会的判断は物理的な危険より変化しやすいため、人間による確認と定期的な方針改定が引き続き必要になる。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- Coaching Copilot: Blended Form of an LLM-Powered Chatbot and a Human Coach to Effectively Support Self-Reflection for Leadership Growth - 著者: Riku Arakawa, Hiromu Yakura, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Modeling Future Conversation Turns to Teach LLMs to Ask Clarifying Questions - 著者: Michael J. Q. Zhang, W. Bradley Knox, Eunsol Choi, / <See Details on Fugu-MT> / ライセンス: CC-BY-SA-4.0
- Evaluating Alignment of Behavioral Dispositions in LLMs - 著者: Amir Taubenfeld, Zorik Gekhman, Lior Nezry, Omri Feldman, Natalie Harris, Shashir Reddy, Romina Stella, Ariel Goldstein, Marian Croak, Yossi Matias, Amir Feder, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0