サマリー
本テーマは、基盤モデルが科学的・マルチモーダルな用途に向けてどのように評価・改善されているかに焦点を当てており、事前学習戦略、データの現実性、効率的なクロスモーダル設計が重視されている。代表的な論文は、高い性能が汎用的なスケーリングのみに依存するのではなく、ドメインを意識した継続事前学習、より優れたベンチマーク構築、実際のワークフロー制約に適合したアーキテクチャに大きく依存することを主張している。
テーマの状況
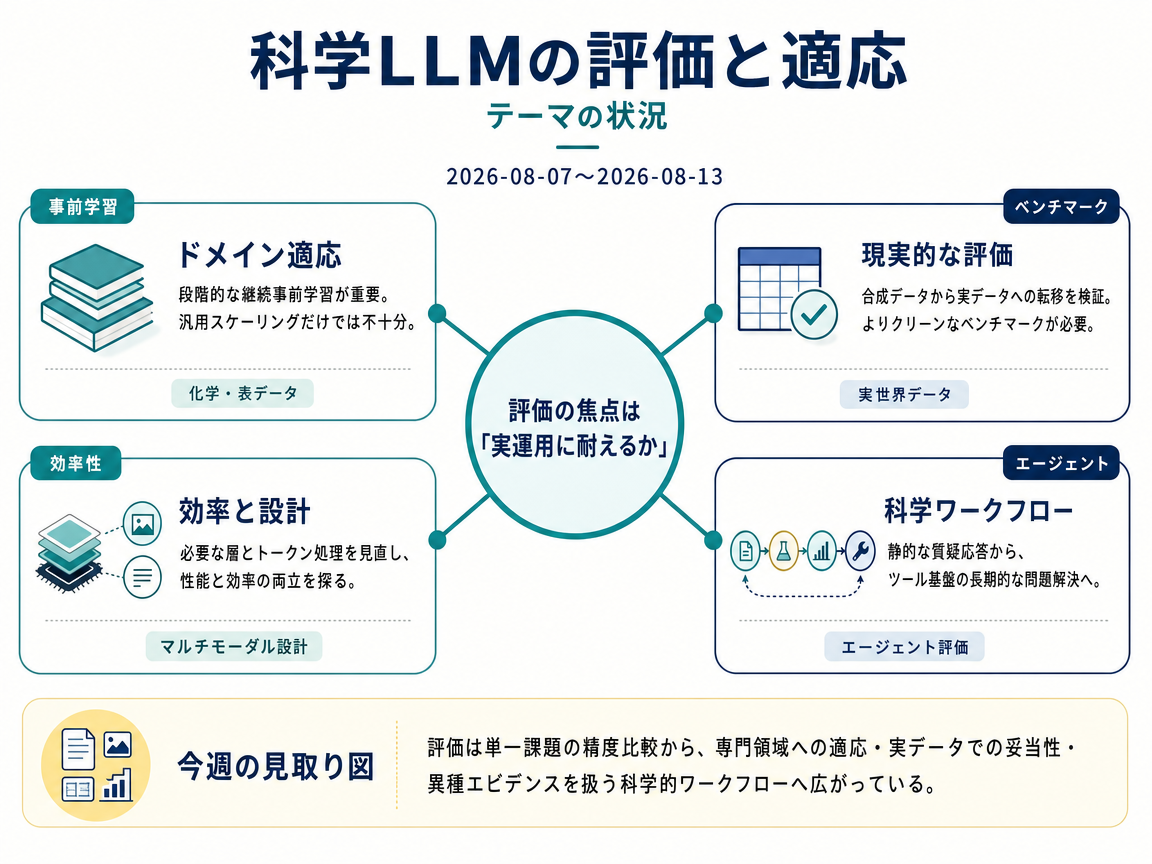
代表的な論文は、基盤モデルが専門的な科学的・マルチモーダルな環境に対して実際に準備ができているかという問いとしてモデル評価を位置づけている。PRESTOは、合成化学において従来の分子-テキストシステムが重要な2Dグラフ構造、マルチグラフ反応コンテキスト、慎重な事前学習設計を見落としがちであることを示し、よりクリーンなベンチマークと段階的なドメイン事前学習の必要性を提起している。Real-TabPFNも同様に、大規模な合成表形式データで学習されたモデルであっても、精選された実世界のテーブルでの継続事前学習から恩恵を受けうることを論じ、広範な事前知識が十分であると仮定するのではなく、合成データから実データへの転移を検証することの重要性を強調している。
第二の共通方向は、見出し的なタスク精度だけでなく、実用的な効率性とワークフロー要件の下でモデルを評価することである。Platonic Grounding for Efficient Multimodal Language Modelsは、マルチモーダルトークン処理にどの層が真に必要かを問い、視覚-言語モデルの効率性と性能のトレードオフを提示している。今週の新たなエビデンスとして、Intern-S2-Preview: Scientific Agentic Foundation Modelは、評価対象を静的な科学的質問応答から、異種エビデンスに対する長期的・ツール基盤の問題解決へと押し進め、LLMが孤立したプロンプトに回答するだけでなく科学的エージェントとして機能できるかを評価する方向へのシフトを強化している。
- PRESTO: Progressive Pretraining Enhances Synthetic Chemistry Outcomes
- Platonic Grounding for Efficient Multimodal Language Models
- Real-TabPFN: Improving Tabular Foundation Models via Continued Pre-training With Real-World Data
- Distilling Physical Priors into Streaming World Models
- Intern-S2-Preview: Scientific Agentic Foundation Model
インフォグラフィクス(日本語)
今週の進展
Intern-S2-Preview: Scientific Agentic Foundation Model <See Details on Fugu-MT>
レンダリングされた科学文書とインターリーブされた画像-テキストデータで学習されたマルチモーダル科学基盤モデルを導入し、理解・推論・生成・長期的エージェントタスクを対象としている。 静的な科学的QAから、マルチタスク強化学習とオンポリシー蒸留を明示的にサポートする持続的でツール基盤の科学的ワークフローへと評価の方向性を転換している。
OmniScientist: An Omni-Modal Omni-Discipline AI Scientist <See Details on Fugu-MT>
アイデア創出・実験・論文執筆を協調するエージェント群を備えたエンドツーエンドのオムニモーダルAI科学者を提示し、5分野・9種類のエビデンスにわたる36の実例で評価している。 単一モダリティや単一ベンチマークのテストから、異種の生データにわたる統合的科学ワークフローへと評価範囲を拡大している。
今後の展望
今後の展望(要約)
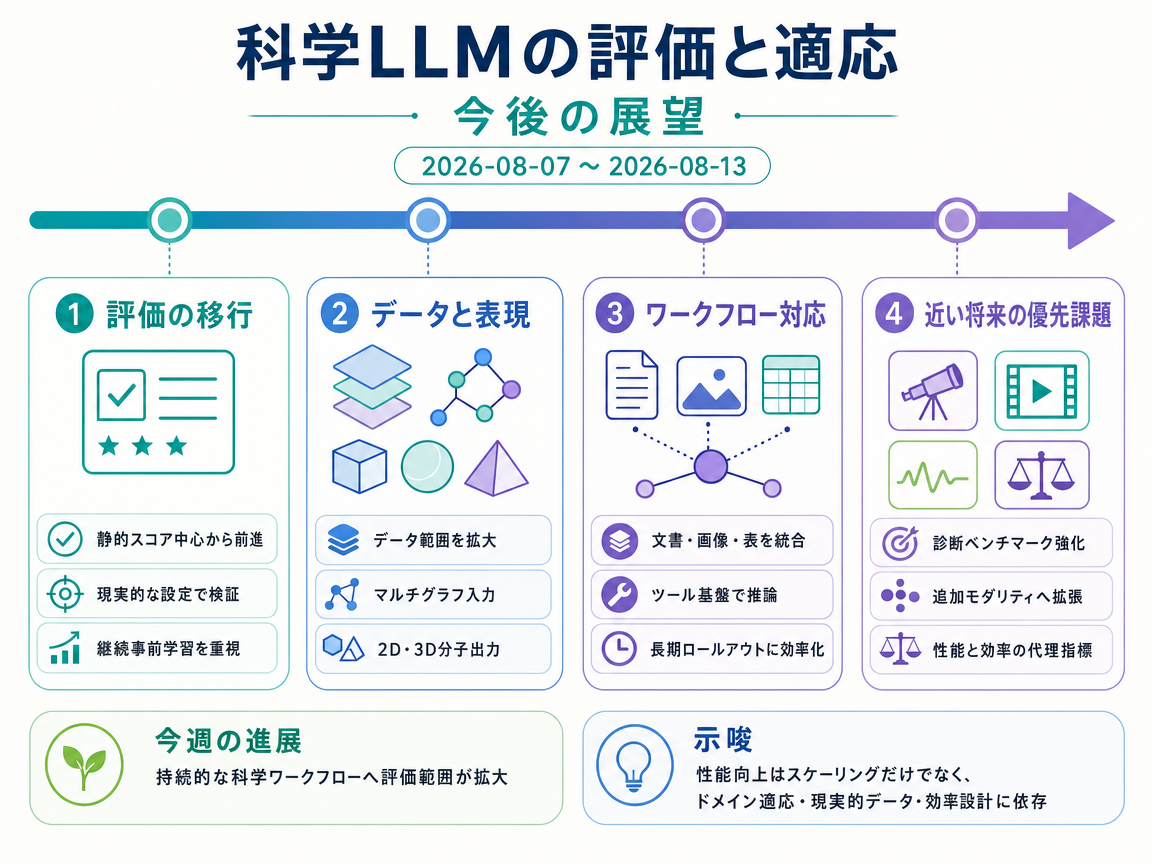
評価の重点は、固定ベンチマークの得点から、選別された専門分野データによる継続事前学習やマルチモーダルな証拠を使う現実的な試験へ移りつつある。当面は、データセットの対象範囲を広げ、科学情報の表現を改善し、データ漏洩や分布変化を検出する研究が進むだろう。モデルには、文書や画像、表を外部ツールと結び付け、長い作業工程でも効率よく推論する能力が必要になる。性能と計算資源の使用量を現実的に両立させる方法も重要になる。
インフォグラフィクス(日本語)
3年後を想定した動き
この見通しでは、汎用的な規模や固定問題の得点より、現実的な科学ワークフローを確実に完了できるかが重視される。モデルは、専門データや科学的構造、マルチモーダルな証拠を使いながら、相互につながる多数の工程を処理しなければならない。その仕組みは、納期どおりに完全な成果物を届けられたかを測る指標に似ており、正しい結果だけでなく、証拠の妥当性と資源使用量も評価対象になる。
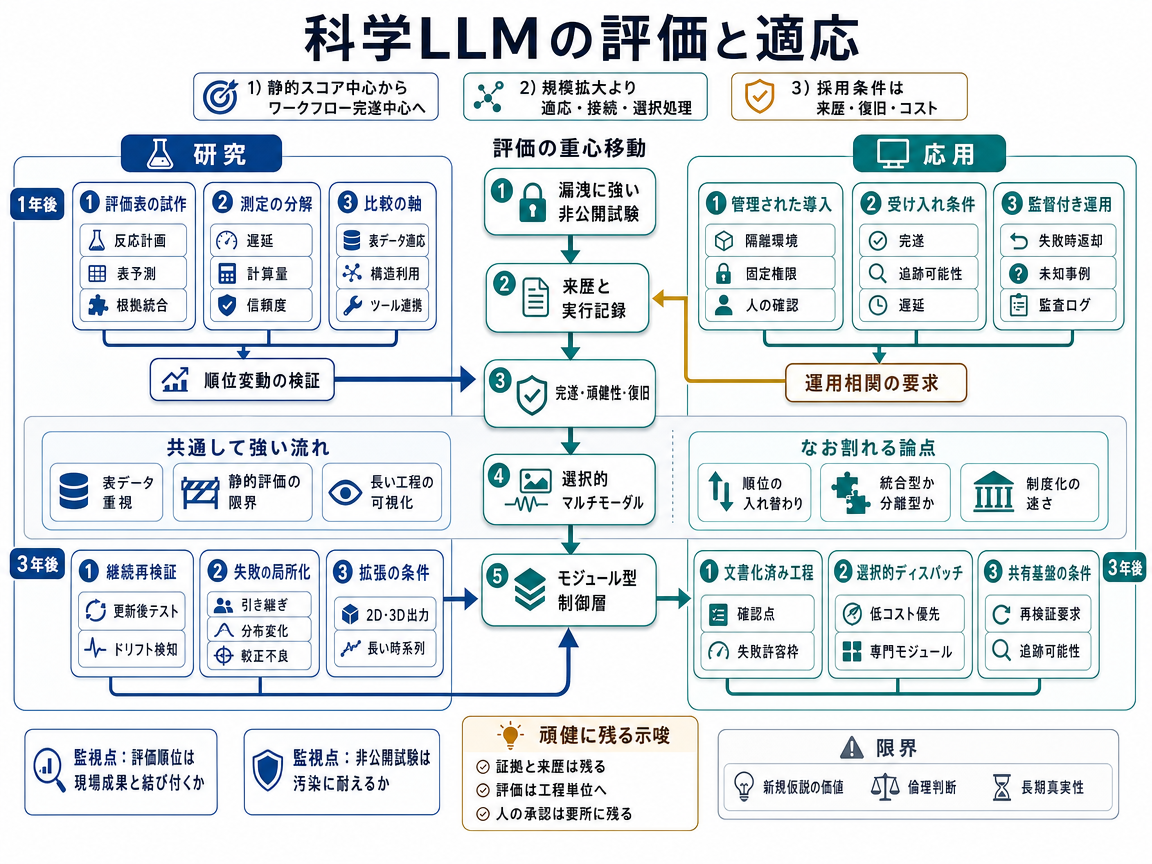
1年目には、反応計画や表形式予測、証拠統合など、範囲を限定したワークフロー向けの評価表が作られるだろう。そこでは、作業の完了率、追跡可能性、ツール呼び出しに失敗した後の回復力を測る。情報源や時期を分けた非公開評価により、データ漏洩と分布変化を見つけやすくなる。選別した実データによる適応と合成データだけの学習を比較し、効率的なマルチモーダル処理が長時間の作業でも有効かを確かめる。重要な転換点は、同じ制約下で、適応済みまたは高効率なシステムが大規模な汎用モデルより多くの有効なワークフローを完了し、順位が繰り返し入れ替わることである。
2年目には、信頼できる結果を受けて、専門分野向けアダプター、明示的な科学表現、安定したツール連携へ開発の重点が移る。共通の評価方法によって、来歴記録や管理されたツール環境、資源使用量の計測が標準化される可能性がある。失敗の記録を調べれば、原因が証拠不足なのか、ツール間の受け渡しなのか、未知のデータ分布なのかを区別しやすくなる。3年目には、モデルやデータセット、外部ツールが変わるたびに試験を再実行する継続的な管理層へと評価が発展し得る。更新された検証に合格したシステムは、明確に限定された作業で利用範囲を広げられる一方、不確実な事例は専門家が引き続き管理する。
重要な監視指標は、完全な来歴情報を備えた順位表と、非公開または時期分離型の試験で一貫した改善が示されることである。異なる組織で結果を再現できない場合や、非公開試験が急速に汚染される場合、あるいは固定得点で優位なモデルが管理されたワークフローでも勝ち続ける場合には、この展開は弱まる。成果物の納入という比喩は、確認可能な作業の安定した完了を評価できるが、自由度の高い科学的着想の新規性や長期的な正しさまでは判定できない。
この見通しでは、汎用モデルを大規模化する開発より、対象を絞った適応、現実的なデータ、効率的なマルチモーダル処理が優先される。長い科学ワークフローでは、モデルが多くの工程にわたって証拠と外部ツールを連携させるため、隠れた計算負荷や誤りの蓄積が見えやすい。仕組みは電力網に似ており、汎用の推論基盤が通常の処理を担い、必要な場合だけ管理機構が専門モジュールを起動する。
1年目には、精度や資源使用量、来歴をワークフロー単位で測る仕組みが作られる。データ漏洩に強い試験により、一般的な推論と、分子解析や構造化予測、画像解釈などの専門作業を分けて評価する。初期のモジュール型システムは、各工程を汎用基盤または適切な専門モジュールへ振り分ける。決定的な基準は「系統同等点」であり、信頼性と追跡可能性を保ちながら、振り分け型システムが同じ作業をより少ない総資源で完了できることを意味する。監督下の試験導入は限定された範囲にとどまり、多くのモジュールは共通の内部表現ではなく、型が定義された入力と構造化された出力を交換する。
同等点に達すれば、2年目の焦点は相互運用性と運用時の信頼性へ移る。ツール出力や信頼度、来歴記録の共通形式が整えば、モジュールを交換しやすくなる。振り分け機構は、定められた品質と応答時間を満たす部品のうち、必要資源が最も少ないものを選ぶ。3年目には、評価の改善が交換可能な専門モジュールへの需要を生み、その需要がより良いデータセットとモジュールの開発を促す循環が形成され得る。管理システムは、文献調査や実験準備、報告書作成を連携させつつ、重要な工程では人間の承認を残すだろう。小型のモジュール型システムは、現場での処理が必要な場合に、制約のある機器上でも動作する可能性がある。
同等点への到達が繰り返し確認され、独立した認証試験が始まることが重要な監視指標になる。統合型マルチモーダルモデルが精度と資源効率、監査可能性のすべてで振り分け型と並ぶ場合、この展開は弱まる。振り分けの負荷で処理が不安定になる場合や、選別した実データの効果が別の条件に広がらない場合も同様である。電力網の比喩には限界があり、モデルの内部表現は電力のようにそのまま交換できないため、複数の接続方式と専用アダプターが残る可能性が高い。
この見通しでは、科学的な信頼性の評価対象が、モデル単体からモデルを含むワークフロー全体へ移る可能性がある。仕組みは研究所の認定制度に似ており、モデルを測定機器、非公開ベンチマークを技能試験、実行ログを証拠の管理記録として扱う。これにより、最終回答だけでなく、証拠の追跡可能性と管理された運用も同じ程度に重要になる。
1年目には、科学的構造を考慮したデータ分割、汚染検査、不確実性の調整が強化される。研究チームは、データの版や中間出力、人間による修正を記録する来歴管理機能を追加する。化学および表形式データのシステムが初期の試験環境となり、効率的なマルチモーダル設計によって画像や構造情報を処理すべき条件が明らかになる。データ漏洩による大規模な再現性問題が起きれば、導入が加速する可能性がある。より強い前向きな兆候は、複数の組織が非公開の技能試験と、機械処理可能なワークフロー記録形式を公開することである。
2年目には、明確な転換点が必要になる。評価の高い学術誌や研究支援組織、科学機関のいずれかが、来歴情報または技能試験の結果を任意の補足資料ではなく、実際の採否条件にしなければならない。そうなれば、評価者は証拠が結論を支えているか、不確実性が適切に調整されているか、部品を交換しても結果が維持されるかを調べる。検証済みの部品は交換しやすくなるため、明確な試験に合格できる専門ツールへの需要が高まり、改善の循環が生まれる。
3年目には、複数の科学分野を対象とする共通技能試験が整備され、暗記を防ぐために定期更新される可能性がある。管理システムは、モデルやデータセット、ツールが変わるたびにワークフローを自動で再検証できるようになる。影響の大きい一部の研究計画では、AIを利用した結果を受け入れる前に、検証済みワークフローの使用が求められるかもしれない。モデルは大きな管理システムの中で交換可能な機器として機能し、各部品は特定の動作条件に対して承認される。
主な監視指標は、ワークフロー記録が論文の採否やシステム導入の意思決定に影響し始めるかどうかである。来歴情報が任意の表示項目にとどまる場合や、組織ごとに互換性のない形式を採用する場合、この展開は弱まる。単一の汎用システムが多様な科学的証拠と長い推論を少ない資源で安定して処理できる場合も、広がりにくくなる。認定制度は確率的に動くモデルの完全な正しさを保証できないが、不確実性の調整、証拠の追跡、既知の失敗範囲を明確にすることはできる。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- PRESTO: Progressive Pretraining Enhances Synthetic Chemistry Outcomes - 著者: He Cao, Yanjun Shao, Zhiyuan Liu, Zijing Liu, Xiangru Tang, Yuan Yao, Yu Li, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Platonic Grounding for Efficient Multimodal Language Models - 著者: Moulik Choraria, Xinbo Wu, Akhil Bhimaraju, Nitesh Sekhar, Yue Wu, Xu Zhang, Prateek Singhal, Lav R. Varshney, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Real-TabPFN: Improving Tabular Foundation Models via Continued Pre-training With Real-World Data - 著者: Anurag Garg, Muhammad Ali, Noah Hollmann, Lennart Purucker, Samuel Müller, Frank Hutter, / <See Details on Fugu-MT> / ライセンス: CC-BY-SA-4.0
- Distilling Physical Priors into Streaming World Models - 著者: Liangliang Zhao, Junying Wang, Danni Yang, Yifan Chang, Bin Fu, Yu Qiao, Bowen Zhou, Yihao Liu / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- Intern-S2-Preview: Scientific Agentic Foundation Model - 著者: Lei Bai, Jiaqi Cao, Chiyu Chen, Guanzhou Chen, Kai Chen, Guangran Cheng, Erfei Cui, Xuanlang Dai, Shengyuan Ding, Shangheng Du, Yanhui Duan, Yue Fan, Youqing Fang, Quan Gan, Yuanyuan Gao, Jiaye Ge, Lixin Gu, Yuzhe Gu, Qipeng Guo, Junjun He, Xin Hong, Ming Hu, Zhouqi Hua, Haian Huang, Junhao Huang, Zixian Huang, Minxi Jin, Lingkai Kong, Alexander Lam, Zehao Li, Zonglin Li, Tianhao Liang, Dahua Lin, Junyao Lin, Tianyang Lin, Zhouhan Lin, Jiangning Liu, Jin Liu, Kuikun Liu, Wenran Liu, Yifei Liu, Yuhong Liu, Yuhong Liu, Zhoumianze Liu, Ziyan Liu, Ziyu Liu, Haijun Lv, Han Lv, Chengqi Lyu, Le Ma, Ningsheng Ma, Zerun Ma, Haoyang Peng, Runyu Peng, Jifei Shan, Zixin Shang, Kou Shi, Xiang Shi, Qisheng Su, Xuerui Su, Hao Sun, Xiao Sun, Yanan Sun, Yu Sun, Huanze Tang, Yinghao Tang, Wenhui Tian, Zhongbo Tian, Bingli Wang, Haomin Wang, Jiarui Wang, Jingzhi Wang, Rui Wang, Xiquan Wang, Yi Wang, Zhecan Wang, Ziyi Wang, Zun Wang, Rubin Wei, Lianyi Wu, Wen Wu, Yue Wu, Yuhan Wu, Zhenyu Wu, Zijian Wu, Shuhao Xing, Jun Xu, Xingle Xu, Xuenan Xu, Xiangchao Yan, Ziang Yan, Bowen Yang, Danni Yang, Lin Yang, Zhiqi Yang, Qian Yao, Haochen Ye, Peng Ye, Jinhui Yin, Jiashuo Yu, Dingbo Yuan, Fei Yuan, Yuhang Zang, Bo Zhang, Chao Zhang, Chen Zhang, Hongjie Zhang, Junming Zhang, Wenlong Zhang, Wenwei Zhang, Yiming Zhang, Zhuo Zhang, Ziyang Zhang, Haiteng Zhao, Penghao Zhao, Yibo Zhao, Zhonghan Zhao, Zhihang Zhong, Bowen Zhou, Peiheng Zhou, Xin Zhou, Xinyu Zhou, Yunhua Zhou, Dongsheng Zhu, Yicheng Zou / <See Details on Fugu-MT> / ライセンス: CC BY 4.0