サマリー
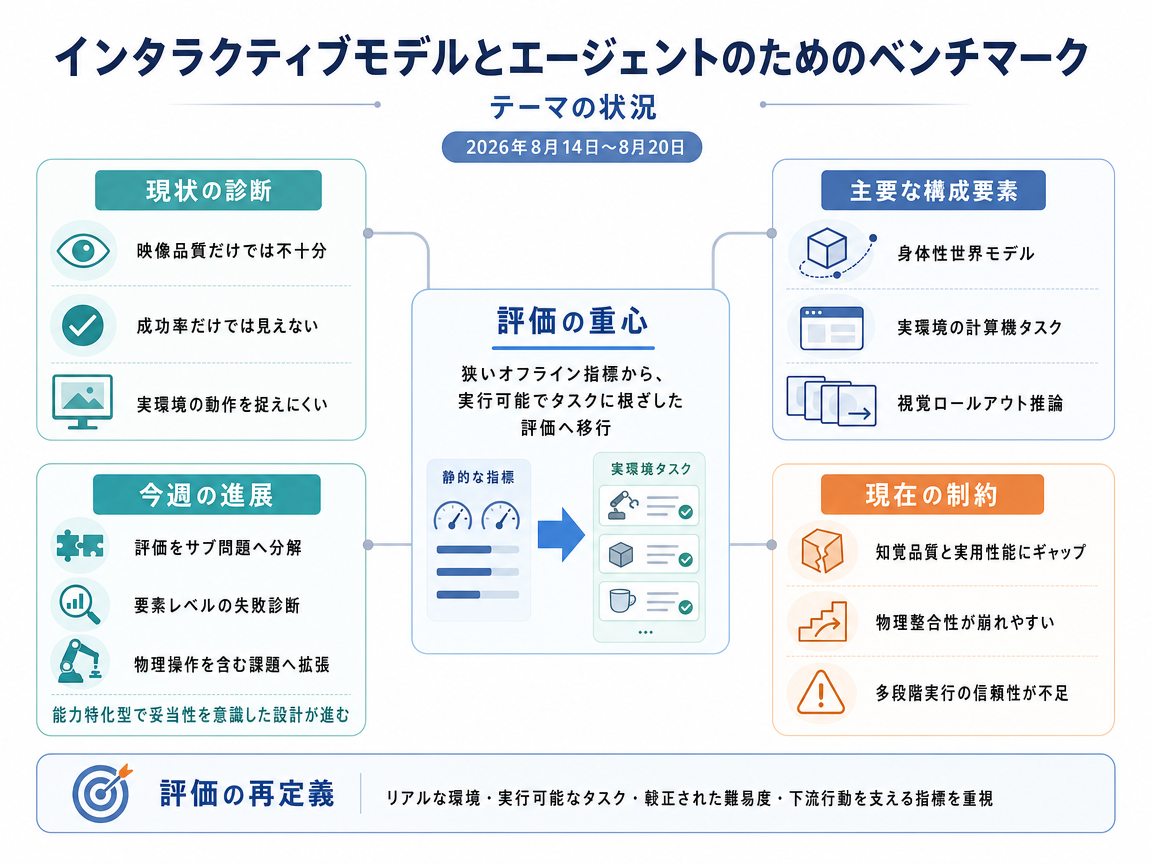
今週のテーマは、モデル評価を狭いオフライン指標から、身体性世界モデルやマルチモーダルGUIエージェント向けの実行可能でタスクに根ざしたベンチマークへと移行させることに焦点を当てている。代表的な論文は、現行の評価が機能的有用性、効率性、クロスアプリケーション動作を捉えきれていないと主張し、知覚品質と信頼性の高いタスク遂行能力との間のギャップを一貫して明らかにしている。
テーマの状況
代表的なベンチマーク論文は共通の診断に収束している。すなわち、現行の評価プロトコルは現在構築されているシステムに対して狭すぎるという点である。WorldArenaは、身体性世界モデルは映像品質だけでは評価できないと主張している。実用的な利用は行動整合的なダイナミクス、方策評価、計画支援、合成データの有用性に依存するためであり、14モデルの評価では視覚的忠実度と身体性タスク性能の間のギャップが明確に示されている。並行して、OSWorldは実際のコンピュータ環境における実行ベースのテストの必要性を提起し、静的なデモンストレーションデータセットや限定的なドメインではオープンエンドなマルチアプリケーションワークフローを捉えられないと指摘している。一方、MMBench-GUIは、単純な成功率だけでなく、階層的な能力カバレッジ、マルチプラットフォームのリアリズム、効率性の重要性を強調し、この批判を拡張している。
今週のエビデンスは、能力特化型かつ妥当性を意識した評価へのこのシフトを裏付けている。VGI-BENCH(2608.19583v1)は、ベンチマークは最終出力や抽象的入力タスクだけでなく、プロセスに敏感な視覚的ロールアウト推論をテストすべきだと主張し、強力なモデルでさえ物理的崩壊、ルール違反、物体・状態の不整合といった重大な失敗を示すことを報告している。テーマ全体を通じて、この分野はリアルな環境、実行可能なタスク、較正された難易度、モデルが下流の行動や推論を支援できるかどうかをより適切に反映する指標を中心に評価を再定義している。
- OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Real Computer Environments
- MMBench-GUI: Hierarchical Multi-Platform Evaluation Framework for GUI Agents
- WorldArena: A Unified Benchmark for Evaluating Perception and Functional Utility of Embodied World Models
- VGI-BENCH: Probing Visual Intelligence in Video Generation Models
インフォグラフィクス(日本語)
今週の進展
HarnessEval-W: Agentifying the Evaluation of Visual Worlds <See Details on Fugu-MT>
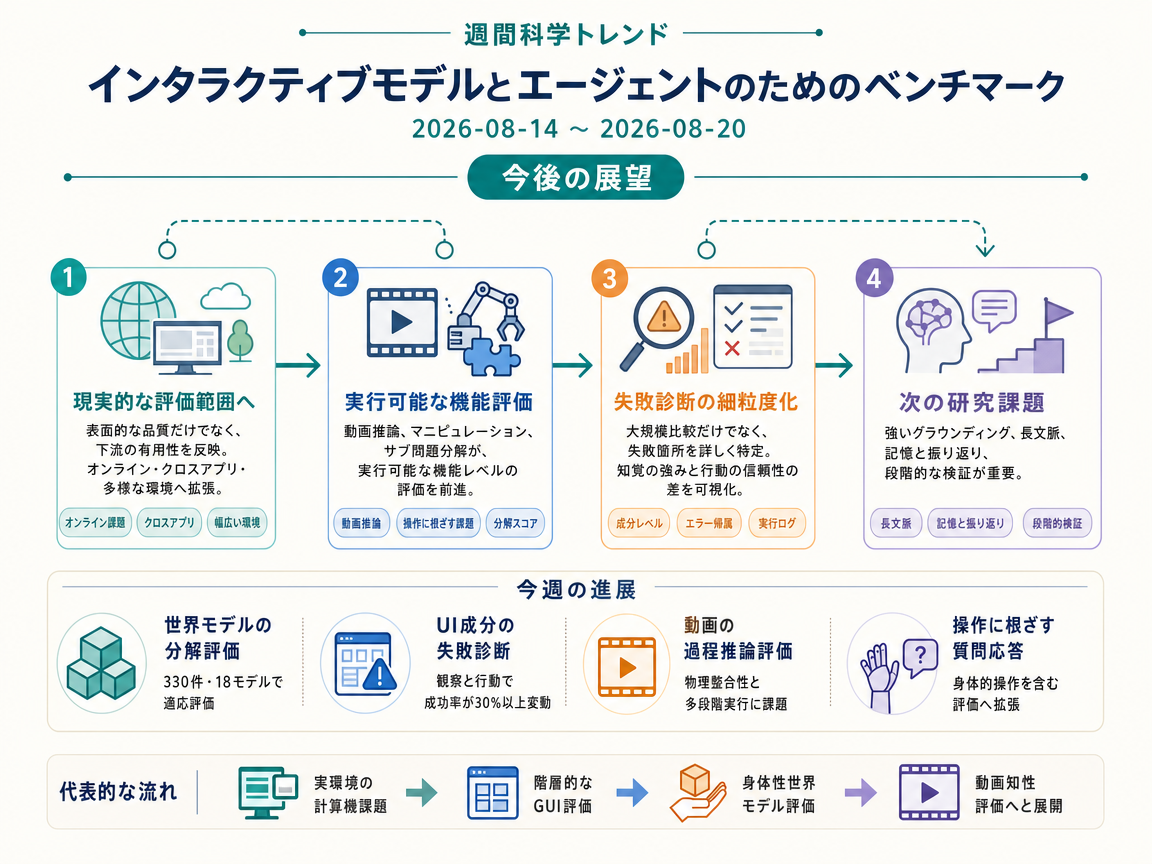
HarnessEval-Wは、世界モデル向けのエージェント型評価パイプラインを導入し、ベンチマーク問題を測定可能なサブ問題に分解する。 固定的なルーブリックを適用する代わりに、330ケース・18モデルにわたる適応的かつきめ細かい評価を可能にする。
ComponentBench: Diagnosing Component-Level Failures in Computer-Use Agents <See Details on Fugu-MT>
ComponentBenchは、最新のウェブインターフェース上の個々のUIコンポーネントレベルでコンピュータ操作エージェントの失敗を診断する。 同一モデルでも観察空間と行動空間を変えるだけでタスク成功率が30%以上変動することを示し、集約指標では見落とされる評価の感度を明らかにしている。
VGI-BENCH: Probing Visual Intelligence in Video Generation Models <See Details on Fugu-MT>
VGI-BENCHは、フォトリアリスティックな入力を用いたプロセス依存型推論タスクを通じて、動画生成モデルの視覚的知性を検証する。 現行モデルはグラウンデッド推論タスクを部分的に解けるが依然として信頼性に欠け、物理的整合性や多段階実行における共通の失敗があることを明らかにしている。
PROBE: Manipulation-Grounded Visual Question Answering with VLM Agents <See Details on Fugu-MT>
PROBEは、物理的インタラクションを必要とするマニピュレーションに根ざした視覚質問応答へとVLMエージェント評価を拡張する。 静的または2Dのみの評価と比較して、身体的マニピュレーションに結びついたタスクのベンチマークおよびファインチューニングのためのフレームワークを提供する。
今後の展望
今後の展望(要約)
評価の重点は、出力が説得力を持つかだけでなく、AIシステムが実際に役立つかを測る、より幅広く現実的な課題へ移りつつある。新しいベンチマークでは、実行可能な一連の処理や画面とのやり取りに加え、重要な部分課題を達成できるかが試される。診断能力も高まっており、各手順の検査と詳しい実行記録を使えば、現実との対応付け、推論、行動のどこで失敗したかを区別できる。その結果、研究者は総合順位だけに頼らず、改善すべき箇所を具体的に特定できる。
インフォグラフィクス(日本語)
3年後を想定した動き
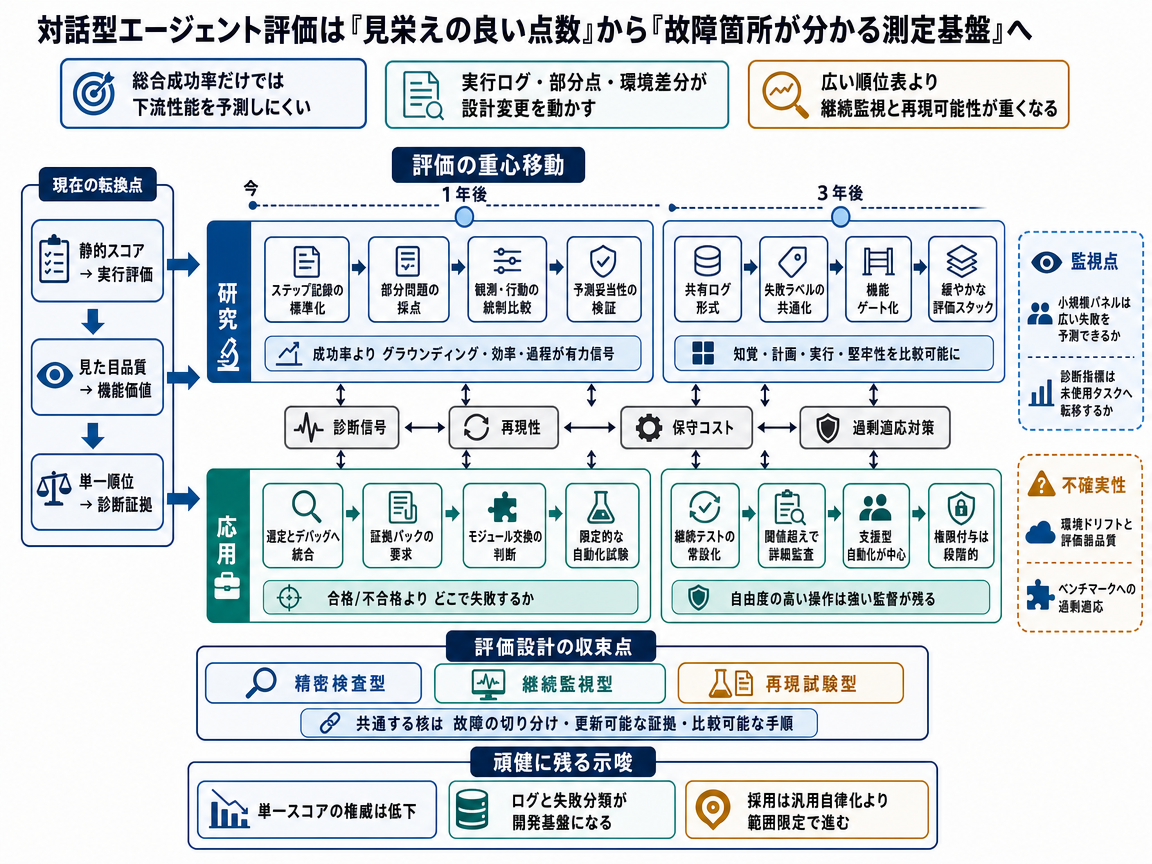
中心的な動きは、静的な得点から、対話型システムの失敗原因を特定できる実行型評価への移行である。その仕組みは診察に似ており、総合的な成功率で問題を見つけ、個別検査で現実との対応付け、計画、実行のどこに原因があるかを確かめる。1年目には、研究者が手順ごとの記録、構成要素別の評価表、条件をそろえた画面比較を導入する。生成された環境についても、見た目の現実らしさだけでなく、計画や学習に本当に役立つかを機能試験で調べる。
2年目には、こうした診断結果が未使用の課題での成績を予測できる場合に、その価値が認められる。共通の記録形式と失敗分類が、コンピューター操作や実世界で行動するシステムの試験環境に広がる。各チームは、ある改善が別の環境にも移せるのか、それとも特定の手順だけを利用しているのかを検証できる。再利用可能な環境と診断用画面も日常的な開発に組み込まれ、システム全体を捨てずに弱い部品だけを交換しやすくなる。
3年目には、診断の向上によって、長期的な状態保持、失敗からの回復、意図しない影響に関する難しい弱点が明らかになる。36カ月ごろには、認識から行動までの主要段階を扱い、頑健性と効率も記録する、緩やかに統一された報告方式が現れる可能性が高い。この方式は単一の有力ベンチマークに依存せず、異なる設計や範囲を限定した自動化試験の証拠を比較可能にする点に価値がある。注目すべき兆候は、独立したチームが実行環境を再利用し、階層的な得点を公開し、診断に基づく設計変更を記録するようになることである。自由度の高い難問では人間並みの信頼性に届かない可能性が高いため、実利用では人が監督し、元に戻せる仕組みが必要になる。構成要素の得点が未使用課題での有用性を予測できない場合や、維持費のため静的な実演へ逆戻りする場合、この動きは弱まる。
対抗シナリオも現実的で診断力のある評価へ進むが、主な推進要因は資源の不足である。完全な実行型試験には、保守された環境、詳細な記録、多くの確認作業が必要であり、モデルを更新するたびに行うには費用が高すぎる可能性がある。1年目には、重要な性能低下を見つけるために選んだ小規模な「監視用パネル」を各チームが作る。このパネルは幅広い能力を個別の検査に分け、環境の版や操作方法などの試験条件を記録する。
1年目の重要な基準は予測妥当性であり、小規模なパネルが大規模評価や現実的な作業での失敗を正しく予測できなければならない。予測に成功すれば、自動評価器は失敗例に応じて詳しい検査を選び、高価な課題をすべて再実行せずに済む。2年目には、継続的に保守される評価システムが、失敗を関連する検査へ自動的に振り分け始める。共通基盤の提供者が仮想マシンや端末群、ブラウザー用の隔離環境を再利用可能な形で用意すれば、組織をまたぐ継続試験も行いやすくなる。
3年目には、範囲を限定した自動化試験で起きた事故や未遂事例を使って、監視用パネルを更新する。これにより、失敗から良い記録が生まれ、その記録が弱い構成要素を示し、新しい検査がシステム変更を導く循環ができる。36カ月ごろには、管理団体が定期的に入れ替える公開事例、非公開の検証課題、明確な対応手順を維持する可能性がある。総合ランキングは残るものの、価値の高い証拠は、失敗箇所と評価範囲の更新時期を説明できる試験基盤から得られるようになる。注目すべき兆候は、評価範囲の表示、評価費用の報告、基準値を超えた場合の監査が広がることである。ただし、開発者が公開された監視事例だけにシステムを適応させる恐れがあるため、事例の入れ替えと独立した保守が欠かせない。小規模パネルが広い範囲の性能を予測できない場合や、完全な実行型評価が十分に安価で安定した場合、この道筋は弱まる。
条件付きシナリオでは、ベンチマークの信頼性を測定の妥当性に関する問題として扱う。観測データの形式、操作方法、環境の版が変わると、同じシステムを試していても結果が動くことがある。1年目には、複数の研究グループが固定したシステムを同じ評価環境の異なる版で試す比較実験を行う。得点の変動や順位の逆転を測りながら、再実行用の道具と版管理を追加する。有力システムの順位が大きく逆転すれば、補正のない生の得点を正当化しにくくなる転換点になり得る。
2年目には、主要ベンチマークが、基準システム、想定得点範囲、必須の実行記録を備えた認証済み設定を公開する可能性がある。基準システムは、その通常の動作と比較することで試験環境のずれを発見できるため、校正器具のような役割を果たす。評価は構成要素にも重点を置き、弱い部分を特定して交換後に再試験できるようになる。生成された環境も、計画やデータ生成に使えると認められるには、機能面の証拠が必要になる。信頼できる得点への需要が校正基盤を支え、再現費用の低下が管理された試験手順の普及を促すという循環が生まれる。
3年目には、変化し続けるソフトウェアと固定試験を攻略するシステムによって、この仕組みに圧力がかかる。36カ月ごろには、信頼できる認証のために、入れ替え式の基準、非公開の課題、継続的なずれの監視が必要になる。保守が迅速かつ透明なら、再現可能な評価は主要な対話型環境における継続検証の一部になり得る。探索的なランキングは残るが、重要な能力の主張には、再現された機能面と効率面の証拠がより強く求められる。注目すべき兆候は、独立した比較実験、固定された試験手順の版、不確実性の定期報告が現れることである。ただし、固定した基準は古くなったり、直接攻略されたりする恐れがある。環境設定による差が小さい場合や、補正後の得点が実用性を予測できない場合、または研究発表の場が再現結果を重視しない場合、この道筋は弱まる。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Real Computer Environments - 著者: Tianbao Xie, Danyang Zhang, Jixuan Chen, Xiaochuan Li, Siheng Zhao, Ruisheng Cao, Toh Jing Hua, Zhoujun Cheng, Dongchan Shin, Fangyu Lei, Yitao Liu, Yiheng Xu, Shuyan Zhou, Silvio Savarese, Caiming Xiong, Victor Zhong, Tao Yu, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- MMBench-GUI: Hierarchical Multi-Platform Evaluation Framework for GUI Agents - 著者: Xuehui Wang, Zhenyu Wu, JingJing Xie, Zichen Ding, Bowen Yang, Zehao Li, Zhaoyang Liu, Qingyun Li, Xuan Dong, Zhe Chen, Weiyun Wang, Xiangyu Zhao, Jixuan Chen, Haodong Duan, Tianbao Xie, Chenyu Yang, Shiqian Su, Yue Yu, Yuan Huang, Yiqian Liu, Xiao Zhang, Yanting Zhang, Xiangyu Yue, Weijie Su, Xizhou Zhu, Wei Shen, Jifeng Dai, Wenhai Wang, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- WorldArena: A Unified Benchmark for Evaluating Perception and Functional Utility of Embodied World Models - 著者: Yu Shang, Zhuohang Li, Yiding Ma, Weikang Su, Xin Jin, Ziyou Wang, Xin Zhang, Yinzhou Tang, Chen Gao, Wei Wu, Xihui Liu, Dhruv Shah, Zhaoxiang Zhang, Zhibo Chen, Jun Zhu, Yonghong Tian, Tat-Seng Chua, Wenwu Zhu, Yong Li, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- VGI-BENCH: Probing Visual Intelligence in Video Generation Models - 著者: Xuan He, Cong Wei, Yuhao Cheng, Linrui Ma, Yuxuan Zhang, Zuojun Li, Yuhao Wen, Zeyi Liu, Yuren Hao, Songcheng Cai, Keming Wu, Penghui Du, Kai Zou, Rui Yang, Chenkai Sun, Ke Yang, Ping Nie, Kelsey R Allen, Chenglong Wang, Michel Galley, Jianfeng Gao, ChengXiang Zhai / <See Details on Fugu-MT> / ライセンス: CC BY 4.0