サマリー
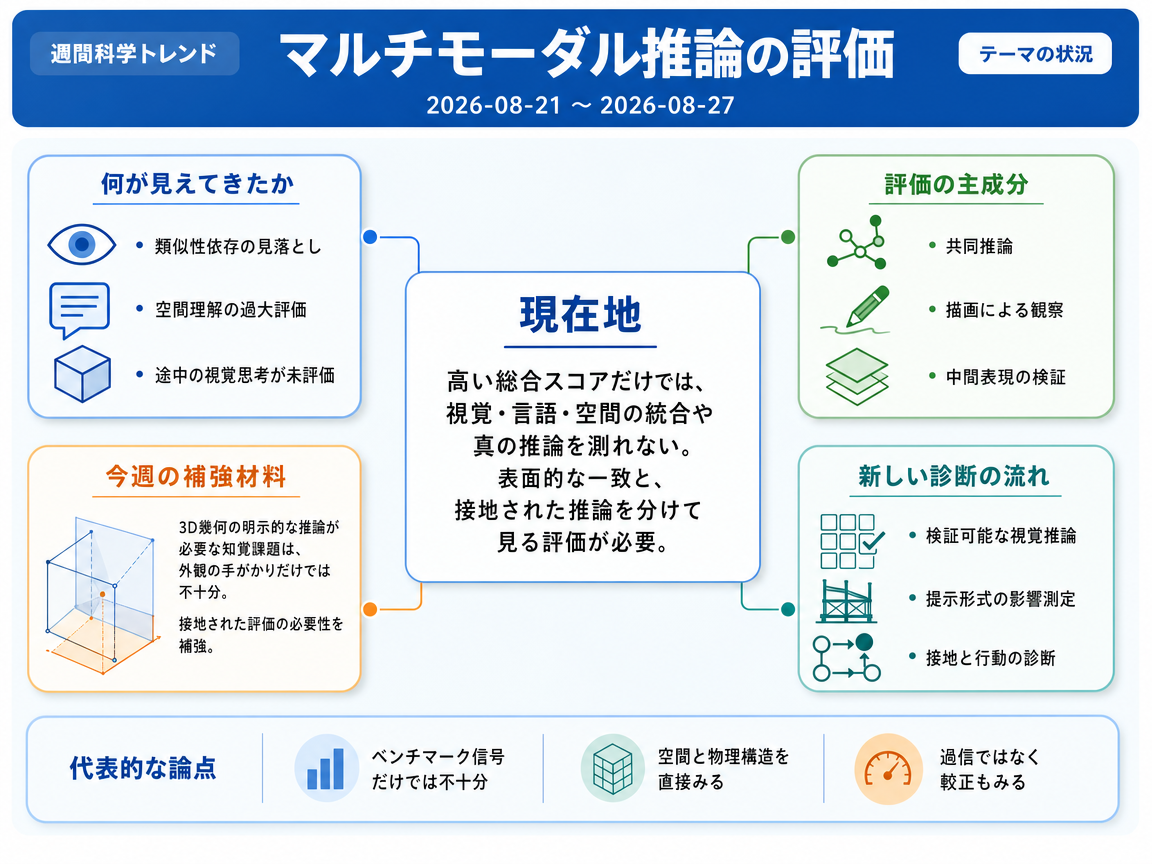
本テーマは、言語モデルやマルチモーダルシステムが視覚・言語・空間の各表現にまたがる真の推論を行えているか、それとも表面的なベンチマーク信号に依存しているかを評価することに焦点を当てている。代表的な論文群は、視覚言語マルチタスクスイートや描画ベースの空間テスト、モデルが中間的な視覚的思考を生成する設定など、より厳格で解釈可能な評価の必要性を主張している。
テーマの状況
現行の評価は、高い総合スコアがテキストと視覚構造の実際の統合能力や空間推論能力を反映していないため、能力を過大評価することが多い。VL-GLUEはこれを真の視覚言語推論におけるギャップとして捉え、多くのシステムが画像+テキスト証拠に基づく共同推論ではなく画像・テキスト間の類似性に過度に依存していると指摘している。LTD-Benchは空間理解について同様の課題を提起し、言語モデルが言語と物理構造を対応付けられるかをより直接的に観察可能なテストとして描画を提案している。同時に「Thinking with Generated Images」は、テキストのみの思考連鎖は問題解決の一部しか捉えておらず、推論中に中間的な視覚的思考を生成・利用するモデルの評価も必要だと論じている。
今週の証拠も同じ方向を示している。「Glass Surface Detection Grounded in 3D Visual Geometry」(2608.26752v1)は、2D外観ベースの手がかりでは困難な知覚問題に不十分であり、3D幾何に対する明示的な推論が必要だと主張している。これ自体はLLMベンチマーク論文ではないが、根底にある評価上の要請、すなわちシステムには表面的なパターン利用と真に接地されたマルチモーダル・空間推論を区別するテストが必要であるという点を補強している。
- VL-GLUE: A Suite of Fundamental yet Challenging Visuo-Linguistic Reasoning Tasks
- Thinking with Generated Images
- LTD-Bench: Evaluating Large Language Models by Letting Them Draw
- Glass Surface Detection Grounded in 3D Visual Geometry
インフォグラフィクス(日本語)
今週の進展
VBVR-Pro: A Scalable and Verifiable Suite for Native Visual Reasoning <See Details on Fugu-MT>
VBVR-Proは、300の手続き的に生成されたタスク空間を持つ、ネイティブな視覚推論のためのスケーラブルかつ検証可能なテストベッドを提供する。 従来の広範なベンチマークとは異なり、推論生成を制御可能にし、VLM-as-a-judgeの繰り返し現れる失敗モードを明らかにする。
Is Visual Prompting All You Need? Studying VLM Spatial Reasoning under Progressive Visual Scaffolds <See Details on Fugu-MT>
本研究は、軽量な視覚的足場がVLMの空間推論性能と失敗モードの測定結果を大きく変え得ることを示した。 ベンチマークの提示形式自体が、テストが基本的な知覚を測定しているのか、下流の推論を測定しているのか、あるいはその混合を測定しているのかを左右し得ることを実証している。
When Seeing Is Not Enough: Benchmarking Interactive Visual Grounding in LVLMs <See Details on Fugu-MT>
本研究は、複数の視覚コンテキストとインタラクションプロトコルにまたがるLVLMのインタラクティブな視覚的接地に対する制御された評価を導入した。 単なる精度の不足を超え、人間のベースラインとの大きなギャップや過信されたキャリブレーションを明らかにしている。
CARD: Diagnosing Belief to Action Routing Failures in Vision Language Models <See Details on Fugu-MT>
CARDは、VLMにおける心的状態の表現が実際に下流の行動予測に経路付けられているかを診断する。 結果のみを評価するベンチマークと比較して、一つの信念軸を操作し軸間の応答を測定することで因果的な診断を追加している。
今後の展望
今後の展望(要約)
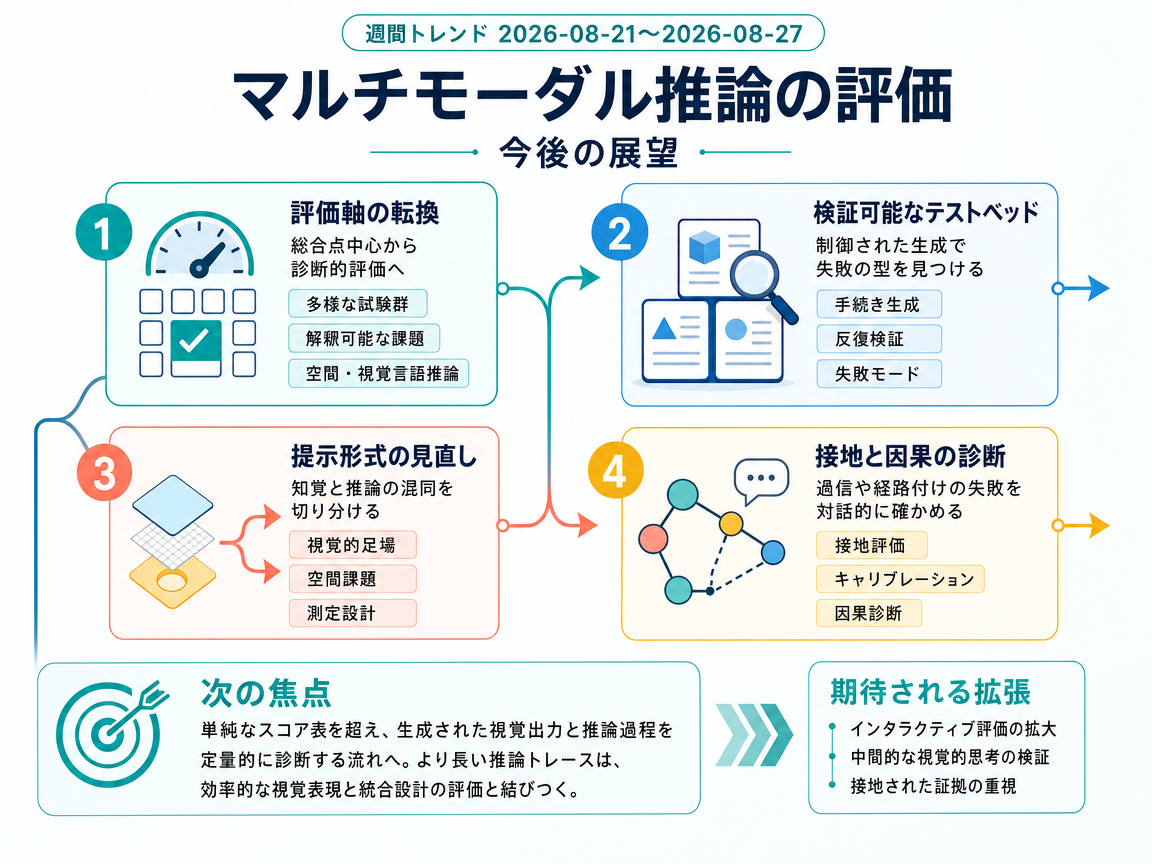
マルチモーダル評価は、総合点を競う方式から、視覚情報との対応付け、空間推論、中間的な視覚状態を使う推論を個別に診断する方式へ移る可能性が高い。より大規模で多様な、自動検証可能なベンチマークにより、知覚の失敗と推論の失敗を区別し、課題の形式が結果をゆがめる場合も見つけやすくなる。評価方法は、複数の情報形式を統一的に扱うモデルの設計とも密接に結び付くだろう。効率的な視覚表現や長い推論過程の進歩は、正解率だけでなく、確認可能な証拠、確信度の適切さ、根拠に基づく推論が崩れる箇所の分析によっても判断されるようになる。
インフォグラフィクス(日本語)
3年後を想定した動き
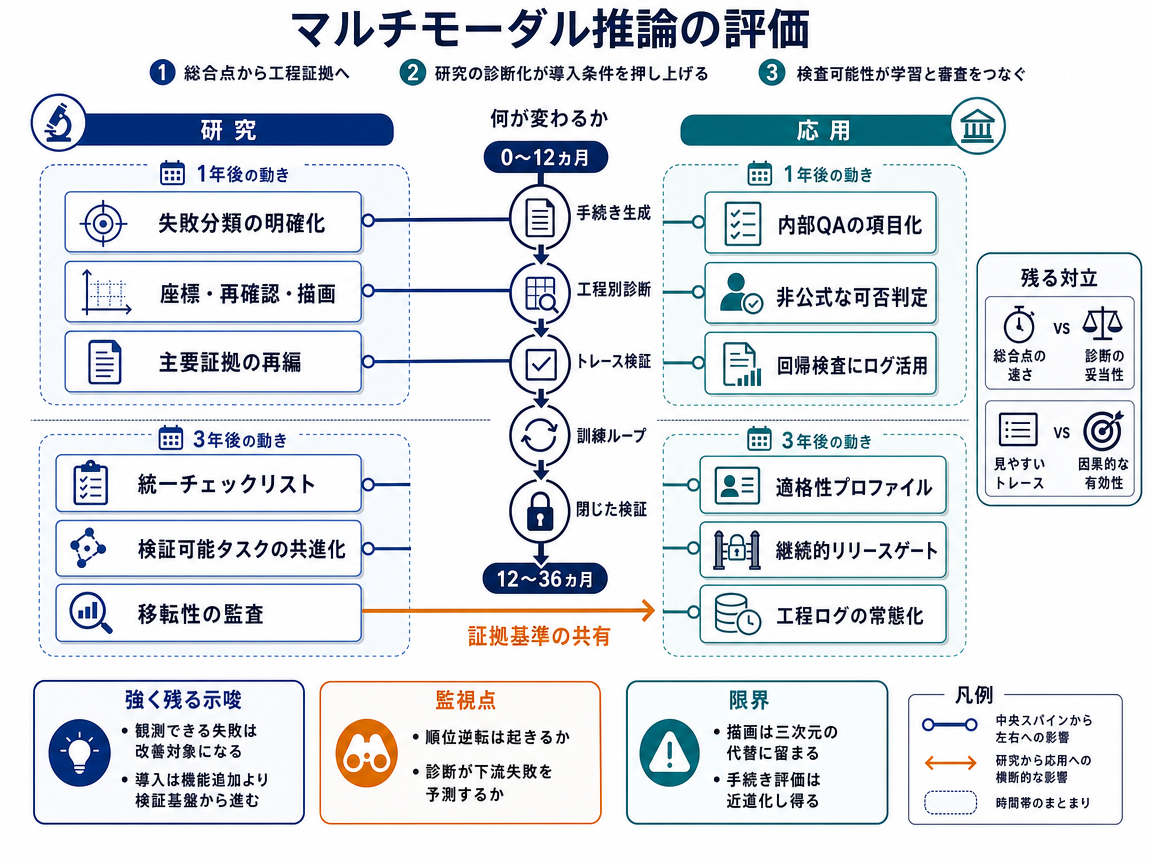
この変化は、平均点だけを示すのではなく、マルチモーダル推論がどこで失敗するかを明らかにする評価から始まる。既存のベンチマークは、画像と文章を組み合わせた推論、空間関係の把握、視覚的な抽象化の弱点を示してきた。今週取り上げた手続き的に生成される課題と対話型の検査は、こうした弱点を観察し、検証しやすくする。重要な仕組みは観測可能性であり、隠れていた失敗を特定の段階で測れれば、研究者はそれを学習に反映し、開発チームは公開可否の判断に利用できる。
1年目には、手続き的な生成と、図による補助や操作経路を調べる検査が組み合わされる。モデル報告では、知覚の誤り、課題形式の影響、推論の誤りを分けて示すようになるだろう。ロボット、画面操作エージェント、文書処理ツールの開発チームも、内部比較にこれらの診断を加える。平均正解率が高くても、誤った領域を繰り返し選んだり、不正確な視覚認識に基づいて動いたりするモデルは、利用範囲を制限される可能性がある。これにより、測定された失敗が学習の優先順位と適格性の基準を変えるフィードバックループが生まれる。
2年目には、個別の検査が、静的な内容、対話型環境、短い動画を対象とする広い確認体系へ統合されると考えられる。統一型マルチモーダルモデルは、スケッチや選択領域を中間的な視覚状態として示し、評価ツールはその状態が安定し、実際に役立つかを調べるだろう。重要な観測指標は、視覚的補助を外す比較実験、参照領域の記録、根拠に基づく公開判断が日常的に行われることである。
3年目までには、生成した難題でモデルを改善し、その改善が新しい状況にも移るかを監査する、閉じた検証ループが形成される可能性がある。最終正解率が同程度のモデルでも、確信度の適切さ、位置の特定能力、証拠に沿った行動によって区別されるようになる。この進路は、生成課題がすぐ解き尽くされる場合、診断上の改善が別の課題へ移らない場合、総合点への依存が続く場合には弱まる。
このシナリオでは、診断型のマルチモーダル評価が、ソフトウェア工学の性質ベーステストに近い仕組みへ発展する。研究者は、ある物体が別の物体より上にあり続けるといった、変化してはならない関係を定義する。そのうえで、その関係を保つ多数の有効な課題を自動生成し、固定された一つのベンチマークではなく、生成された変形全体でモデル更新を検査する。中心となる仕組みは適合性の反復検査だが、出力が一定せず、完全な正解が一つに定まらない課題もあるため、マルチモーダルモデルの仕様化は難しい。
1年目には、研究グループが、宣言した性質を保ちながら、表示方法、視点、視覚情報へのアクセスを変える実行可能なライブラリを構築する。検査では最終回答に加えて、座標や領域の再参照記録など、視覚情報との対応を示す証拠も確認する。チームは、モデル、指示文、ツール設定を変更するたびに検査を再実行するだろう。この方法が総合点では見逃された重要な性能低下を発見し、公開判断を直接変えた時点で、実運用への移行条件が満たされる。
2年目には、成功例を受けて、視覚的な性質、操作状態、テスト範囲を共通形式で記述する動きが進む。独立した研究グループは、同じ検査が異なるモデルや環境でも失敗を予測できるかを調べる。限定された作業では版管理された適格性プロファイルが導入され、非公開の生成器によって既知の事例だけに最適化する危険が抑えられるだろう。重要な観測指標は、通常のベンチマーク順位と、保つべき性質に基づく順位が逆転し、その結果が再現されることである。
3年目までには、実際の運用で見つかった失敗が生成規則へ変換され、似ているが同一ではない事例を作るようになる。これらの事例は、性能低下を見つける範囲を広げ、視覚情報との対応付けや必要箇所の再確認を改善する。継続的な保証サービスが更新後のシステムを事前に検査し、モデルは万能な推論器ではなく、明示された利用条件ごとに認定される可能性がある。この進路は、生成された変形に誤解を招く特徴が含まれる場合、モデル順位が変わらない場合、共通仕様が複数の研究グループに支持されない場合には弱まる。
このシナリオの出発点は、高い総合点が、空間推論、視覚的な抽象化、画像と文章を結び付ける推論の弱さを隠し得るという懸念である。手続き的に生成される課題は答えを検証しやすくし、視覚的補助の実験は表示形式が測定結果を変えることを示す一方、対話型の因果検査はモデルの視覚認識が本当に行動を導くかを問う。提案される仕組みは継続的なストレステストであり、過去の一つの点数を信頼する代わりに、課題条件を繰り返し変えて、根拠に沿った振る舞いを調べる。
1年目には、研究者が指示文、描画方法、画像領域へのアクセスを制御して変え、システムを再評価する。図や操作履歴を使えば、流ちょうな説明を推論の証明とみなさずに、失敗を詳しく確認できる。生成された中間画像は特に厳しく調べられ、見た目に説得力があっても、本当の空間能力を反映しているとは限らないことが検証される。画面操作エージェント、技術図面、ロボットを扱う開発チームは、こうした履歴を内部の品質確認に加える可能性がある。複数の評価機関が、証拠となる履歴の欠落や信頼性不足を不適格と判断すれば、このシナリオの移行条件が満たされる。
2年目には、視覚的補助の検査、新しい生成課題、対話型の対応付け検査をまとめた小規模な評価パッケージが定着する可能性がある。学習と評価は、繰り返し生成される課題群を共用し、要求される証拠とモデル改善の間にフィードバックループを作る。開発者は視覚情報との対応付けと必要箇所の再確認を改善し、評価者は生成器を更新して、中間履歴が実際の行動に影響するかを調べる。重要な観測指標は、表示方法を変えたときにモデル順位が一貫して変動し、因果検査でも行動経路の弱点が見つかることである。
3年目までには、影響の大きい視覚作業への適格性を判断する際、行動に基づく証拠がより重視される可能性がある。研究報告や公開前の確認では、正解率に加えて、履歴の忠実さと確信度の適切さが比較されるだろう。標準化され、後から再確認できる証拠を示すシステムは、より検証しやすい区分を形成し、不透明なシステムは影響の小さい補助用途に限定される。このシナリオは、履歴の提示が任意のままで、課題の成功率が中心指標であり続ける可能性があるため、標準シナリオより実現性が低い。視覚的補助の効果が消える場合、生成課題が短期間で解き尽くされる場合、因果診断が実際の失敗を予測できない場合には、さらに支持を失う。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- VL-GLUE: A Suite of Fundamental yet Challenging Visuo-Linguistic Reasoning Tasks - 著者: Shailaja Keyur Sampat, Mutsumi Nakamura, Shankar Kailas, Kartik Aggarwal, Mandy Zhou, Yezhou Yang, Chitta Baral, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Thinking with Generated Images - 著者: Ethan Chern, Zhulin Hu, Steffi Chern, Siqi Kou, Jiadi Su, Yan Ma, Zhijie Deng, Pengfei Liu, / <See Details on Fugu-MT> / ライセンス: CC-BY-SA-4.0
- LTD-Bench: Evaluating Large Language Models by Letting Them Draw - 著者: Liuhao Lin, Ke Li, Zihan Xu, Yuchen Shi, Yulei Qin, Yan Zhang, Xing Sun, Rongrong Ji, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Glass Surface Detection Grounded in 3D Visual Geometry - 著者: Yiwei Lu, Ke Xu, Tao Yan, Xiaojun Chang, Radu Timofte, Rynson W. H. Lau / <See Details on Fugu-MT> / ライセンス: CC BY 4.0