サマリー
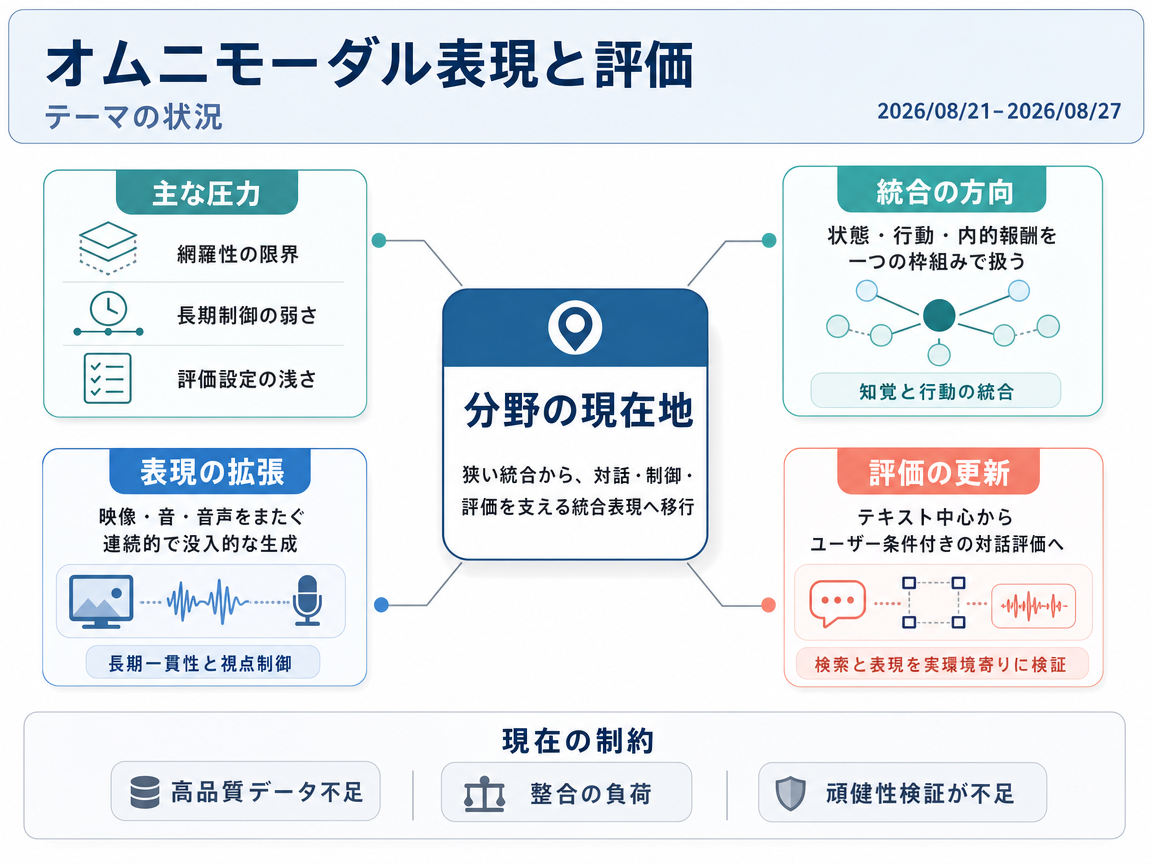
本テーマは、複数のモダリティを統合しつつ、その表現の制御性と評価の実質性を高めるモデルに焦点を当てている。代表的な論文は、モダリティの網羅性の限界、長期的・きめ細かな制御の弱さ、実際のインタラクティブな使用を反映しない評価設定を主要なボトルネックとして指摘し、統合ワールドモデル、三モーダルアライメント、より豊かな埋め込みベンチマークの研究を推進している。
テーマの状況
代表的な導入部では、狭いマルチモーダルシステムから、インタラクション・制御・評価を支えるより統合的な表現への移行が描かれている。OmniNWMは、運転用ワールドモデルが依然として短時間のRGB中心の状態モデリング、疎なアクション符号化、弱い報酬統合に制約されていると主張し、マルチモーダルな状態・行動・内的報酬を一つのフレームワークで統合モデル化する方向を推進している。Nexus-Oは知覚側から並行して、三モーダル(言語・視覚・音声)システムは高品質データセットの不足、高コストなアライメント、不十分なロバスト性評価により限界があり、モダリティの追加だけでなく効率的なアライメントと現実的な環境でのテストが進歩の鍵だと論じている。
同様の圧力は今週の埋め込み研究にも見られる。Omni-Interactive Universal Embedder(arxiv:2608.27044v1)は、テキストのみのインタラクションでは多くの検索・表現タスクに対して粒度が粗すぎると主張し、テキスト・視覚・音声プロンプトにまたがるオムニインタラクションと、ユーザー条件付きマルチモーダル検索のための新ベンチマークOmniCHOIRを提案している。SynthScribeなどの応用志向の研究と合わせると、静的なマルチモーダル符号化から、インタラクティブかつユーザー条件付きで、よりきめ細かな実世界条件下で評価される表現へと分野が移行しつつある状況が示唆される。
- SynthScribe: Deep Multimodal Tools for Synthesizer Sound Retrieval and Exploration
- Nexus-O: An Omni-Perceptive And -Interactive Model for Language, Audio, And Vision
- OmniNWM: Omniscient Driving Navigation World Models
- Long-Horizon Audio-Visual Generation for Persistent Stories and Interactive Worlds
- Omni-Interactive Universal Embedder
インフォグラフィクス(日本語)
今週の進展
EchoWM: Open and Enterable Omnimodal World Models <See Details on Fugu-MT>
EchoWMは、連続的なナビゲーション条件下で720p動画・環境音・音楽・音声を同時に生成することで、統合ワールドモデリングを没入可能なオムニモーダルメディアへと拡張した。 これにより、RGBのみや三モーダル構成から、シーンの進化とより豊かな音声チャネルを結合する単一のインタラクティブモデルへとテーマが拡大された。
Long-Horizon Audio-Visual Generation for Persistent Stories and Interactive Worlds <See Details on Fugu-MT>
JoyAI-Echo-1.5は、クロスショットメモリと校正済み6-DoFナビゲーション軌跡を注入するワールドモデル変種を導入し、長期的な視聴覚生成を実現した。 短コンテキストのマルチモーダル生成と比較して、拡張されたシーケンスにわたる永続的なアイデンティティの一貫性と明示的なインタラクティブカメラ制御を追加した。
Omni-Interactive Universal Embedder <See Details on Fugu-MT>
OmniUEは、テキスト・動画・音声にまたがる統一埋め込み空間を学習し、テキスト・視覚領域・音声区間によるユーザー条件付きクエリをサポートする。 テキストのみの検索インターフェースを超え、新たな評価スイートOmniCHOIRを通じてマルチモーダル表現を直接インタラクティブかつベンチマーク可能にした。
今後の展望
今後の展望(要約)
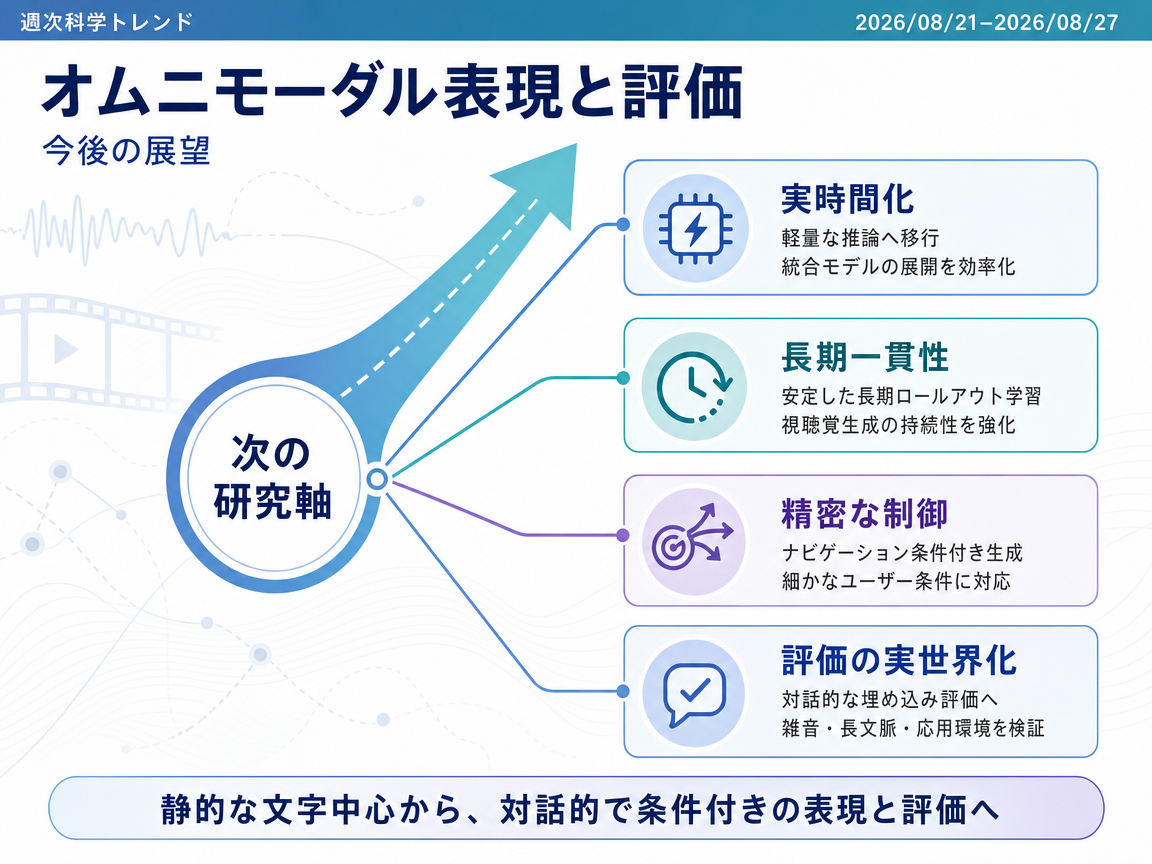
統合型マルチモーダルモデルは、単に扱える入力形式を増やすのではなく、実用性を高める方向へ進む可能性が高い。長時間の生成、音声と映像を組み合わせた対話、移動を制御できる仮想世界に関する最近の研究は、推論の軽量化と長時間動作の安定化を促している。また、リアルタイム処理でも細かな制御が可能になりつつある。表現方法も静的な文章中心から、利用者が選んだ映像や音声を反映する埋め込み表現へ広がっている。このため評価では、雑音の多い環境や長い文脈、専門性の高い場面を含む、現実に近いマルチモーダル試験が必要になる。
インフォグラフィクス(日本語)
3年後を想定した動き
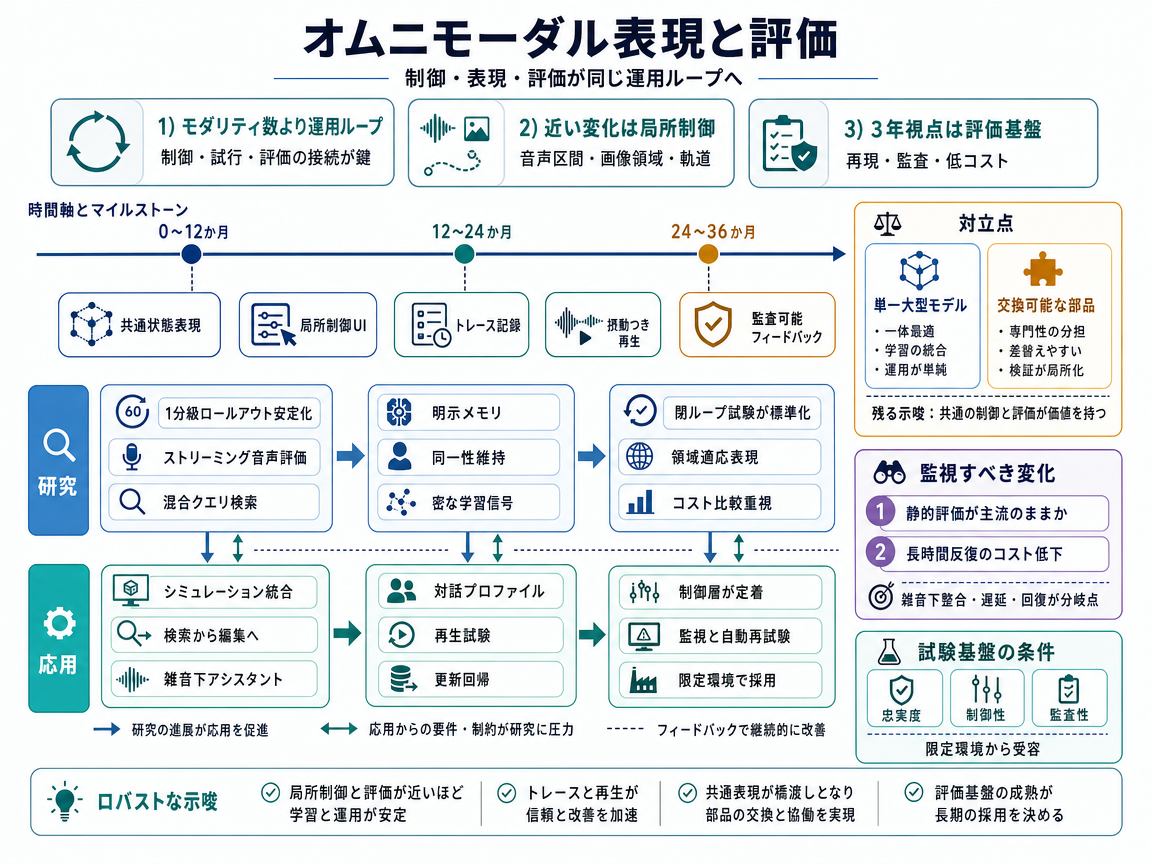
標準シナリオでは、外界を捉えて応答を生成し、その結果を評価して次の行動へつなげる統合型マルチモーダルシステムが発展する。初年には、推論コストの削減とストリーミング音声への対応が進み、複数形式を組み合わせた質問の試験が日常的になる。研究者は記憶と対象の一貫性も改善し、生成世界を長時間安定させようとする。シミュレーターや制作支援ツールでは、広い意味の文章指示だけでなく、指定領域や移動経路を使った局所的な制御が導入される。
2年目には、モデルが行動して結果を観察し、同じ試験内で次の行動を調整する閉ループ評価が広がる。利用者が選んだ例や内容を表す埋め込み表現は、依頼ごとに作り直されず、セッションを通して保持されるようになる。汎用モデルが専門用語や重要な関係を十分に表現できない分野では、専用アダプターが使われる。提供者は、中断からの復帰や移動指示への反応を検証し、長時間の一貫性も確認できる試験を整備する。
3年目には、移動操作の継続的な練習や、制作・産業用ツールでの細かな制御が可能になる。対話型環境では、用途に合わせた試験も実施される。比較の中心は対応形式の数ではなく、雑音下での確実な制御と長い文脈での安定性、さらに有用な対話当たりの計算コストへ移る。現実的な試験で制御上の失敗を発見し、その結果を改善に反映する循環が、長時間動作をさらに安定させる。安定した動作から得られる代表性の高い記録は、後の学習と評価にも役立つ。
重要な観測点は、複数形式の質問を扱う画面と長時間試験が、専門ツールや評価サービスの標準機能になるかどうかである。一方、短い静的試験が中心のままの場合や、雑音下のリアルタイム音声が不安定な場合、長時間動作の反復コストが高止まりする場合には、このシナリオの実現性が弱まる。
対抗シナリオでは、一つのモデルにすべての機能を持たせず、複数の構成要素を連携させる分散型マルチモーダル基盤が発展する。その仕組みは通信システムの相互運用性に似ており、共通のインターフェース仕様と再実行試験、適合性確認によって、全体を作り直さずに部品を交換できる。初年には、外部から操作できる機能が、時刻情報付きの対話記録へ変換される。この記録には入力とモデル状態、フィードバックが含まれ、出来事の順序と時間関係も保存される。評価では、再実行ごとに同一の出力を求めるのではなく、同期の正確さや指示への追従、失敗後の復帰を調べる。
2年目には、評価基盤の管理者とツール提供者が、少数の共通対話プロファイルを定める。各プロファイルは、システムが受け取る情報と外部に示す動作を規定し、障害からの復帰方法も示す。試験パッケージは人工的な負荷事例と保護された実環境の記録を組み合わせ、自動評価が実用的な振る舞いを測れているかを人が確認する。開発チームは、対話の収集と失敗の再現に使える共通ツールを利用し、同期したデータの流れも観察できる。組織ごとに同じモデル構造を採用しなくても、用途固有の要件を追加できるようになる。
3年目には、互換性のあるシステムから再利用可能な記録が増え、失敗の分類と回帰試験が改善される。試験の質が上がるほど、構成要素を更新または交換する際の互換性の価値も高まる。共通の制御・記録・評価インターフェースが、専用の表現モデルや生成器を一つの層の背後で接続する。研究の焦点は、状況に応じた処理経路の選択や更新後の継続確認へ広がり、異なる入力形式の不一致による失敗も詳しく調べられる。
重要な観測点は、同じ記録・再実行形式が、独立した複数の評価基盤や応用試験環境で再利用されるかどうかである。構成を分けたシステムで遅延や整合性の低下が続く場合や、共通仕様が互換性のない版へ分裂する場合、このシナリオは難しくなる。適合性確認だけでは意味の同等性や未知の状況での安全性まで保証できないため、システム全体の試験と人による確認が引き続き必要である。
可能性シナリオでは、高精度シミュレーターの承認に似た適格性認定の仕組みが導入される。生成環境は、制御の正確さと頑健性を示し、現実の観測との信頼できる対応関係を証明した場合に限って、範囲を限定した試験に利用される。初年には、モデル固有の評価値が、再現可能な忠実度確認手順へ置き換えられる。この手順では、生成された空間構造が期待される配置にどれだけ近いかを測り、移動経路が操作指示に従う精度も調べる。さらに、動作が定められた誤差範囲に収まる時間を測定する。敵対的試験では、見た目は自然でも誤った物理規則に従う場面を探す。
2年目の進展には、公的機関または大規模な導入主体が、限定された運用領域で認定済みの技術基盤による証拠を受け入れることが必要になる。評価では、世界の動きと知覚処理を分け、制御への応答も独立して調べる。生成試験と現実の挙動を比較する共通基準が必要になるため、公開された参照場面と独立機関による対応関係の研究が重要になる。追跡可能な記録には、モデルの版と場面の出所を残し、観測された失敗も保存する。珍しい状況や安全性が重要な事例では、現実環境での試験も引き続き必要になる。
3年目には、範囲を限定した認定制度が、性能向上を促す循環を生む可能性がある。認定された仮想試験が反復的な現実試験を減らせれば、より大規模な適合性試験を実行でき、モデルの安定性も向上する。性能が改善すれば、仮想試験として認められる場面の範囲をさらに広げられる。段階別の制度では、通常の回帰確認と高い保証が必要な証拠を分け、関連手法を倉庫ロボットや点検ドローンにも応用できる。
決定的な観測点は、版管理された参照データ群と独立試験機関に支えられた限定的な受け入れ制度が登場するかどうかである。再実行型システムや従来の物理エンジンだけが認められる場合、またはモデルの評価値が現実の閉ループ動作を予測できない場合、このシナリオは弱まる。推論コストが高いままなら、信頼できる認定に必要な反復試験を十分に実施できない可能性もある。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- SynthScribe: Deep Multimodal Tools for Synthesizer Sound Retrieval and Exploration - 著者: Stephen Brade, Bryan Wang, Mauricio Sousa, Gregory Lee Newsome, Sageev Oore, Tovi Grossman / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Nexus-O: An Omni-Perceptive And -Interactive Model for Language, Audio, And Vision - 著者: Che Liu, Yingji Zhang, Dong Zhang, Weijie Zhang, Chenggong Gong, Haohan Li, Yu Lu, Shilin Zhou, Yue Lu, Ziliang Gan, Ziao Wang, Junwei Liao, Haipang Wu, Ji Liu, André Freitas, Qifan Wang, Zenglin Xu, Rongjuncheng Zhang, Yong Dai, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- OmniNWM: Omniscient Driving Navigation World Models - 著者: Bohan Li, Zhuang Ma, Dalong Du, Baorui Peng, Zhujin Liang, Zhenqiang Liu, Chao Ma, Yueming Jin, Hao Zhao, Wenjun Zeng, Xin Jin, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Long-Horizon Audio-Visual Generation for Persistent Stories and Interactive Worlds - 著者: Nan Duan, Haoyang Huang, Weiyang Jin, Haoran Li, Yaowei Li, Yuming Li, Yijun Liu, Xin Lu, Xiaoxiao Ma, Yanwen Ma, Yaofeng Su, Yilang Sun, Haoyu Wang, Zeyue Xue, Songchun Zhang, Junhao Zhuang / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- Omni-Interactive Universal Embedder - 著者: Wei-Yao Wang, Kazuya Tateishi, Shuyang Cui, Christian Simon, Takashi Shibuya, Shusuke Takahashi, Yuki Mitsufuji / <See Details on Fugu-MT> / ライセンス: CC BY 4.0