サマリー
本テーマは、固定的な設定でエージェントを評価する段階から、エージェントの振る舞いを形作る環境・インタラクションループ・ランタイムスキャフォールドをスケーリングする段階への移行を中心に据えている。代表的な論文群は、エージェント性能の向上がモデルの推論能力だけでなく、より豊かなタスク生成、より現実的なインタラクション、より良いフィードバック、そしてタスクに適したハーネス設計にも依存することを論じている。
テーマの状況
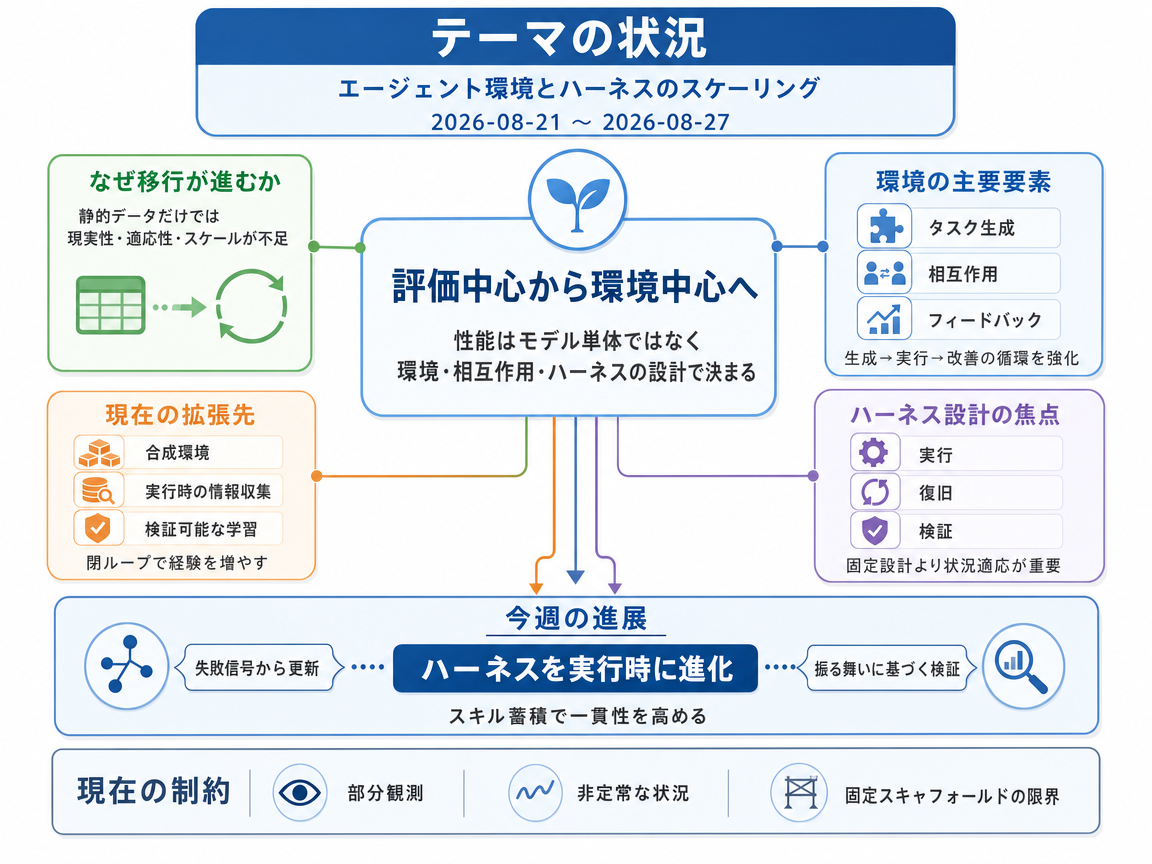
代表的な導入論文群は共通のボトルネックを指摘している。静的なデータセットに対する教師あり学習は、閉ループ環境で行動するエージェントに必要な現実性・適応性・スケールを十分に提供できない。サーベイ論文「Scaling Environments for LLM Agents in the Era of Learning from Interaction」は環境を経験の能動的な生成源として捉え、生成–実行–フィードバックのループを軸に進展を整理し、タスクの複雑性と多様性、より豊かなインタラクティビティとリアリズム、そしてより密で自動化されたフィードバックを強調している。並行して「Thinking vs. Doing: Agents that Reason by Scaling Test-Time Interaction」は、部分観測可能または非定常な環境では、エージェントは行動前に長く考えるだけでなく、追加のインタラクションステップを通じて情報を収集する必要があると主張している。
補足的なエビデンスはこの環境中心の視点をソフトウェアエージェントに拡張している。「Training Versatile Coding Agents in Synthetic Environments」は、完全に合成的で検証可能なコーディング環境が、狭いイシュー解決タスクを超えて訓練を広げ、既存リポジトリへの依存を減らせると論じている。今週のエビデンスとして、「JIT-Agent: Scaling Harness Intelligence via Just-in-Time Harness Evolution」(2608.25593v1)は議論を環境設計からハーネス設計へと推し進め、エージェント能力はモデルとハーネスのペアの特性であり、タスク固有のメモリ・計画・行動・能力スキャフォールドはデプロイ前に固定するのではなく、ジャストインタイムで生成・修正される必要があると主張している。
- Thinking vs. Doing: Agents that Reason by Scaling Test-Time Interaction
- Scaling Environments for LLM Agents in the Era of Learning from Interaction: A Survey
- Training Versatile Coding Agents in Synthetic Environments
- AutoSaddler: Automatic Harness Optimization with Durable Updates from Agent Execution Traces
- JIT-Agent: Scaling Harness Intelligence via Just-in-Time Harness Evolution
インフォグラフィクス(日本語)
今週の進展
JIT-Agent: Scaling Harness Intelligence via Just-in-Time Harness Evolution <See Details on Fugu-MT>
JIT-Agentは、カスタマイズ・修復・進化的最適化の3段階パイプラインを通じて、推論時にタスク適応型エージェントハーネスを合成するハーネス知能モデルを訓練する。 新規性は、固定的な事前設計のスキャフォールドに依存するのではなく、ジャストインタイムのハーネス生成自体を学習可能な能力として扱う点にある。
Prime Agent: A Self-Improving RLM Harness <See Details on Fugu-MT>
Prime Agentは、長期的なコーディングエージェント向けに実行・復旧・検証・リソース管理を標準化するオープンソースハーネスを提供する。 新規性は、戦略立案を完全にモデルに委ねつつ、規律あるランタイムハーネスが大きな性能向上をもたらすことを実証した点にある。
AutoSaddler: Automatic Harness Optimization with Durable Updates from Agent Execution Traces <See Details on Fugu-MT>
AutoSaddlerはハーネス最適化をオフライン学習問題として定式化し、エージェント実行トレースの失敗信号からプロンプト・ツール・ミドルウェアを反復的に改善する。 新規性は、診断・構造化パッチ・汎化を考慮した選択の原理的ループにより、複数ベンチマークにわたって耐久性のあるハーネス更新を生成する点にある。
Verify Smarter, Evolve Further: Efficient Harness Evolution through Behavior-Aware Verification <See Details on Fugu-MT>
HarnessLensは、自動ハーネス進化の過程でハーネス候補をより効率的にスコアリングする予算考慮型検証フレームワークを導入する。 新規性は、固定タスクセットで全候補を網羅的に評価することを回避する、振る舞い考慮型の検証手法にある。
TRACE: A Self-Evolving Skill Bank for Consistent, Limit-Aware LLM Agents <See Details on Fugu-MT>
TRACEはモデルの重みを変更せずにエージェントの振る舞いを安定化させるスキルバンクを反復的に改善し、一貫性を大幅に向上させる。 新規性は、自己進化する行動知識をランタイムスキャフォールドの一部として活用し、モデルの高いポテンシャルをより一貫した性能に変換する点にある。
今後の展望
今後の展望(要約)
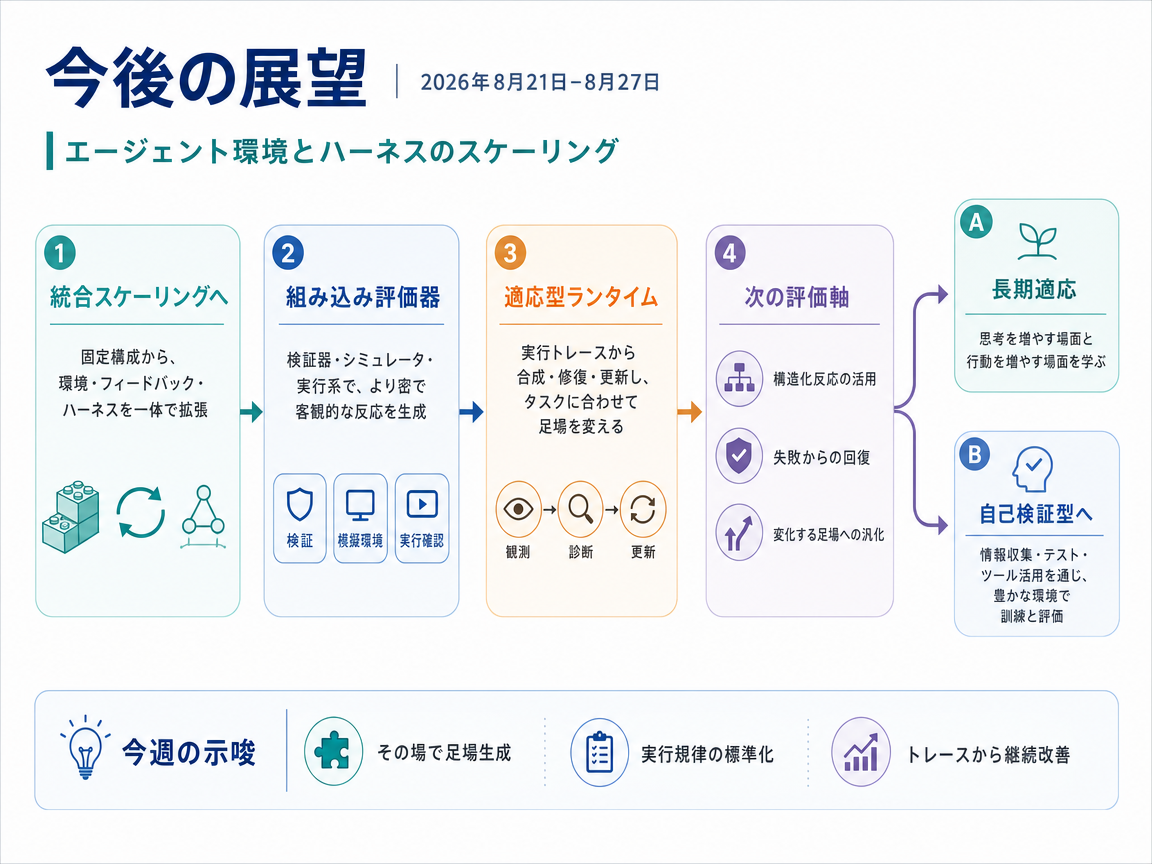
短期的には、固定されたエージェント設計を改良する研究から、環境、フィードバック循環、対話時間を実行基盤とともに拡張する研究へ重点が移る。組み込みテスト、コンパイラ、シミュレーターは、密度が高く客観的な評価信号を提供でき、実行履歴から適応的な実行基盤を生成したり修復したりできる。評価対象もモデル単体ではなく、フィードバックの活用、失敗からの回復、変化する支援構造への適応を含むシステム全体になる。長期的には、いつ考え、行動し、追加情報を集めるべきかも研究され、多様で検証可能なコーディング環境、ウェブ環境、マルチエージェント環境で訓練・評価される自己点検型エージェントへ向かう。
インフォグラフィクス(日本語)
3年後を想定した動き
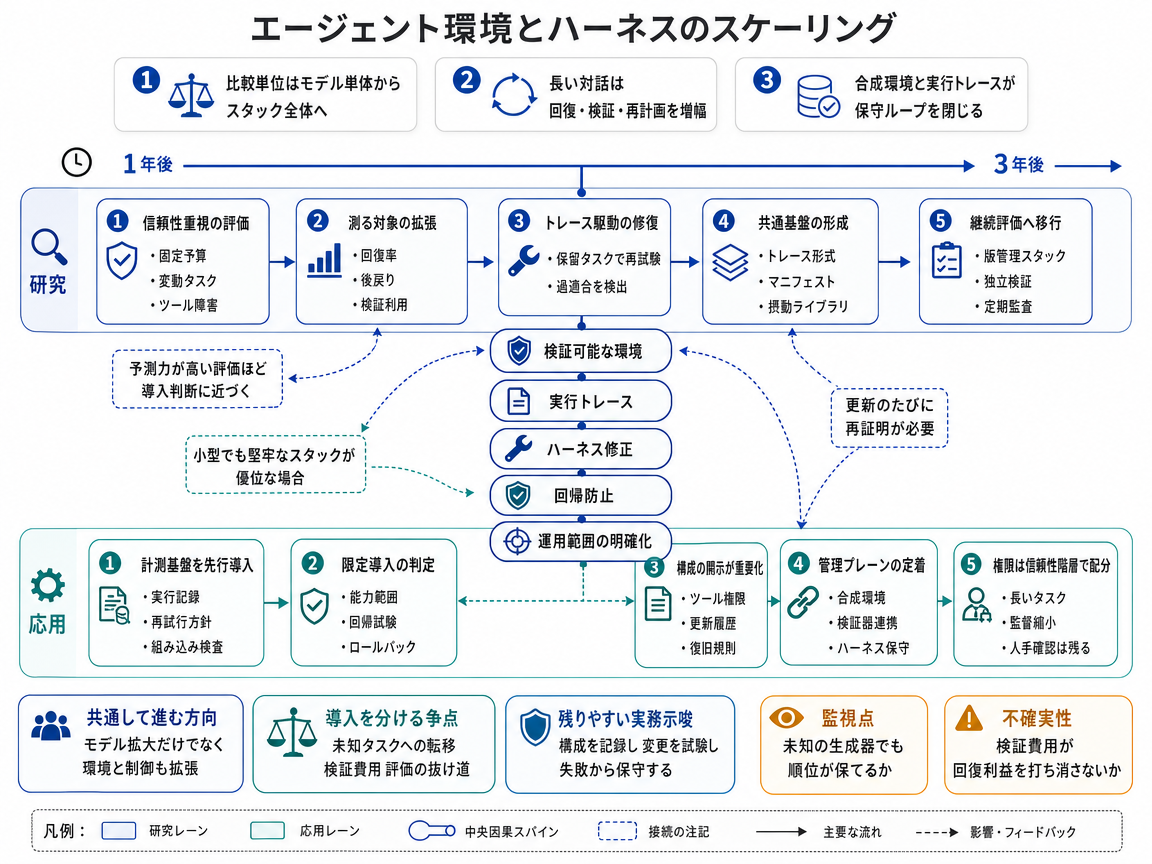
中心的な変化は、モデルの静的な比較から、版管理された「モデルと実行基盤の一体システム」の評価への移行である。実行基盤とは、ツールの利用、フィードバック、失敗時の回復を制御する周辺の仕組みを指す。テスト、コンパイラ、シミュレーターによる客観的な確認を使い、最高性能を時折出すだけでなく、安定した結果を返せるかを判断する。
1年目には、コーディングとウェブの評価で、時間、行動回数、計算量の上限をそろえて完全なシステムを比較する。自動生成した課題の変種により、古い観測情報や壊れたツールに直面させ、中断後の再開能力も調べる。重要な節目は、最高性能が低いシステムでも、新しい課題をより確実に完了することで順位が逆転し、その結果が再現されることである。組織は再生可能な実行履歴、明示的な検査、復元手順を整え、文書化された能力範囲内でのみ利用を広げる。
2年目には、信頼性の得点が実際の成果を予測できれば、共通の技術基盤が形成され始める。実行履歴の形式、実行基盤の記述方法、資源使用量の計測規則が共有され、独立した比較が容易になる。信頼できるシステムほど利用が増え、蓄積した履歴が新たな失敗を明らかにし、その失敗が課題生成法と回復法を改善する循環が生まれる。ツールや周辺の実行部品を更新する際には、公開前の回帰テストが一般的になる。
3年目には、評価と保守が継続的な工程になる可能性がある。自動制御システムが履歴から実行基盤の修正案を作り、未見の合成環境で検証し、信頼性が下がれば元に戻すようになる。注目すべき兆候は、モデル単体ではなく認定済みの完全なシステムに対し、組織がより長い課題と少ない監督を認め始めるかどうかである。ただし、豊かな評価指標が新しい課題での性能を予測できない場合や、資源使用量をそろえると回復能力の向上が消える場合、この流れは弱まる。意味解釈を伴う課題には曖昧さがあり、弱い検査を意図的に攻略される恐れもあるため、複数の評価手段と定期監査は引き続き必要になる。
このシナリオでは、環境生成と実行時の適応を、モデルの補助機能ではなく能力の主要な源と捉える。生成課題が多様な経験を与え、実行可能な検査が行動と修正の間にフィードバック循環を作る。さらに、実行履歴から実行基盤を修復できれば、モデルの重みを変えなくてもシステム全体を改善できる。
1年目には、合成環境を作る仕組みがソフトウェア開発以外にも広がり、特にウェブ作業と構造化されたツール利用で試される。評価では、モデル、環境、実行基盤のどこから改善が生じたかを分けて測る。失敗した一連の行動は原因を診断され、指示文やツール利用規則を変更した後に再実行される。各課題に同じ対話時間を使うのではなく、追加情報を集める時点、引き返す時点、停止する時点も学習する。実用的な基盤は、生成課題、隔離された実行環境、履歴記録を組み合わせ、実行基盤の変更ごとに版管理と回帰テストを行う。
初期の決定的な節目は、優れた適応型実行基盤を備えた中規模モデルが、弱い実行基盤を使う大規模モデルを未見の長期課題で上回り、その結果が独立に再現されることである。これが実現すれば、2年目には履歴に基づく保守が日常化し、完全なシステムの構成も詳しく記述されるようになる。有用な動作方法は再利用可能な支援構造として保存され、モデル更新後も使い続けられる可能性がある。利用拡大によって履歴が増え、その履歴が回復と検証を改善し、強化されたシステムがより広い課題へ安全に挑むという累積的な仕組みが働く。
3年目には、再利用可能な環境生成器、隔離されたツール、検証部品が共通の技術基盤になる可能性がある。小規模なチームでも、すべての課題と検査を手作業で設計せずに長期作業向けシステムを構築できる。強い兆候は、モデルと実行基盤を組み合わせた完全なシステムが、評価と採用の標準単位になることである。ただし検証器が弱ければ、生成課題が目的からずれたり、答えを漏らしたり、意図しない行動を高く評価したりする。未知の環境へ適応できない場合や検証費用が急増する場合、または改善要因を分離できない場合、この手法は実行結果を明確に確認できる課題に限られる。
実行履歴に応じて実行基盤が変化するようになると、能力は安定したモデルだけでなく、移り変わる実行時構成にも左右される。すると、障害発生時にどのツールや検査が有効だったか、どの回復規則が使われたかを利用者が把握できないという説明責任の問題が生じる。このシナリオでは、配備された各構成を識別し、試験可能にすることが中心となる。
1年目には、モデルの動作と、指示文やツールなどの周辺要素による効果を分離する方法が研究される。機械可読の構成記録、署名付きの更新履歴、実行の再生機能により、変更点を記録して事故の再現を助ける。合成されたコーディング環境とウェブ環境は、更新後も定義済み要件を満たすか繰り返し確認する適合試験として使われる。組織は実行時の制御と更新記録に関する証拠を求め始めるが、当初の運用方法は統一されない。検証器や回復規則の変更が原因で目立つ障害が起きれば、より明確な情報開示を求める動きが加速する。
2年目の重要な節目は、少なくとも二つの影響力ある導入組織または評価機関が、互換性のある要件を採用することである。互換性のある構成記録によって各システムを比較でき、受け入れ試験で版管理されたモデルと実行基盤の組み合わせを評価できる。比較可能な記録が厳密な試験を支え、その結果から、どの実行時変更に再承認が必要かが明確になるという循環が生まれる。研究では、低費用の適合試験群と、自動変更された実行基盤をいつ再確認すべきかという判断方法が重視される。
3年目には、重大な影響を持つ用途で、認定済みの構成と更新履歴を一体の配備単位として扱う可能性がある。自動ゲートが公開前に合成環境で変更案を試し、運用中に行われた変更は履歴に基づく検査で監視する。実行基盤の部品表も役立つが、静的な一覧ではなく、動作の証拠と結び付いた更新可能な記録でなければならない。最も明確な兆候は、互換性のある記録項目、版の報告義務、独立した適合試験が広く共通化することである。ただし、組織が結果だけの試験を好む場合や、提供側が構造の開示に消極的な場合、または構成記録が実際の動作を予測しない書類作業になれば、この流れは弱まる。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- Thinking vs. Doing: Agents that Reason by Scaling Test-Time Interaction - 著者: Junhong Shen, Hao Bai, Lunjun Zhang, Yifei Zhou, Amrith Setlur, Shengbang Tong, Diego Caples, Nan Jiang, Tong Zhang, Ameet Talwalkar, Aviral Kumar, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Scaling Environments for LLM Agents in the Era of Learning from Interaction: A Survey - 著者: Yuchen Huang, Sijia Li, Minghao Liu, Wei Liu, Shijue Huang, Zhiyuan Fan, Hou Pong Chan, Yi R. Fung, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Training Versatile Coding Agents in Synthetic Environments - 著者: Yiqi Zhu, Apurva Gandhi, Graham Neubig, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- AutoSaddler: Automatic Harness Optimization with Durable Updates from Agent Execution Traces - 著者: Sungho Park, Wonjoong Kim, Rongyuan Tan, Jue Zhang, Wook-Shin Han, Pengfei Gao, Chanyoung Park, Yongqiang Yao, Rao Fu, Elsie Nallipogu, Qingwei Lin, Saravan Rajmohan, Dongmei Zhang / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- JIT-Agent: Scaling Harness Intelligence via Just-in-Time Harness Evolution - 著者: Guibin Zhang, Leo Lu, Fangzhou Xie, Kang Zhu, Junhao Wang, Zhifei Xie, Zhaochen Yu, Zihang Liu, Zhongxiang Sun, Qiankun Li, Yue Liao, Heng Chang, Xiaobin Hu, Qibing Ren, Wangchunshu Zhou, Shuicheng Yan / <See Details on Fugu-MT> / ライセンス: CC BY 4.0