サマリー
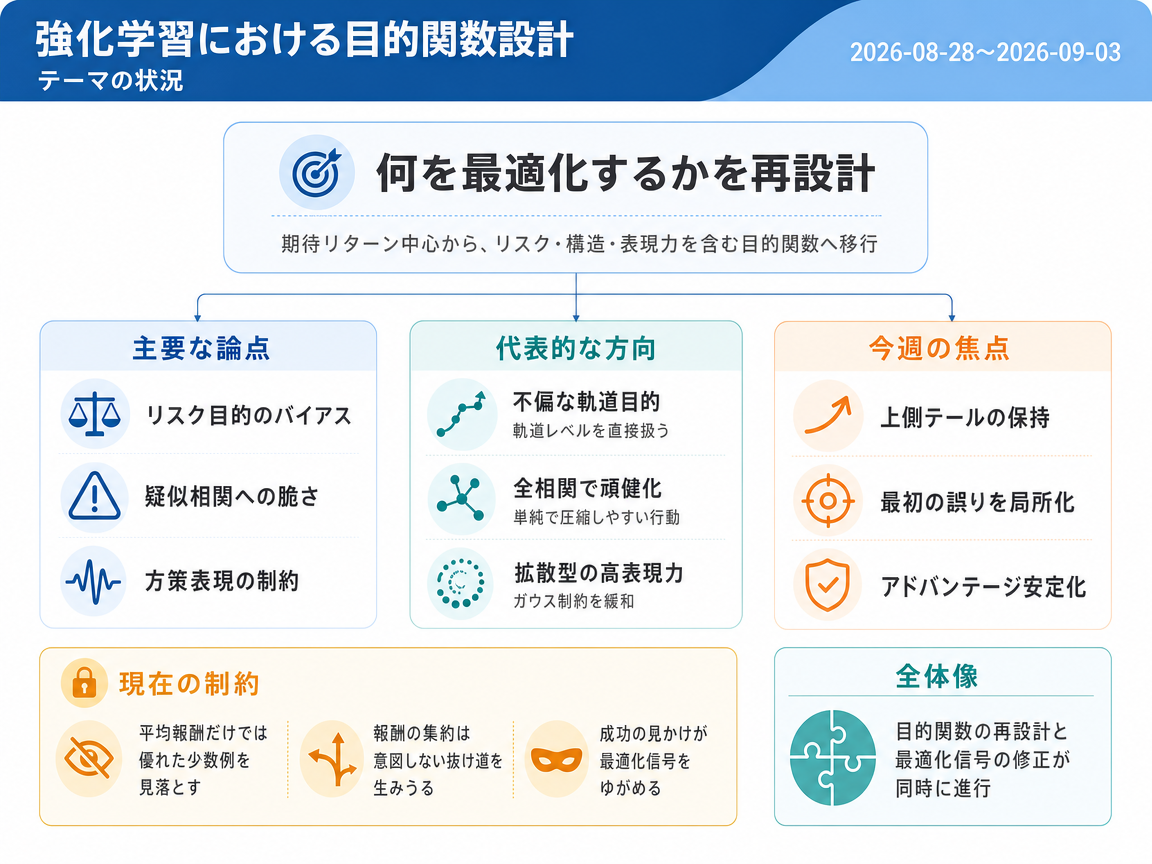
本テーマは、標準的な期待リターン訓練を超えて、強化学習が何を最適化すべきかを再考することに焦点を当てている。代表的な論文は、軌道レベルのリスク感応目的関数におけるバイアス、疑似相関による脆弱な方策、ガウス型最大エントロピー定式化における表現力の制約という3つの繰り返し現れるギャップを対象としている。今週はこの流れを拡張し、上側テールのロールアウトの保持、軌道内でのエラーの局所化、およびアドバンテージ推定の安定化に関する研究が加わった。
テーマの状況
代表論文の導入部は、報酬最大化のみから、より適切に設計された目的関数と方策クラスへのRL研究の共通的な移行を示している。一つの系統は、分布的クリティックに基づく既存のリスク感応RL手法がバイアスのある代理目的を最適化し、軌道レベルのリスク指標に対して真に最適な方策を回復できない可能性を指摘し、Trajectory Q-Learningのような不偏定式化を動機づけている。第二の系統は軌道レベルに情報理論的構造を追加し、ノイズやダイナミクスの変動下でより単純で圧縮可能かつ頑健な行動を促進する手段として全相関の最大化を提案している。第三の系統は最大エントロピーRL自体を再検討し、ガウス方策が表現力を制約することを指摘し、拡散ベースの方策とMaxEnt目的関数の扱いやすい下限を動機づけている。
今週のエビデンスは、代替RL目的関数へのこの傾向をさらに鮮明にしている。Tail-Likelihood Reinforcement Learning(arXiv:2609.02987v1)は、期待報酬では方策が稀だが極めて優れたロールアウトを保持しているかどうかが隠されてしまう可能性があり、これは継続的な方策改善とBest-of-k推論の両方にとって重要であると主張している。その導入部は、連続報酬を閾値に対するテール確率を通じて明示的に再定式化し、RLを平均改善だけでなく上側テールのカバレッジを保持する目的関数へと推進している。
- Is Risk-Sensitive Reinforcement Learning Properly Resolved?
- DIME:Diffusion-Based Maximum Entropy Reinforcement Learning
- Maximum Total Correlation Reinforcement Learning
- Tail-Likelihood Reinforcement Learning
インフォグラフィクス(日本語)
今週の進展
Tail-Likelihood Reinforcement Learning <See Details on Fugu-MT>
TailRLは、期待リターンのみではなく、ランダムな報酬閾値を超える対数確率を最適化することで本テーマを前進させた。 標準的なアドバンテージベースのRLパイプラインとの互換性を維持しつつ、上側テールのロールアウトを保持する方向に目的関数設計を新たにシフトさせた。
Uncovering and Mitigating Aggregation-Induced Reward Hacking in Multi-Reward Reinforcement Learning <See Details on Fugu-MT>
本研究は、素朴な報酬集約がハッキングを誘発しうることを示し、目的関数設計を多報酬設定に拡張した。 その貢献は、低パフォーマンス、ボラティリティ、および直近の進捗シグナルを用いて統合報酬を調整するオンライン再重み付けルールである。
Cliff: Learning Process Rewards from the First Mistake <See Details on Fugu-MT>
Cliffは、検証器ベースのRLをロールアウト中の最初の誤りにペナルティを課すプロセス報酬設定に変換することで本テーマを前進させた。 従来の軌道レベル目的関数再設計と比較して、報酬信号に局所化されたステップ単位のエラー情報を新たに注入した。
Spurious Advantage Hidden in GRPO <See Details on Fugu-MT>
本論文は、成功ロールアウトが推測に由来する場合にGRPOが誤解を招くアドバンテージを付与しうることを明らかにし、本テーマを精緻化した。 目標報酬の再定義ではなく、グローバルスケーリングとクラス別リスケーリングを通じて最適化シグナル自体の修正に焦点を当てている。
今後の展望
今後の展望(要約)
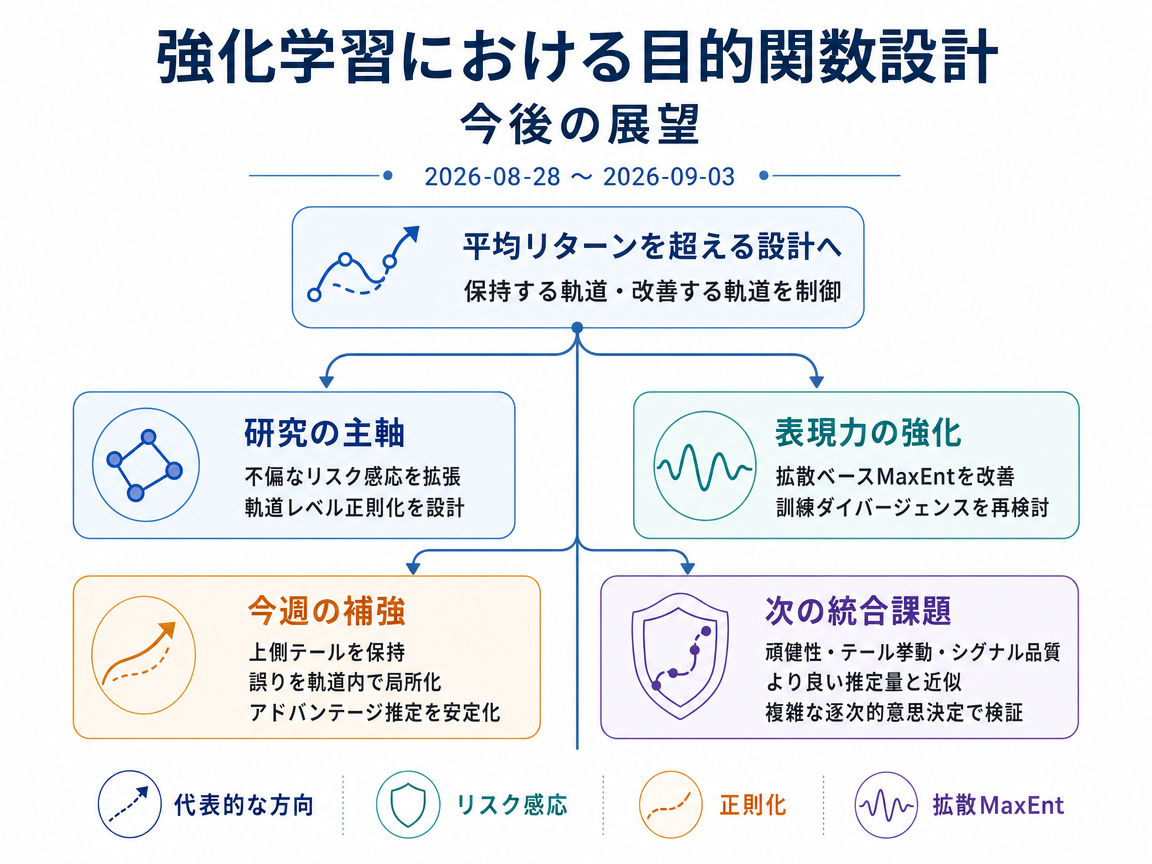
短期的な強化学習研究は、平均報酬の向上だけでなく、有用な軌跡の保持、リスクの制御、学習信号の改善を重視する方向へ進む可能性が高い。今後は、バイアスのないリスク感応型手法をより難しい課題で検証し、軌跡全体を対象とする正則化の実用的な近似法を開発するとともに、拡散モデルに基づく方策を改善する必要がある。今週の研究は、まれな成功を残し、行動系列のどこで誤りが起きたかを特定し、行動価値の推定を安定させる必要性を示した。今後は、より良い推定法と幅広い検証に支えられた統合的な目的設計が進み、まれな成功や雑音の多いフィードバックを扱いながら、大規模な学習基盤との互換性も保つと考えられる。
インフォグラフィクス(日本語)
3年後を想定した動き
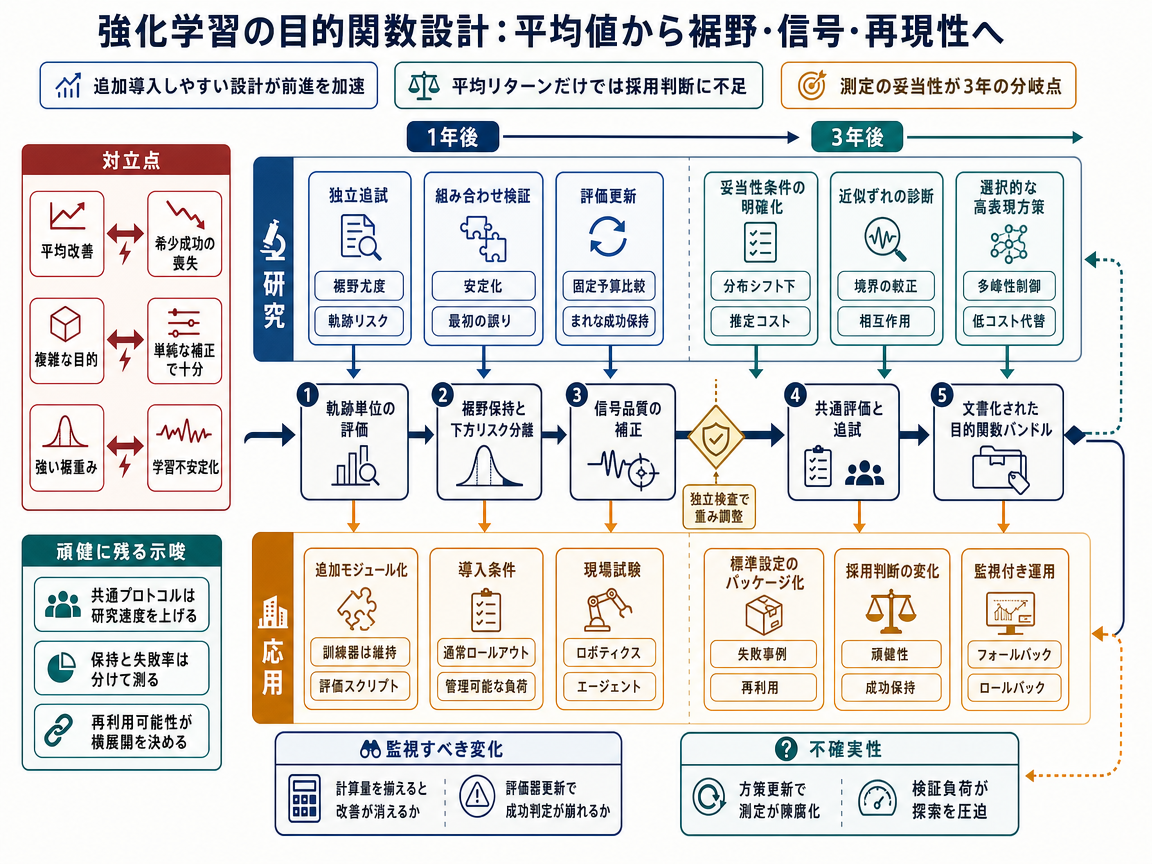
今後3年で、強化学習の目的を個別に改良する段階から、有用な行動を保ちつつ学習信号の信頼性を高める、再利用可能な組み合わせへ移る。仕組みは統計的工程管理に似ており、既存の学習基盤を保ちながら、平均報酬の上昇だけでは見えない問題を測定する。1年目には、まれな成功を再現できるか、実用的な近似法が意図した軌跡レベルの性質を測れているかを検証する。その後、行動を保持する目的と信号の補正を組み合わせ、非常に良い成功と深刻な失敗を別々に評価する。
2年目には、再現性のある組み合わせが、検証済みの標準設定を備えた学習モジュールとして文書化される可能性がある。これにより、応用チームは学習器を一から作り直さずに利用できる。研究者は、学習によって方策が遭遇する状況が変化しても信頼性が保たれるか、より単純な目的でも同じ効果が得られるかを調べる。ロボット制御と大規模言語モデルを用いるエージェントは、課題ごとの成功と失敗の定義を保ちながら、評価の考え方を共有できる。導入負担が小さければ再利用が進み、条件をそろえた実験によって、本当に行動を改善する組み合わせを見分けやすくなる。
3年目には、一部の開発工程で、平均報酬だけでなく文書化された失敗の型に基づいて目的の組み合わせを選ぶことが、通常の設計判断になるかもしれない。受け入れ確認では頑健性と成功行動の保持を調べ、複雑な手法が不安定になった場合に備えて監視手段と単純な代替法を用意する。複数の異なる成功行動を表現できる拡散方策は、一部の高次元制御課題で一般化する可能性があるが、同等に有効な単純な方策を置き換えるとは限らない。重要な監視指標は、計算量とサンプル数をそろえた条件で各手法が単独でも改善し、組み合わせた際にも更新が安定することである。最大の注意点は、方策が自らの学習データを変えるため、以前は有効だった測定値が誤解を招く可能性である。効果が消えたり調整が過剰になったりすれば、3年後の成果は広範な目的統合ではなく、軽量な補正と診断の改善にとどまる。
このシナリオでは、今後3年の焦点が、まれな高報酬行動の保持から、その行動を後の学習で強めるだけの信頼性があるかを判断することへ移る。仕組みは適応的実験に似ており、新しい証拠に基づいて、有望な行動系列を追加確認するか、学習上の重みを増やすかを決める。1年目には、特に極端に高い評価を得た試行について、学習された報酬と独立に確認された課題の成功を比較する。制御機構は、検証済みの成功が増え、別に測った失敗結果が大きく悪化しない場合にだけ、学習上の重みを増やす。成功かどうか判断が分かれる行動は、探索の候補として残す。
最初の基準は、学習と検証に必要な費用をすべて数えたうえで、単純な重み付け規則を上回る改善が再現されることである。追加データを多く集めただけの効果は、この基準を満たさない。基準を超えた場合、2年目には、方策の変化によって証拠がどの程度早く古くなるか、新しい評価サンプルがいつ必要になるかを調べる。各チームは、目的を変更したときの方策と評価条件を記録し、失敗した変更を追跡して元に戻せるようにする。再利用可能な接続機能が既存の学習器に組み込まれれば、最適化が行動を発見し、独立評価が次の学習を修正する循環が生まれる。
3年目の決定的な試験は、開発中に使わなかった新しい確認データを用い、課題や評価器が変わっても制御機構が役立つかを確かめることである。成功すれば、制御機構は目的の変更を承認、保留、撤回でき、検証は最終評価だけでなく計画的な学習入力になる。この変化は、適したエージェント課題やロボット制御課題に限定され、あらゆる環境で既存の強化学習を置き換えるものではない。早期の監視指標は、報酬と検証済み成功の不一致が記録され、新しい証拠に応じて学習時の重みが実際に変わることである。通常の学習が同じ計算資源をより有効に使える場合や、評価器を交換すると効果が消える場合、この道筋は弱まる。統計的な確認には妥当な仮定と意味のある成功基準が必要であり、無効な評価目標を制御機構だけで信頼できるものにはできない。
このシナリオは、より豊かな強化学習の目的によって、平均報酬を上げるだけでなく、珍しい成功行動を保持できるかを問う。短期的には、分布の端にある成功を保つ手法と、行動系列内の誤りを示すフィードバックが出発点になり得る。どちらも既存の学習基盤に組み込みやすい可能性がある。しかし、幅広い課題で有効かどうかは、提示された証拠からは確立していない。
その仕組みは、種子の保存庫で珍しい品種を守ることに似ている。保存した種子を増やす過程では、全体の収量が高くなっても、少数の品種が失われることがある。同様に、方策の更新で平均報酬が上がっても、まれな成功行動を再現しにくくなる場合がある。そのため長期的な方向は、新しい目的式を増やすことよりも、各目的が実際に何を保持したかを評価することに置かれる。
最も重要な監視指標は、珍しい成功を更新後にも再現できるかどうかである。その評価には、偶然の一度きりの成功と、方策が安定して生み出せる行動を区別する必要がある。現時点の説明からは、36か月までの年ごとの明確な進展経路は示せない。中心的な可能性は、新しい目的関数の設計ではなく、保持された行動の評価が研究上のボトルネックになることである。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- Is Risk-Sensitive Reinforcement Learning Properly Resolved? - 著者: Ruiwen Zhou, Minghuan Liu, Kan Ren, Xufang Luo, Weinan Zhang, Dongsheng Li / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- DIME:Diffusion-Based Maximum Entropy Reinforcement Learning - 著者: Onur Celik, Zechu Li, Denis Blessing, Ge Li, Daniel Palanicek, Jan Peters, Georgia Chalvatzaki, Gerhard Neumann, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Maximum Total Correlation Reinforcement Learning - 著者: Bang You, Puze Liu, Huaping Liu, Jan Peters, Oleg Arenz, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Tail-Likelihood Reinforcement Learning - 著者: Shrinivas Ramasubramanian, Daman Arora, Fahim Tajwar, Guanning Zeng, Qingyang Wu, Zhongzhu Zhou, Chenfeng Xu, Haiwen Feng, Yuda Song, Aarti Singh, Ruslan Salakhutdinov, J. Andrew Bagnell, Jeff Schneider, Andrea Zanette / <See Details on Fugu-MT> / ライセンス: CC BY 4.0