サマリー
本テーマは、聞きながら同時に話す音声言語システムの評価に焦点を当て、従来のターンベース評価を超える方向へ進んでいる。代表的論文および今週の論文は、粗い遅延・割り込み指標から、多ラウンド対話品質、多者参加、制御可能性、社会的に適切なフロア管理を含むより広範なベンチマークへの転換を提示している。
テーマの状況
代表的な先行研究では、全二重対話はモデルがストリーミング入力を処理しながら音声を生成する環境として記述されており、評価はラウンドベースのチャットとは根本的に異なるとされる。基盤となるエビデンスは、有用な評価には低遅延応答、割り込みおよびバックチャネル行動、発話・譲歩の自律的判断、そして多ラウンド設定におけるターン境界の曖昧さや文脈の不整合といった追加的課題の捕捉が必要であることを強調している。
近年のベンチマーク研究は、評価対象を会話メカニクスだけでなくより広範に拡張している。MTR-DuplexBenchは、全二重システムを複数ラウンドにわたる対話品質・指示追従・安全性の観点からテストすべきと主張し、Proactive Conversational Agents with Inner Thoughtsは単純な次話者予測ではなく社会的に適切な参加の測定の必要性を強調している。今週のエビデンスとして、SteerDuplex(2609.12623v1)はモデルが「何を言うか」と「どのように聞こえるか」「どのようにフロアを管理するか」を分離し、要求された内容、声の表現、ポーズ、割り込み行動を一括評価するSteerBenchを導入することで、この方向性をさらに推進している。
- A Full-duplex Speech Dialogue Scheme Based On Large Language Models
- Proactive Conversational Agents with Inner Thoughts
- MTR-DuplexBench: Towards a Comprehensive Evaluation of Multi-Round Conversations for Full-Duplex Speech Language Models
- SteerDuplex: Steerable Duplex Speech Dialogue Models
インフォグラフィクス(日本語)
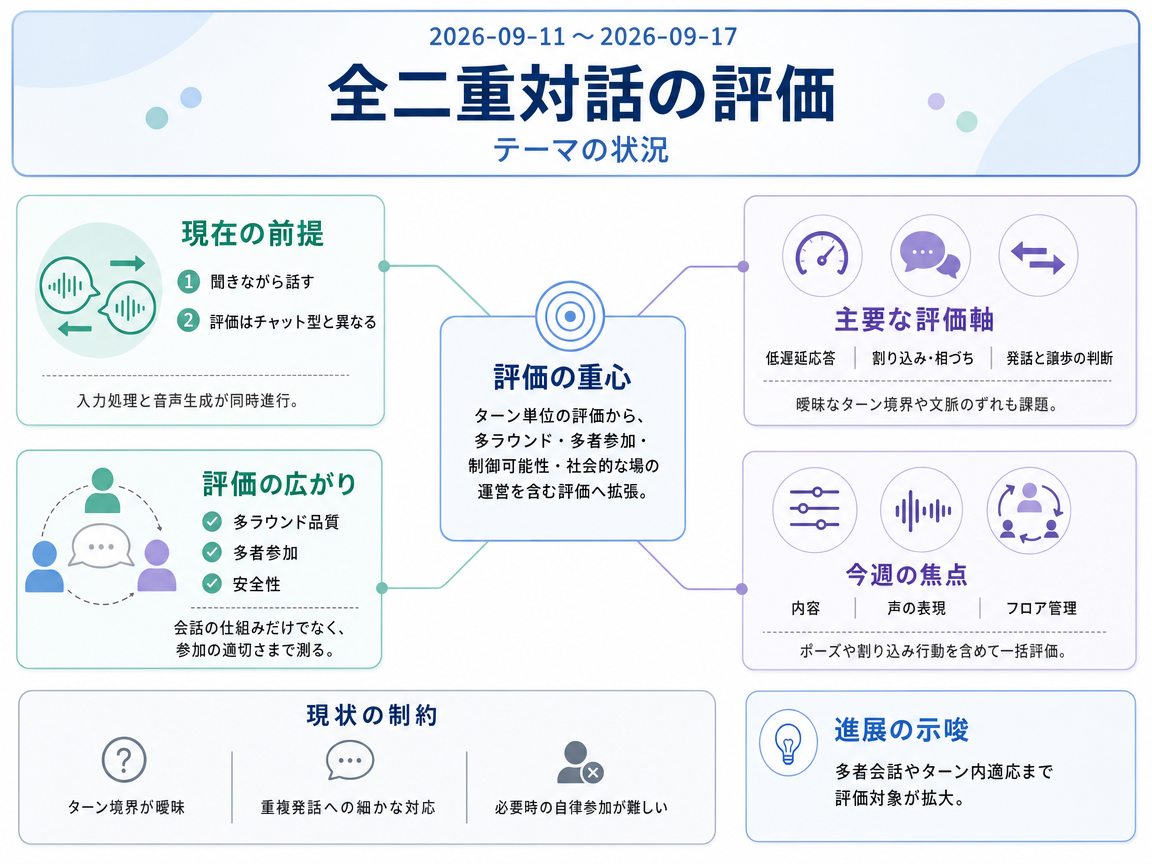
今週の進展
Realtime-Venus: A full-duplex interaction system with asynchronous delegation <See Details on Fugu-MT>
Realtime-Venus:非同期委譲を備えた全二重インタラクションシステムであり、音声対話のためのリアルタイム・オムニ・オーディオ・インタラクションを提示する。各モデルは完全な会話エージェントとして機能し、連続認識、会話制御、およびネイティブ音声生成を統合する。 本論文の具体的なタスク、手法、エビデンス、または応用設定を通じて、モデル評価・ベンチマークに接続する。
Continue, Adapt, or Yield: In-Turn Adaptation to Overlapping Speech in Full-Duplex Agents <See Details on Fugu-MT>
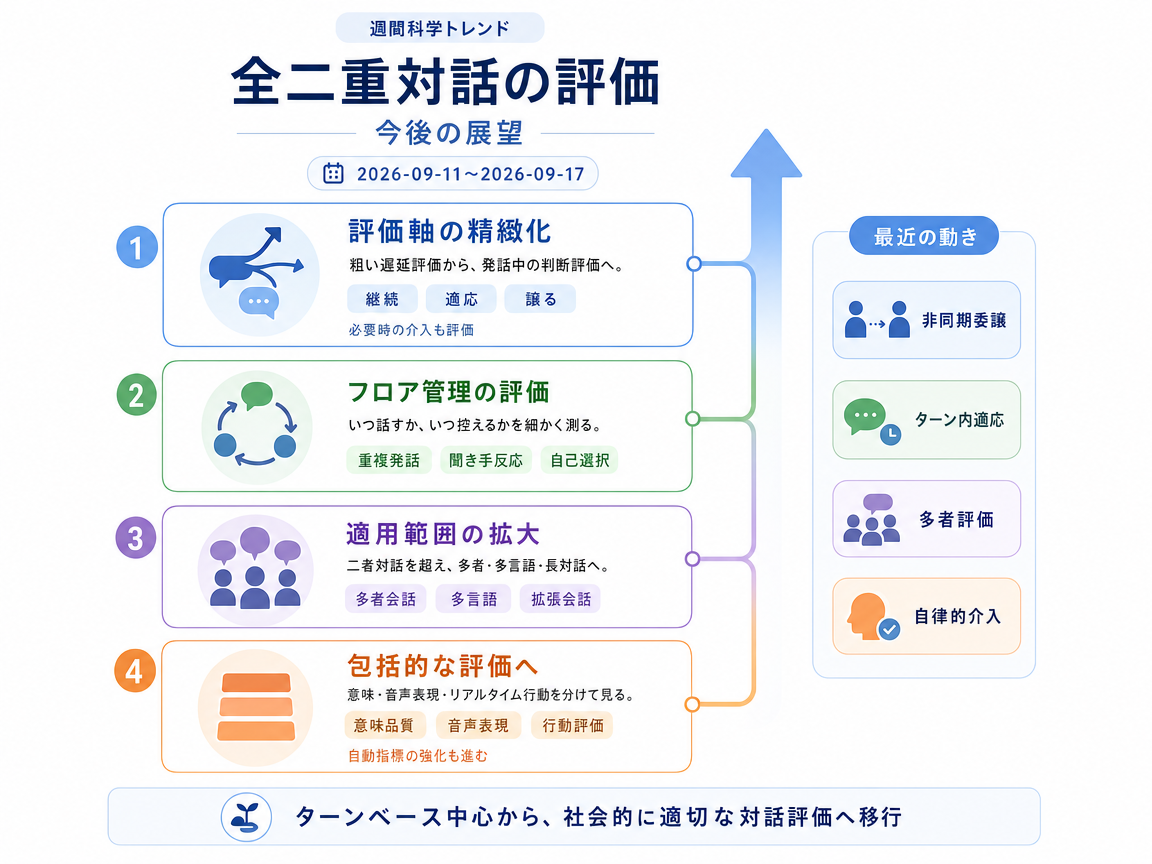
Duplex Cueは、全二重エージェントが進行中のターン内で重複発話にどう反応するかを評価する手法を導入した。 従来の汎用的な割り込み処理の評価に比べ、継続・適応・聞き手の合図への譲歩といったターン内のより細かな選択をテストする。
MP-Bench: Evaluating Voice Agents as a Multiparty Conversation Participant <See Details on Fugu-MT>
MP-Benchは、多者会話における能動的参加者としての音声エージェントを対象とした初のベンチマークを提供する。 二者間ターンテイキングを超えて評価を拡張し、多話者環境でのターンテイキング認識と応答適切性を測定する。現行エージェントはチャンスレベルに近い性能にとどまっている。
Full-Duplex Speech Models Take the Floor When Asked, Not When Needed <See Details on Fugu-MT>
本論文は、発話を求められる場合と、介入が必要な場面で自律的にフロアを取る判断との間のギャップを明らかにした。 遅延やターン管理に焦点を当てた従来のベンチマークに対し、モデルによる社会的に必要な自己選択に向けた評価の精緻化を図っている。
今後の展望
今後の展望(要約)
全二重音声対話の評価は、応答速度や割り込み回数だけでなく、相手に発話を譲る判断や、求められていない場面で発言する判断も測る方向へ進むと考えられます。複数ラウンドや多人数の試験により、短い対話では見えない問題も明らかになるでしょう。多言語データを広げるとともに、発言の意味、声による表現、リアルタイムの振る舞いを分けて測る必要があります。自動指標が改善すれば評価を拡大しやすくなりますが、音声機能がマルチモーダルモデルに組み込まれるにつれ、長い対話での自発性、指示への従い方、安全性も確かめなければなりません。
インフォグラフィクス(日本語)
3年後を想定した動き
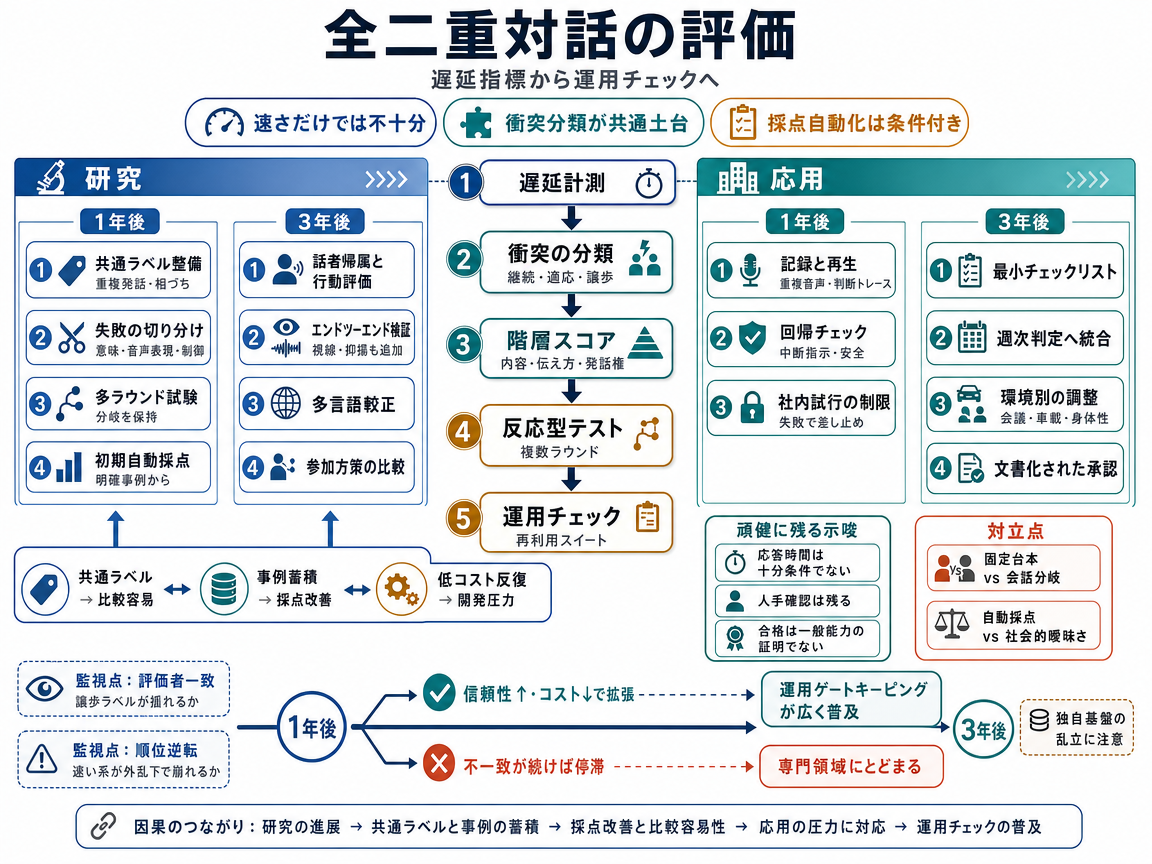
今後3年で、全二重音声対話の評価は、応答の速さよりも、共有された発話機会を適切に管理できる証拠を求めるようになる可能性があります。その仕組みは交差点の点検に似ており、まず遅れを測り、次に行動の衝突を見つけ、再現できる知見を運用上の確認項目に変えます。1年目には、研究者が発話参加に関する再利用可能なラベルを定義するでしょう。発言の意味、声による表現、会話の発話権は、別々の得点として報告されます。記録した対話履歴と再生ツールを使えば、途中で遮られたやり取りを詳しく調べられます。複数ラウンドの試験では、会話が基準台本から外れる場合にも対応する必要があります。
2年目には、共通ラベルによって結果の比較が容易になり、追加のデータ付与が進む可能性があります。それにより自動採点が改善し、繰り返し試験の費用も下がります。音声認識と話者区間の検出を組み合わせれば、音声上の出来事を、発話を続けるべきか譲るべきかという判断に結び付けられます。人間の評価者は、判断が難しい参加行動や安全上の事例に集中し、明確な事例では自動評価が人の判断と一致するかを確認します。この循環が機能すれば、モデルを更新するたびに個別の利用者調査を行わず、毎週の多層的な確認が可能になります。
3年目には、会議支援エージェント、車載システム、身体性を持つ試作機が、利用環境別の確認手順を導入する可能性があります。研究では、視線や声の手掛かりも取り入れ、対話結果と処理効率の両面から参加方針を評価します。二者間の英語対話で成功しても他の環境での信頼性は示せないため、多言語・多人数での調整が中心課題になります。重要な観測点は、独立した組織が同じベンチマークを再利用し、その個別得点を公開判断の記録に用いるかどうかです。発話を譲る判断で評価者の一致が低い場合や、自動得点が人の判断と合わない場合は、難しい評価が専門的な人手調査に依存したままになります。
今後3年で、全二重音声対話の評価は、速度や割り込み回数を中心とする方式から、混乱時の許容可能な振る舞いを調べる反応型ストレス試験へ移る可能性があります。その仕組みは電力網の障害試験に似ており、許容できる行動と時間の範囲を定め、発話の重なりによって会話条件を変化させます。1年目には、模擬対話者がモデルの実際の出力に反応し、未完の指示や別の話者を会話へ加えるでしょう。すべてのシステムを固定台本どおりに動かす方法とは異なり、進行中の会話そのものが変化します。人を対象とする調査では、その混乱が現実的か、現れた失敗が聞き手にとって重要かを確認します。反応型シミュレーターでも、不自然な行動を誘発して誤解を招く可能性があるためです。
初期の重要な兆候は、単純な速度指標では優秀なシステムが、長い発話の重なりや複数ラウンドでは失敗するという順位の逆転です。2年目には、版管理された仕様を持つ共通シミュレーターにより、研究機関が失敗を再現し、更新後にも同じ試験を実行できるようになります。人を対象とする調査は自動確認の調整に使われ、開発者はシステムが話す、待つ、譲るという判断を記録します。これにより、失敗が起きた経緯を追跡しやすくなります。複数のエージェントが同じ会話空間を共有し始めると、個別には問題がなくても、集団としての混乱を調べる共存試験が求められる可能性があります。
3年目には、指示と安全上の制約を守った場合に限り、求められていない有用な発言を評価する多層試験が整うかもしれません。検証済みの環境では自動採点が反復確認を担い、人は未知の状況を評価し、言語や会話環境に応じた基準を調整します。失敗が繰り返されると試験項目は増えますが、失敗を避けるために過度に沈黙するエージェントが有利になる恐れもあります。そのため、発言の有用性や社会的な適切さを確かめるには、対話への関与度と人の選好も引き続き必要です。独立した再利用と試験版を明記した公開判断がこの道筋を支えますが、シミュレーター間の不一致や順位の不変は、新方式の必要性を弱めます。
今後3年で、全二重音声対話の評価では、研究ベンチマークだけで共通慣行が成立すると考えるのではなく、導入側の受け入れ要件が大きな力になる可能性があります。その仕組みは同時発話を対象とする反復可能な通信試験に似ており、標準化された混乱によって振る舞いを測定可能にし、調達要件によって実務上の効力を持たせます。1年目には、研究者が割り込みの時点と発話の重なりを採点する方法を定義します。発言内容、声による表現、会話制御は別々に測り、速さによって不適切な応答が隠れないようにします。車載アシスタントや公共窓口向けシステムの開発者は、更新によって既存の動作が壊れていないかを確認するため、まずこれらの手法を使うでしょう。試験には、多言語の発話や流暢でない発話も含まれます。
決定的なきっかけは、導入側が数値による受け入れ基準を要求することです。その背景として、運転時の注意散漫やアクセシビリティを扱う団体が、割り込み試験の手順を提案する可能性があります。2年目には、提供者が結果を公開し、試験組織が共通定義を再利用する循環が始まり、評価を利用しやすくなるでしょう。開発者は公開前の確認を自動化し、モデル内部の判断であっても、発話参加の決定を説明できる制御出力を提示するようになります。研究者は固定試験への適応と対話能力の向上を区別するため、手順上の得点を未知の会話での結果と比較します。人が調整した適切さの評価で台本試験を補いますが、自発的な発言や多人数での参加は、固定場面だけでは評価しにくいままです。
3年目には、反復可能な発話重複試験に、複数ラウンドの指示確認と安全確認を組み合わせた導入用評価一式が整う可能性があります。各評価層は一つの総合点にまとめず、個別に報告されます。非公開の会話例を定期的に入れ替え、人の判断基準を再調整すれば、特定試験だけを学習する問題を見つけやすくなります。また、会議支援エージェントやロボットでの試験により、補助的な評価が新しい環境へ移せるかを調べられます。具体的な観測点は、2027年9月までに導入側が発話重複について明示的な受け入れ基準を設けるかどうかであり、実現しなければこの道筋の可能性は大きく下がります。標準化された二者間試験が普及しても、適切に発話を譲る判断は言語や状況に左右されるため、一般的な社会的能力まで証明するものではありません。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- A Full-duplex Speech Dialogue Scheme Based On Large Language Models - 著者: Peng Wang, Songshuo Lu, Yaohua Tang, Sijie Yan, Yuanjun Xiong, Wei Xia, / <See Details on Fugu-MT> / ライセンス: CC-BY-SA-4.0
- Proactive Conversational Agents with Inner Thoughts - 著者: Xingyu Bruce Liu, Shitao Fang, Weiyan Shi, Chien-Sheng Wu, Takeo Igarashi, Xiang `Anthony' Chen, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- MTR-DuplexBench: Towards a Comprehensive Evaluation of Multi-Round Conversations for Full-Duplex Speech Language Models - 著者: He Zhang, Wenqian Cui, Haoning Xu, Xiaohui Li, Lei Zhu, Shaohua Ma, Irwin King, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- SteerDuplex: Steerable Duplex Speech Dialogue Models - 著者: Utkarsh Tyagi, Ramaneswaran Selvakumar, Advait Gosai, Sonal Kumar, Nikhil Barhate, Isabell Sagar, Steven Li, Miheer Bavare, Daniel Quigley, Fabiola Tapia Carrillo, Jose M Patron E, Diego Macías Gutiérrez, Paul Song, Ramani Duraiswami, Dinesh Manocha, Yunzhong He / <See Details on Fugu-MT> / ライセンス: CC BY-SA 4.0