サマリー
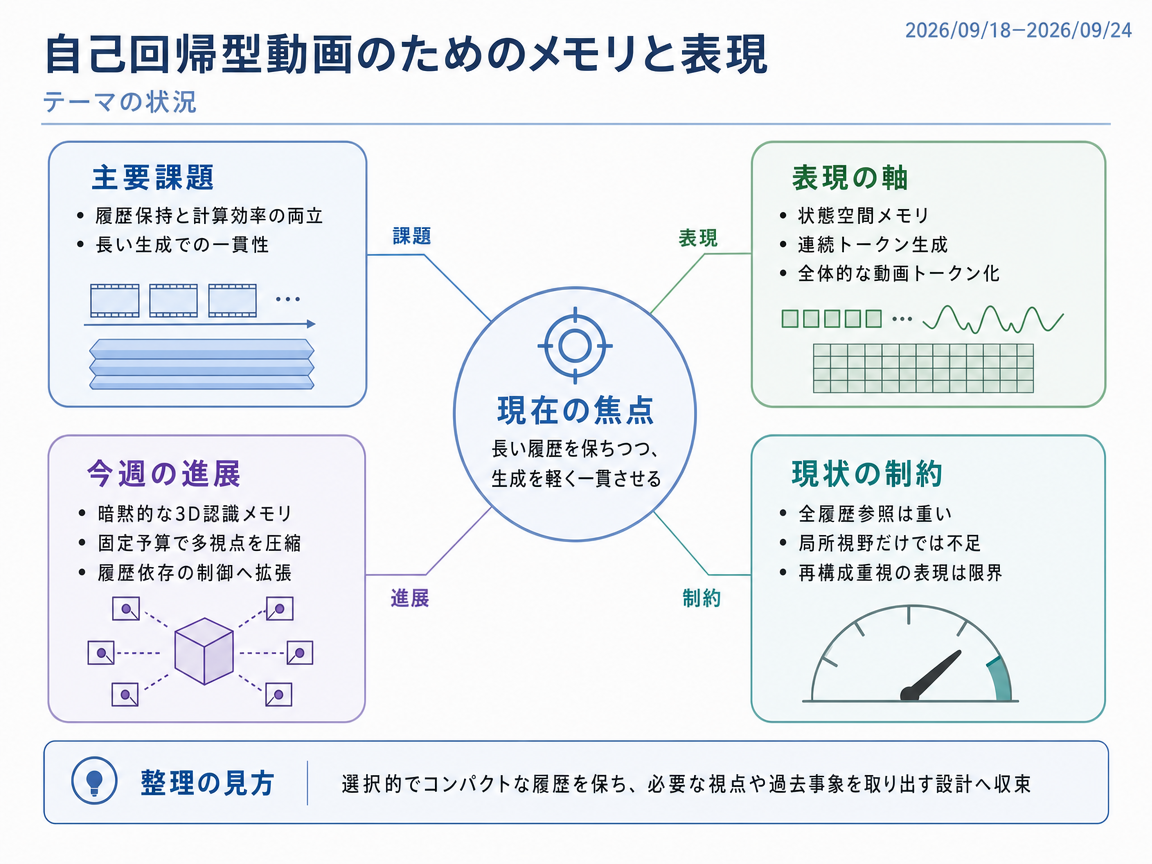
自己回帰型動画モデルの研究は、互いに関連する二つの課題を中心に展開している。すなわち、長いロールアウトにわたって有用な視覚的履歴を保持することと、生成を効率的かつ一貫性のあるものに保つ表現を学習することである。代表的な論文では、状態空間メモリ、連続トークン生成、ホリスティックな動画トークン化が探究されている。今週の成果は、動画世界モデルのための暗黙的な3D認識メモリを加えるとともに、メモリの問題を履歴依存型のロボット制御へと拡張している。
テーマの状況
代表的な先行研究の導入部は、履歴の保持と自己回帰生成の計算的扱いやすさとのトレードオフという枠組みを提示している。Long-Context State-Space Video World Modelsは、限られたアテンション窓が以前に訪れたシーンをどのように変えてしまいうるかを示し、状態空間型の時間メモリと局所アテンションを組み合わせる手法を提案している。VideoMARは、離散的な次トークン動画予測における情報損失と推論コストを課題とし、連続トークンとマスク付き空間生成を用いる。LARPは、再構成重視のパッチ単位トークナイザが必ずしも自己回帰生成に適した潜在表現をもたらすとは限らないと主張し、生成的事前分布とともに学習されるホリスティックなトークンの動機付けを行っている。
今週の論文MemBodied: Recurrent Associative Memory for Vision-Language-Action Models(2609.28256v1)は、ロボット制御における関連したニーズを指摘している。そこでは、現在の視野が正しい行動を決定する過去の出来事を含まない場合がある。同論文は、固定サイズの相互作用連想メモリと初期シーンアンカーを併用する手法を提案している。これにより、選択的でコンパクトな履歴という共通の重点が動画生成の外へと広がっている。
- LARP: Tokenizing Videos with a Learned Autoregressive Generative Prior
- Long-Context State-Space Video World Models
- VideoMAR: Autoregressive Video Generatio with Continuous Tokens
- PREM: Prefix-Steered Recurrent Memory for Long-Video Understanding
- WorldCrafter: Consistent Video World Model with Implicit 3D-aware Memory
- MemBodied: Recurrent Associative Memory for Vision-Language-Action Models
インフォグラフィクス(日本語)
今週の進展
The Past Frames the Future: Memory for Autoregressive Video Generation <See Details on Fugu-MT>
体系的レビューにより、自己回帰型動画生成のためのメモリ機構が整理された。 メモリ設計を個別に扱うのではなく、メモリを生成ステップをまたいで持続する履歴として操作的に定義している。
MemBodied: Recurrent Associative Memory for Vision-Language-Action Models <See Details on Fugu-MT>
MemBodiedは、履歴依存型の視覚・言語・行動(VLA)制御にコンパクトなエピソード記憶を導入した。 連想的な相互作用メモリと初期シーンアンカーにより、現在の視野にない情報を、エピソード長に依存しないコストで保持する。
WorldCrafter: Consistent Video World Model with Implicit 3D-aware Memory <See Details on Fugu-MT>
WorldCrafterは、カメラで問い合わせ可能な暗黙的3D認識メモリを用いて、動画世界モデルの長距離一貫性を向上させた。 全履歴へのアテンションや明示的な幾何表現に頼るのではなく、固定のメモリトークン予算内で、要求された視点に応じて多視点の証拠を圧縮する。
今後の展望
今後の展望(要約)
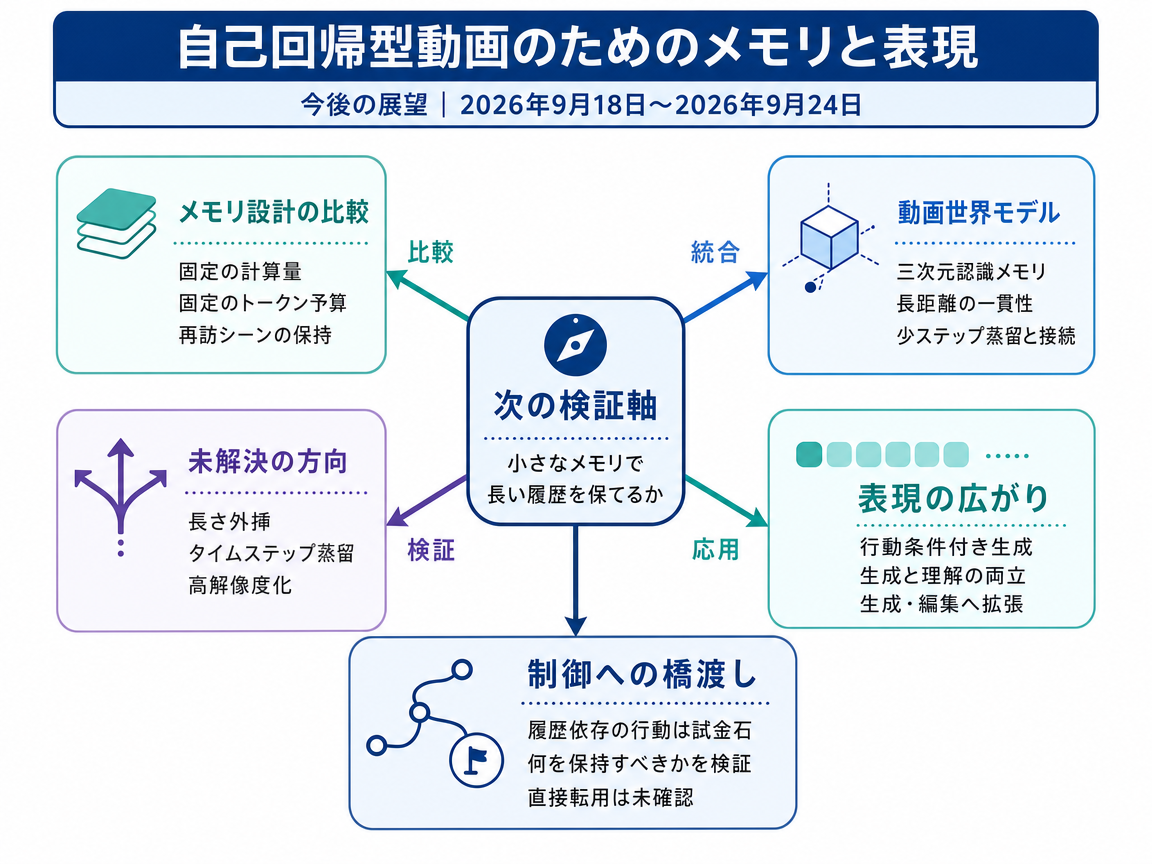
動画世界モデルの次の評価では、コンパクトなメモリが、訓練時より長い系列でも再訪した場面を保持しながら、生成の応答性を維持できるかを調べる必要がある。カメラ位置から照会できる3Dメモリと少数ステップ生成は、計算量とトークン量をそろえた設計比較や、高解像度での試験の基盤になる。表現研究では、行動を条件とする生成や、生成と理解の両方に役立つトークンが検討されるだろう。過去の情報に依存するロボット課題は記憶保持の評価に使えるが、動画生成用メモリを制御へ直接転用できるかは、まだ実証されていない。
インフォグラフィクス(日本語)
3年後を想定した動き
長期的な研究課題は、生成カメラが以前の場所に戻ったとき、コンパクトなメモリが場面を保てるかを確かめることである。訓練時より長い系列でも、この性質を評価する必要がある。生成には応答性も必要なため、記憶を増やす方法を、履歴を際限なく保存するだけで実現してはならない。過去の状態空間モデルは、履歴を内部状態へ圧縮することで、人工的な環境における空間情報の検索を改善してきた。
連続値トークンを使う生成器は、効率的なフレーム生成を可能にする。場面全体を表す学習済みトークンは、後の映像を予測するための情報を保持しようとする。ただし、これらは別々の進歩であり、現実的な世界を長時間維持できる応答性の高いシステムを示す証拠ではない。今週取り上げた、カメラ位置から照会できる3D対応メモリと固定容量の相互作用メモリは、中心的な仕組みをより明確にしている。その仕組みは、限られた情報を保持し、現在の視点や相互作用に必要な内容だけを取り出すことである。
今後の重要な観測点は、応答性を損なわずに、訓練時より長い系列でも再訪場面の一貫性を保てるかどうかである。提示された説明からは、年ごとの進展経路や、今週の論文に関する実験結果までは確認できない。したがって、少数ステップ生成は今後検証すべき方向であり、今週実証された成果でも、確立済みの3年後の到達点でもない。
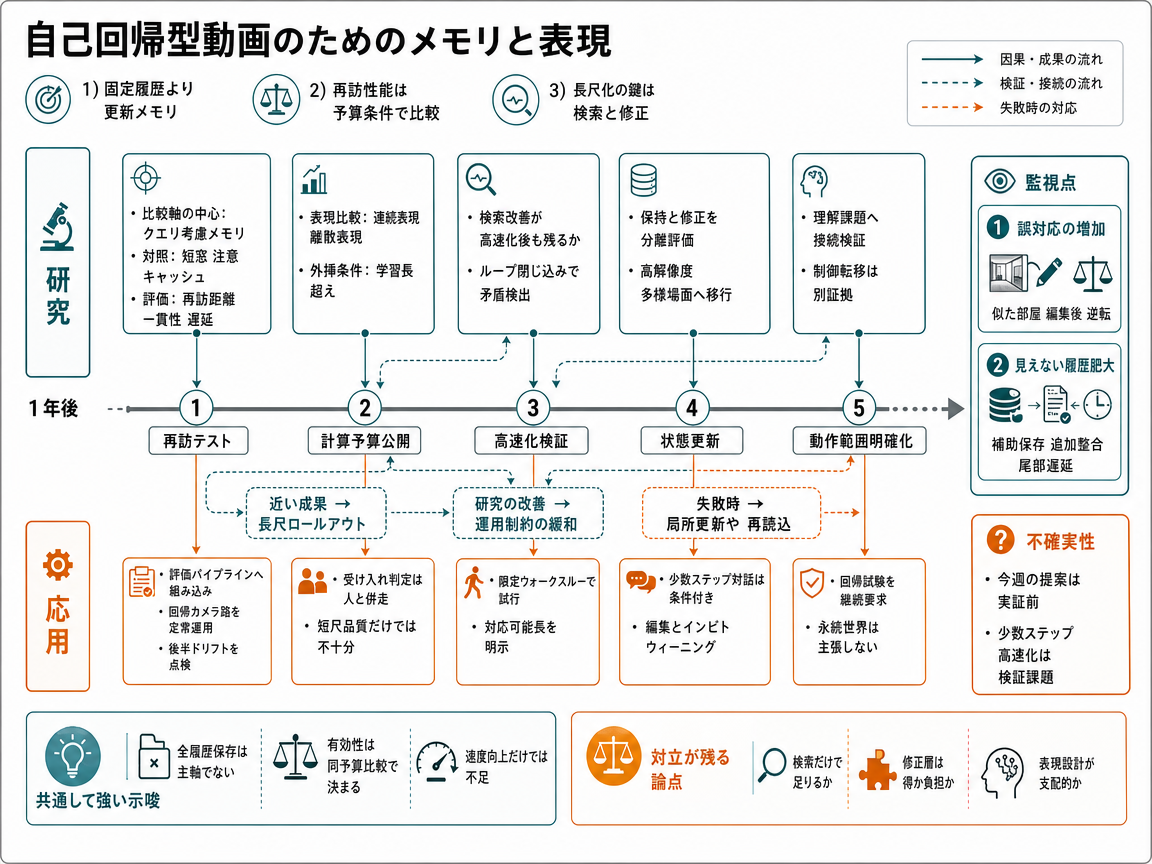
このシナリオでは3年間で、コンパクトな動画メモリを、過去の場面を検索するだけの仕組みから、矛盾する場面情報を検出し、誤りが広がる前に修正する仕組みへ発展させる。基礎となるのは、自己位置を推定しながら地図を構築するSLAMの考え方である。既知の場所へ戻った際にはループ閉合を確認し、現在の映像と記憶情報を比較して、食い違う推定を調整する。1年目の実験では、意図的な場面変更を含むカメラ経路を使い、単なる検索性能の向上と実際の修正能力を分けて評価する。訓練時より長い間隔を置いた再訪も試験に含める。
メモリには、情報が最初の観測、利用者の指示、生成内容のどれに由来するかを記録する。これにより、信頼性の低い可能性がある更新を見つけて拒否しやすくなる。進歩の判定には、総メモリ量と計算量をそろえた条件で、再訪時の誤りが減ることが必要である。同時に、新しい視点の品質を悪化させず、応答の遅れも過大にしないことが求められる。2年目には、長く保つべき場面の同一性と一時的な外観を分離し、カメラ入力や行動入力が関連部分だけを更新するか試す。
応用試験では、保護された場面の基準情報、許可された編集、以前の状態へ戻す機能を導入できる。これにより、正当な変化まで固定することなく誤りを修正できる。長時間の利用でフレーム当たりの修正回数が減るかが、重要な観測点となる。同じ場所で修正が繰り返されるなら、誤りが消えずに循環している可能性がある。
3年目には、修正用の仕組みを別の生成器や表現方式へ移し、より多様で高解像度の場面を試す。効果が移行後も続けば、範囲を限定した仮想移動や訓練シミュレーション向けに、再利用可能な場面状態部品を構築できる。ただし、生成フレームはシステム自身の誤りを繰り返すことがあるため、見かけ上の一致だけでは、保護された観測や既知の外部変更の代わりにならない。同じ条件で検索だけの方式が同等なら明示的な修正機構の必要性は薄れ、単純な配置でしか効果が出ないなら、用途は限定的な一貫性維持にとどまる。
このシナリオでは3年間で、メモリ容量の大きさではなく、実証された場面の連続性を実用上の合格条件にする。中心となる仕組みは、用途ごとの適格性評価である。管理された再訪試験を行い、計算量と応答時間を明示したうえで、連続性の得点が人による却下や修正作業を予測できるかを調べる。1年目には、コンパクトなメモリを、短い時間窓だけを使う生成方式や単純な参照フレーム条件付けと比較する。既知の場面を使い、訓練時より長い再訪間隔で評価する。
少人数の制作チームが人間の確認と並行して出力を採点するが、確認担当者を置き換えることはしない。合格した構成によって、未使用の場面集合でも却下や修正が必要な系列が減るかを検証する。結果が再現されれば、2年目には共通の不具合分類を通じて、合格判定を行うチームとモデル開発者を結び付ける。一部のカメラ経路は非公開にして、未知の条件への一般化も確かめる。開発者は、長時間画面外にあった物体の同一性が失われる問題など、繰り返し起きる失敗に合わせて検索方法や表現学習を改善できる。
高速化した生成にも同じ連続性試験を適用し、どのモデル構成が合格したかを版ごとの報告で明示する。改善がすべての構成にそのまま移るとはみなさない。対話的な試験運用は、生成処理全体の応答時間が要件を満たす場合にだけ進める。一方、オフラインで有用な作業は、対話速度の実現を待たずに進められる。
3年目の適用拡大には、高解像度化や再訪間隔の延長後も効果を保つことが必要になる。古い記憶が誤りになるような意図的な場面変更にも対応しなければならない。成功したシステムは範囲を限定したカメラ入力や行動入力を扱えるが、利用範囲は新しい試験で確認された場面と動作条件に限る。中心的な観測点は、再訪得点が実際の確認作業量を予測できるかであり、比較には生成処理全体の資源消費を含める。単純な参照条件付けで十分ならコンパクトなメモリを優先する必要はなく、高速化で連続性が損なわれるなら用途はオフラインにとどまる。適格性は試験済みの用途だけに適用され、制限のない現実的な世界や安全なロボット制御を保証せず、制御への転用には別の実験が必要である。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- LARP: Tokenizing Videos with a Learned Autoregressive Generative Prior - 著者: Hanyu Wang, Saksham Suri, Yixuan Ren, Hao Chen, Abhinav Shrivastava, / <See Details on Fugu-MT> / ライセンス: CC-BY-SA-4.0
- Long-Context State-Space Video World Models - 著者: Ryan Po, Yotam Nitzan, Richard Zhang, Berlin Chen, Tri Dao, Eli Shechtman, Gordon Wetzstein, Xun Huang, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- VideoMAR: Autoregressive Video Generatio with Continuous Tokens - 著者: Hu Yu, Biao Gong, Hangjie Yuan, DanDan Zheng, Weilong Chai, Jingdong Chen, Kecheng Zheng, Feng Zhao, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- PREM: Prefix-Steered Recurrent Memory for Long-Video Understanding - 著者: Siru Zhong, Qiongyan Wang, Xiaohui Lv, Yuzheng Zhuang, Shuai Tao, Wulong Liu, Haohuan Fu, Yuxuan Liang / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- WorldCrafter: Consistent Video World Model with Implicit 3D-aware Memory - 著者: Wangbo Yu, Kunhao Liu, Wenbo Hu, Shenghai Yuan, Chaoran Feng, Haiyang Zhou, Yukun Huang, Yiran Wang, Wang Zhao, Yingmin Luo, Ying Shan / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- MemBodied: Recurrent Associative Memory for Vision-Language-Action Models - 著者: Tej Deep Pala, Navonil Majumder, Bryce Goh, Raphael Yee, Jianfei Yang, Liming Chen, Soujanya Poria / <See Details on Fugu-MT> / ライセンス: CC BY-SA 4.0