サマリー
本テーマは、一様な処理に頼るのではなく、異種の視覚・言語入力に合わせて表現を適応させることを中心とする。今週の論文は、文字体系を考慮したシーンテキスト認識、ルーティングを用いた医用画像セグメンテーション、そしてコンパクトな言語ベースの永続的シーンマップを加えた。これらは、モダリティを考慮した医用画像処理、多言語テキスト検出、コードスイッチング音声翻訳に関する先行研究を土台としている。
テーマの状況
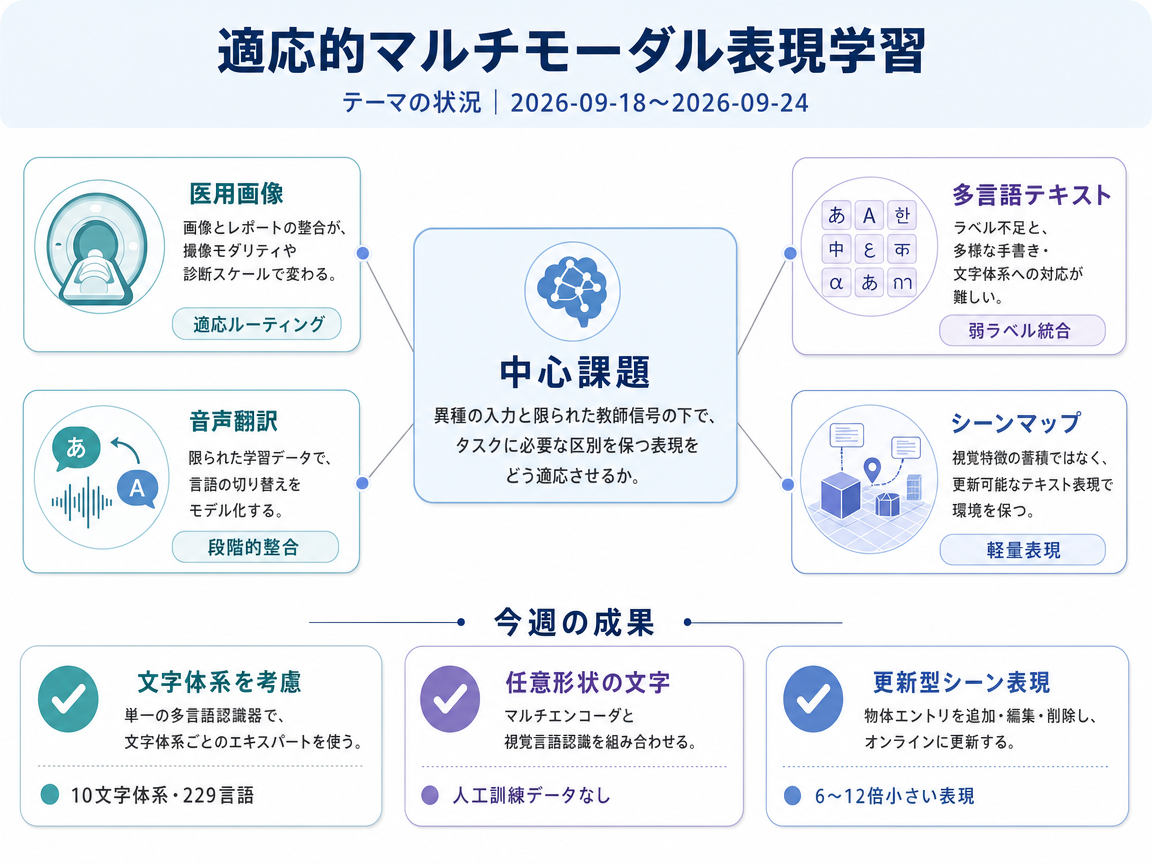
代表的な論文の序論は、共有表現に対するそれぞれ異なる障壁を記述している。医用画像では、画像とレポートの整合が撮像モダリティや診断スケールによって変わる。多言語文書テキスト検出は、ラベルの不足や多様な手書き・文字体系に直面している。コードスイッチング音声翻訳は、訓練データが限られる中で言語の切り替えをモデル化しなければならない。これに対し、MedMoEは局所的な視覚特徴を診断文脈エキスパートへルーティングする。TEXTRONは深層学習と画像処理による検出器から得た弱ラベルを組み合わせる。コードスイッチング研究は、言語特化型の音声プロジェクタと段階的な音声–テキスト整合を用いる。
今週の成果として、A Scene Language Model for Open-Vocabulary Scene Mapping(2609.21400v1)は異なる表現の選択を行っている。視覚埋め込みや特徴バンクを保持する代わりに、連続するRGB-D観測から構造化されたテキストの物体マップを更新する。6〜12倍小さいシーン表現で、競争力のある検索・位置特定性能を報告している。これらの研究に共通する問いは、入力が異種で教師信号が限られる場合に、表現が各タスクに必要な区別を保てるかどうかである。
- TEXTRON: Weakly Supervised Multilingual Text Detection through Data Programming
- MedMoE: Modality-Specialized Mixture of Experts for Medical Vision-Language Understanding
- Towards Fine-Grained Code-Switch Speech Translation with Semantic Space Alignment
- A Scene Language Model for Open-Vocabulary Scene Mapping
インフォグラフィクス(日本語)
今週の進展
All-in-One Multilingual Scene Text Recognition with Script-aware Mixture-of-Experts <See Details on Fugu-MT>
ScriptMoEは、単一の多言語シーンテキスト認識器において文字体系を考慮したエキスパートを用いる。 言語ごとの認識器や大規模VLMの代わりに、統一モデルと、10の文字体系・229言語を網羅する合成データセットTextMuSS-10Mを組み合わせる。
MEVL-STP: Multi-Encoder and Vision Language Model for Arbitrarily Shaped Scene Text Spotting <See Details on Fugu-MT>
MEVL-STPは、マルチエンコーダによるセグメンテーションと視覚言語認識を組み合わせ、任意形状のシーンテキストをスポッティングする。 文書テキスト検出からシーンテキストスポッティングへと対象を移し、人工的な訓練データなしでTotal-TextおよびICDAR 2015において高い性能を報告している。
A Scene Language Model for Open-Vocabulary Scene Mapping <See Details on Fugu-MT>
SceneLMは、観測の到着に応じてテキストの物体エントリを追加・編集・削除することで、オープン語彙のシーンマップを維持する。 保存された視覚特徴バンクを更新可能なテキスト表現で置き換え、四足ロボットでの実験によりエッジデバイス上でオンライン動作できることを示している。
Multimodal Routing and Region Refinement for Language-Guided Medical Image Segmentation <See Details on Fugu-MT>
MRSegは、言語誘導型の医用画像セグメンテーションにおいて、密な予測の前に視覚特徴と臨床テキスト特徴の適応をルーティングする。 凍結したConvNeXt-TinyとPubMedBERTエンコーダ、および約711万の学習可能パラメータで、ルーティングをセグメンテーションに適用している。
今後の展望
今後の展望(要約)
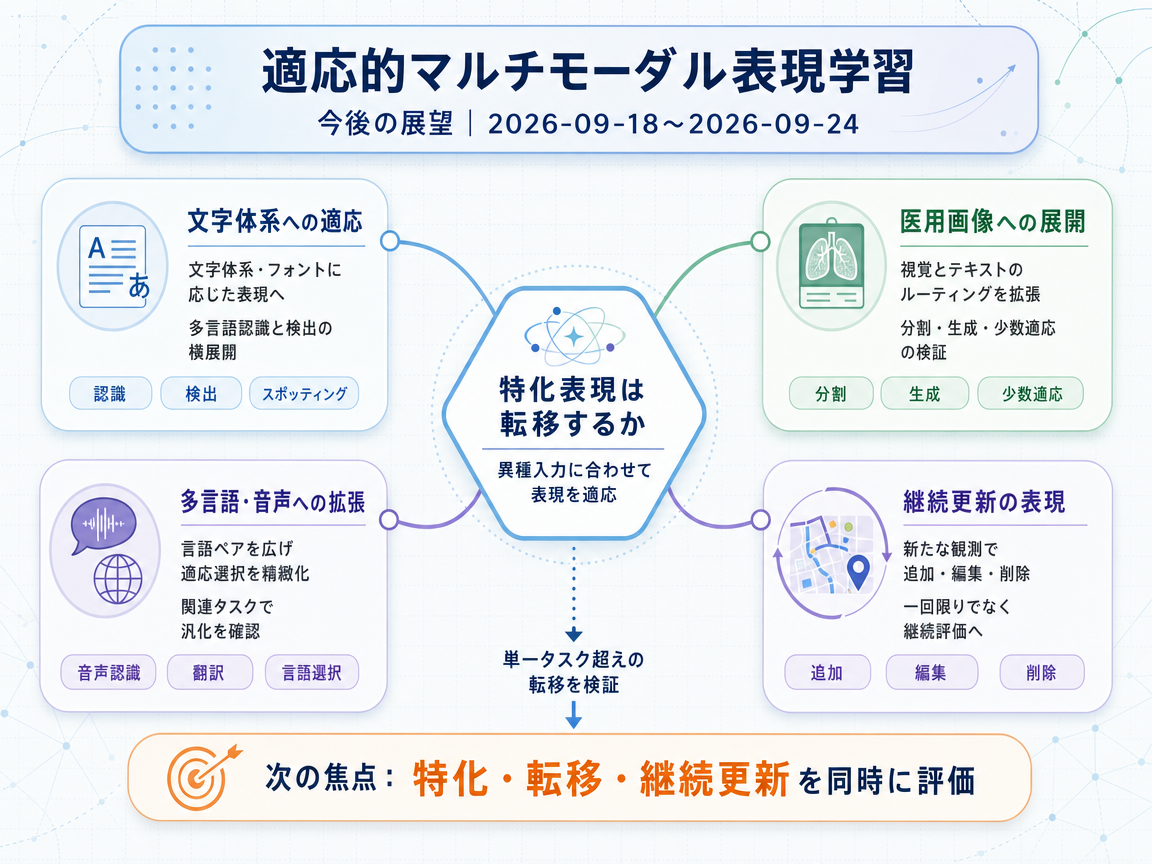
次の焦点は、特定用途向けの表現が元の課題を越えて機能するかどうかである。MedMoEは画像分割、レポート生成、少数例からの適応を提案している。一方、MRSegは別の経路選択型の分割例であり、転用可能性を直接証明するものではない。コードスイッチング研究は対応言語と関連課題の拡大を目指し、ScriptMoEは文字体系に応じた並列的な専門化を示している。TEXTRONは、より対象を絞ったラベル付けと、文書から自然な情景への対象拡大を示唆する。SceneLMでは、観測が変化して修正を繰り返しても、簡潔なテキスト地図が有用であり続けるかが新たな検証点となる。
インフォグラフィクス(日本語)
3年後を想定した動き
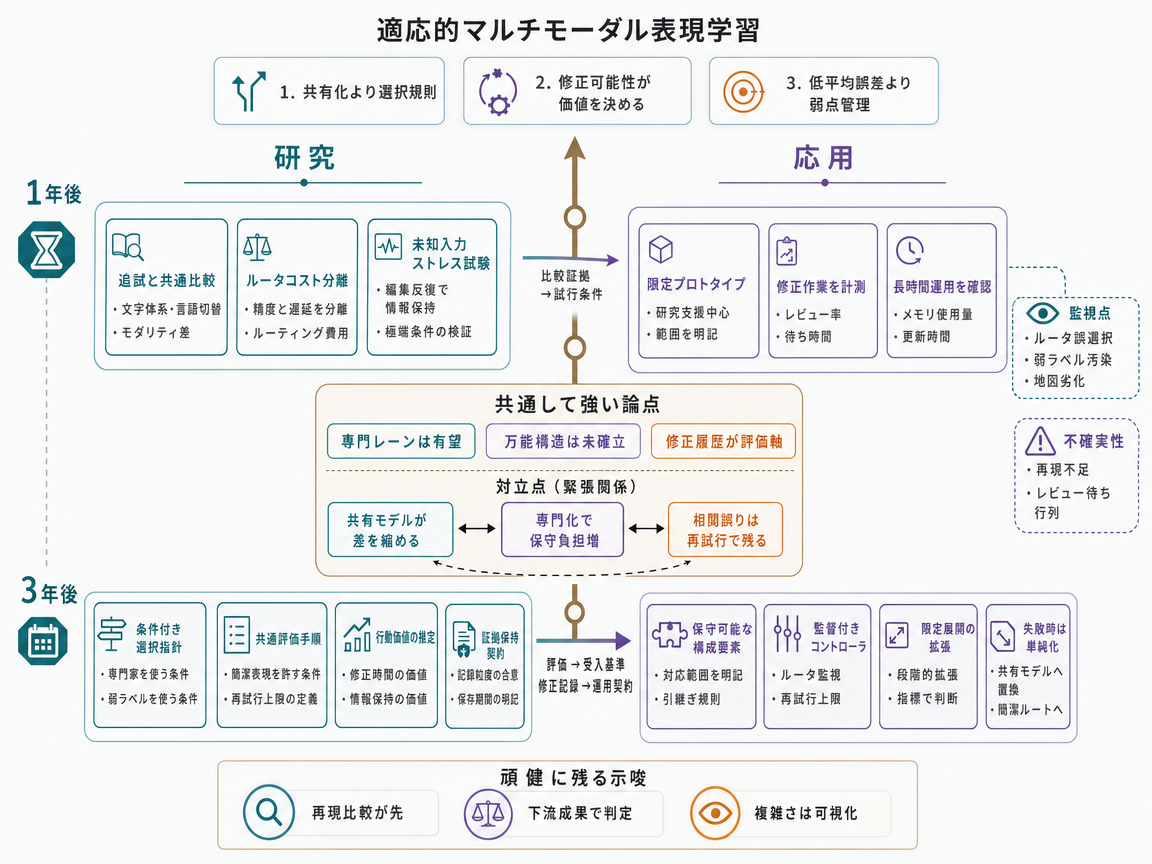
今後3年間でこの方向が進めば、現在の専門化手法は、追加の複雑さに見合う場面を判断するための実践的な指針になる。仕組みは複数の処理レーンに似ており、誤りの減少が追加計算や保守の負担を上回る場合にだけ、入力を専用処理へ送る。1年目には、研究者が既存結果を再現し、未知の条件でルーターを検証する。ルーターとは、入力をどの専門モデルに担当させるかを選ぶ構成要素である。管理された試作では、修正に必要な作業量と運用負担も測定する。地図課題では、簡潔な表現が最初の構築時だけでなく、変更の繰り返しにも耐えられるかを調べる。
2年目には、良好な比較結果を基に、同じ応用分野の中で手法を拡張する。ただし、ある課題で成功した手法が別の課題にも自動的に通用するとは想定しない。医療研究では画像分割とレポート生成を別々に検証でき、文書処理では弱教師あり学習を拡張できる。弱教師あり学習は、不完全なラベル付け規則を組み合わせ、手作業による注釈を減らす方法である。音声や地図の試験は対象範囲と実施期間を広げ、短期試験では見えない弱点を明らかにする。効果が再現されれば、新しいデータと検証が増え、利点を測定できる専門モデルだけが追加される循環が生まれる。
3年目には、全分野を一つの構成で覆うよりも、共通の試験手順と、範囲を限定した保守可能な部品が整う可能性が高い。各チームは課題固有の品質指標を保ちつつ、専門モデルへの経路選択と単純な共有モデルを比較できる。導入する部品には、対応範囲と障害時の復旧方法を明記する必要がある。関連研究が進歩しても、信頼性の低い機能を安易に広げるべきではない。
重要な観測指標は、長期運用でも再現可能な誤り削減が続き、専門モデルの保守負担を上回ることである。低コストな共有モデルが性能差を縮めれば、この方向の妥当性は弱まる。また、医療研究で良い結果が出ても、それだけで実際の医療利用に必要な準備が整ったことにはならない。
今後3年間でこの方向が進めば、専門モデルによる最初の回答よりも、追加処理で回答を有効に修正できる条件が重視される。仕組みはロボット工学の考え方に基づき、出力を暫定結果として扱う。その上で、コントローラーと呼ばれるソフトウェアの判断層が、追加処理に価値があるかを決める。1年目には、未知の入力と地図の反復編集を用い、不確実性だけでなく、実際に修正可能な誤りを記録する。進展と見なすには、同程度の計算資源の下で、少なくとも二つの課題群に独立した改善が必要になる。さらに、事前に定めた珍しい入力群の性能悪化や、見えにくい人手修正の増加があってはならない。
この基準を満たした場合、2年目には、利用可能な修正操作がどれほど役立つかを予測する研究へ進む。不確実な回答でも、再処理すれば必ず改善するとは限らないからである。管理された試験では、別の画像領域を取得したり、保存済みの音声を再確認したりできる。再試行回数には上限を設け、自動修正の信頼性が低い場合は人へ明確に引き継ぐ。修正履歴は操作の選択精度を高めるが、簡単だと判定された出力にも無作為監査が必要になる。
3年目には、専門モデルや品質指標が異なっていても、処理手順が共通のコントローラー接続方式を利用できるようになる可能性がある。運用規則では、回答を修正できる条件と確認を必須とする条件を定め、処理時間にも上限を設ける。専門モデルを交換した後も規則が機能するかを検証し、特定の構成への依存より安定した動作を優先する。保存方法も選択的になり、安定した結果では情報を減らし、曖昧な結果では後の修正に必要な根拠を残す。
重要な観測指標は、同じ資源上限の下で、修正後に残る誤りが減り、確認待ちと根拠保存の負担も管理可能であることだ。同じ入力の再処理では欠落情報を回復できず、複数の専門モデルが同じ誤りを繰り返す場合もあるため、外部確認を残す必要がある。資源条件をそろえると効果が消える場合や、改善が地図課題だけに限られる場合は、3年間の成果を実証済みの用途に絞るべきである。
今後3年間でこの方向が進めば、強い平均点よりも、苦手な入力区分での性能がシステムの導入判断を左右するようになる。仕組みは安全試験の評価に似ており、複数の区分で個別の最低基準を満たす必要がある。そのため、一般的な入力での高性能によって重大な対応範囲の不足を隠せない。1年目には、多言語デジタル化事業が、特定の文字体系による手書き入力など、定義済みの試験区分ごとに最低点を設定する。重要な引き金は、その最低点が実際の提供者選定に使われることである。これにより研究者は、難しい区分で専門モデルと共有モデルを比較する理由を得る。
2年目には、区分別の選定が継続し、医療レポートの取り組みも加わることで、独立評価者が運用する共通評価手順が整う可能性がある。提供者は、効果が確認できる場合に限り、入力を専門部品へ振り分けるモデルによって弱い区分を選択的に修復する。評価者は精度だけでなく、修復費用と処理遅延も測定する。区分の対応範囲が広がっても、それだけではシステムの複雑化を正当化できないからである。詳細な報告によって新たな弱点が見つかり、文書用途を中心に対象を絞った改善が進む。
3年目には、公開された評価例と異なる入力にも評価表が通用するなら、参加組織は区分別の最低基準を通常の手順にできる。非公開試験と複合入力によって、モデルが例を暗記するのではなく、本当の入力差を認識しているかを調べる。地図の反復修正は別の耐久試験になり、医療評価でも同様の報告方法を採用できる。ただし、技術的な点数だけで利用者への効果が証明されたとは扱わない。
最も強い観測指標は、区分別の最低基準に結び付いた選定記録があり、独立した試験能力と弱点修復の実測費用が示されることである。平均精度だけで選定する場合や、共有モデルが苦手区分をより低コストで改善する場合は、専門構成を採る根拠が弱まる。公開試験には合格しても複合入力で失敗するなら、共通の評価慣行を急いで定着させず、手順を改善するか、現場ごとの試験へ戻る必要がある。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- TEXTRON: Weakly Supervised Multilingual Text Detection through Data Programming - 著者: Dhruv Kudale, Badri Vishal Kasuba, Venkatapathy Subramanian, Parag Chaudhuri, Ganesh Ramakrishnan / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- MedMoE: Modality-Specialized Mixture of Experts for Medical Vision-Language Understanding - 著者: Shivang Chopra, Lingchao Mao, Gabriela Sanchez-Rodriguez, Andrew J Feola, Jing Li, Zsolt Kira, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Towards Fine-Grained Code-Switch Speech Translation with Semantic Space Alignment - 著者: Yan Gao, Yazheng Yang, Zhibin Lan, Yidong Chen, Min Zhang, Daimeng Wei, Hui Huang, Jinsong Su, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- A Scene Language Model for Open-Vocabulary Scene Mapping - 著者: Adam Lilja, Fabio Hübel, Siming He, Junsheng Fu, Claire Tomlin, Lars Hammarstrand, Jitendra Malik, Jonas Frey, Marco Pavone / <See Details on Fugu-MT> / ライセンス: CC BY 4.0