サマリー
本テーマは、遅いシーンごとの最適化をフィードフォワード型ガウシアン表現に置き換え、動画拡散の効率を向上させることで、視覚生成・再構成の実用性を高めることに焦点を当てている。代表的な論文は2つの課題を浮き彫りにしている:動的な3D/動画コンテンツにはコンパクトでストリーミング可能かつコンテンツ適応的な構造が必要であること、そして現代の動画生成モデルにはコストのかかる再学習なしに時間的・物理的一貫性の改善が求められていることである。今週の進展は、ワンパスのガウシアン予測、動画生成事前知識のより広範な再利用、および拡散実行の高速化への移行を裏付けている。
テーマの状況
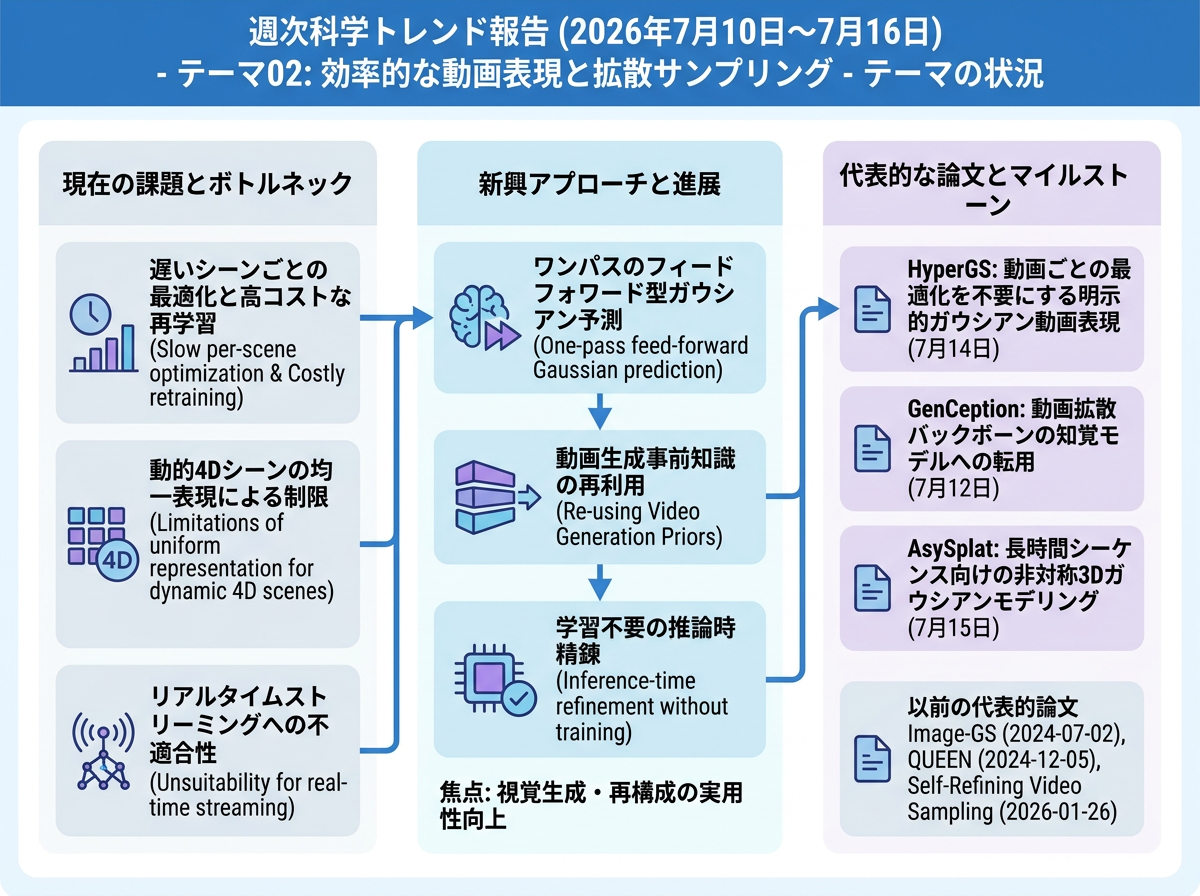
代表的な論文の導入部は、視覚モデリングにおける共通のボトルネックを提示している:実世界のシーンは連続的・動的でありしばしば本質的に3Dであるが、一般的な表現は均一なグリッドに基づくか、高コストなシーンごとの最適化を要する。自由視点映像において、動的NeRFやガウシアンベースの手法は4Dシーンを良好に再構成できるが、大部分がオフラインで学習が遅く、逐次更新・高速レンダリング・帯域制約が求められるリアルタイムストリーミングには不向きである。画像レベルでも、均一なピクセルグリッドや多くのニューラル画像表現は局所的なコンテンツの複雑さに応じたリソース配分への適応ができず、ストリーミングやリアルタイムグラフィクスの効率を制限している。
生成側では、拡散モデルやフローベースの動画モデルが強力な生成器となっているが、複雑な物理ダイナミクス、時間的一貫性、下流タスクでの信頼性にはまだ課題がある。既存の対処法は外部検証器によるリジェクションサンプリングや追加の事後学習に依存することが多く、いずれもコストが高いかドメイン固有である。これらの論文は総じて、適応的・明示的・効率的な視覚表現への移行と、大規模な再学習パイプラインではなく学習不要の推論時精錬による動画生成品質の向上という、より広い潮流を示している。
- Image-GS: Content-Adaptive Image Representation via 2D Gaussians
- QUEEN: QUantized Efficient ENcoding of Dynamic Gaussians for Streaming Free-viewpoint Videos
- Self-Refining Video Sampling
インフォグラフィクス(日本語)
今週の進展
HyperGS: Fast and Generalizable Gaussian Video Representation <See Details on Fugu-MT>
HyperGSは、任意のクリップから単一のフィードフォワードパスで明示的なガウシアン動画表現を予測し、動画ごとの最適化を不要にした。 標準ベンチマークにおいて従来の動画エンコーダに対しPSNRを+2.9〜3.1 dB改善し、シーンごとのガウシアンフィッティングよりも桁違いに高速なエンコードを実現した。
Video Generation Models are General-Purpose Vision Learners <See Details on Fugu-MT>
GenCeptionは、事前学習済み動画拡散バックボーンをフィードフォワード型知覚モデルとして転用し、多様な視覚タスクで競争力のある結果を達成した。 動画生成器を合成のみに使用するのではなく、学習された時空間事前知識が高いデータ効率で視覚理解に効果的に転移することを示した。
Instant NuRec: Feed-Forward 3D Gaussian Reconstruction for Driving Scene Simulation <See Details on Fugu-MT>
Instant NuRecは、短いマルチビュー走行ログを単一のフォワードパスで静的/動的レイヤー分離された3Dガウシアンシーンに変換し、クローズドループシミュレーションに対応した。 10〜20秒のマルチカメラシーンを約1.5秒で再構成し、シーンごとの最適化に対して計算量を3〜4桁削減しつつPSNRも改善した。
AsySplat: Efficient Asymmetric 3D Gaussian Splatting for Long-Sequence Scene Modeling <See Details on Fugu-MT>
AsySplatは、ジオメトリとアピアランスのモデリングを分離する非対称アーキテクチャを提案し、3Dガウシアンによる汎化可能な長時間シーケンスの新規視点合成を実現した。 長時間シーケンスにおいて最適化ベースの再構成品質に匹敵しつつ、約800倍高速な推論を達成した。
今後の展望
今後の展望(要約)
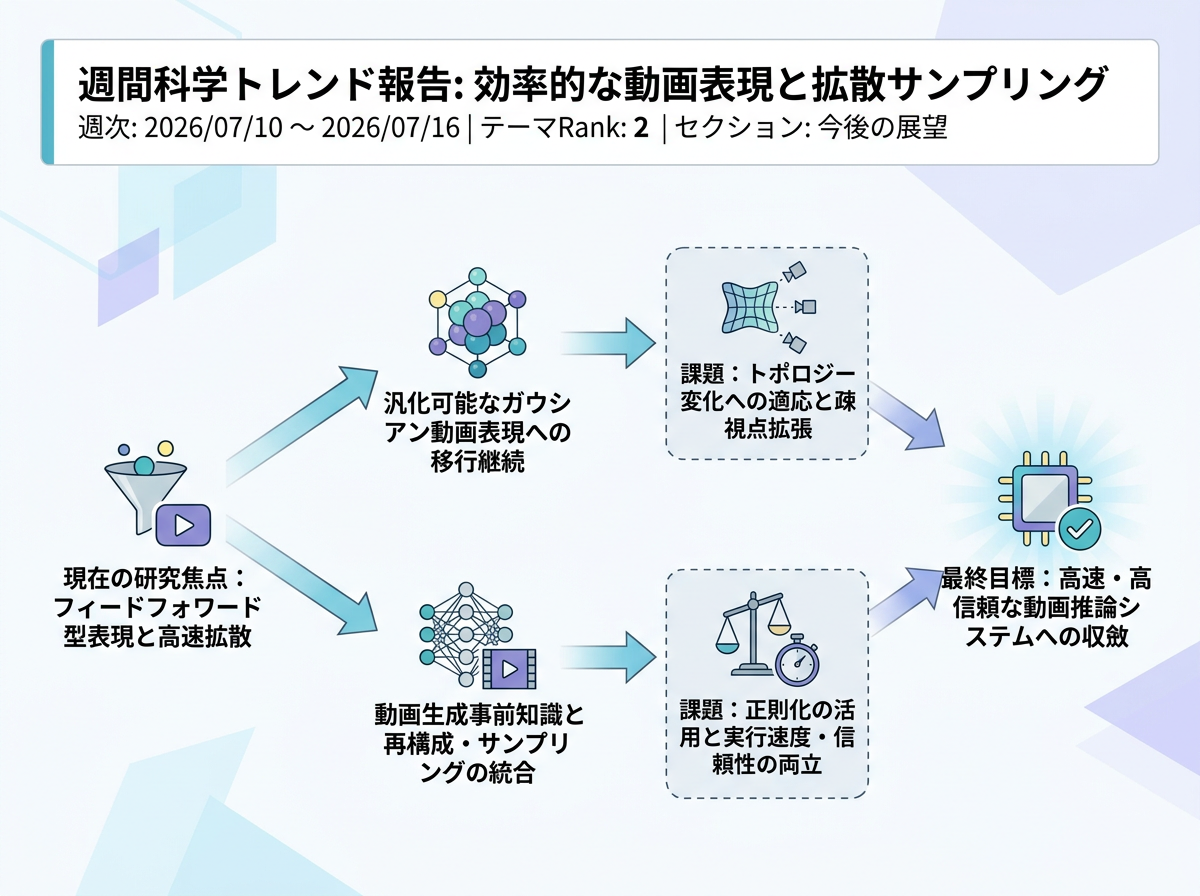
短期的には、場面ごとに時間をかけて最適化する方式から、映像のガウシアン表現を1回の処理で予測するフィードフォワード型へ移行するとみられる。今後は、より長い映像への対応を進めながら、キーフレームによるリセット、内容に応じたガウシアン配置、少数視点からの再構成を改善する研究が進む。もう一つの方向は、生成映像モデルの事前知識を効率的な再構成やサンプリングと結び付けることである。この事前知識は欠けたフレームや視点を補える可能性があるが、過剰な補正を防ぐため、処理を止める判断基準の強化が必要になる。ハードウェア特性を考慮した実行方式も、さまざまな利用環境で推論を高速かつ安定させるだろう。
インフォグラフィクス(日本語)
3年後を想定した動き
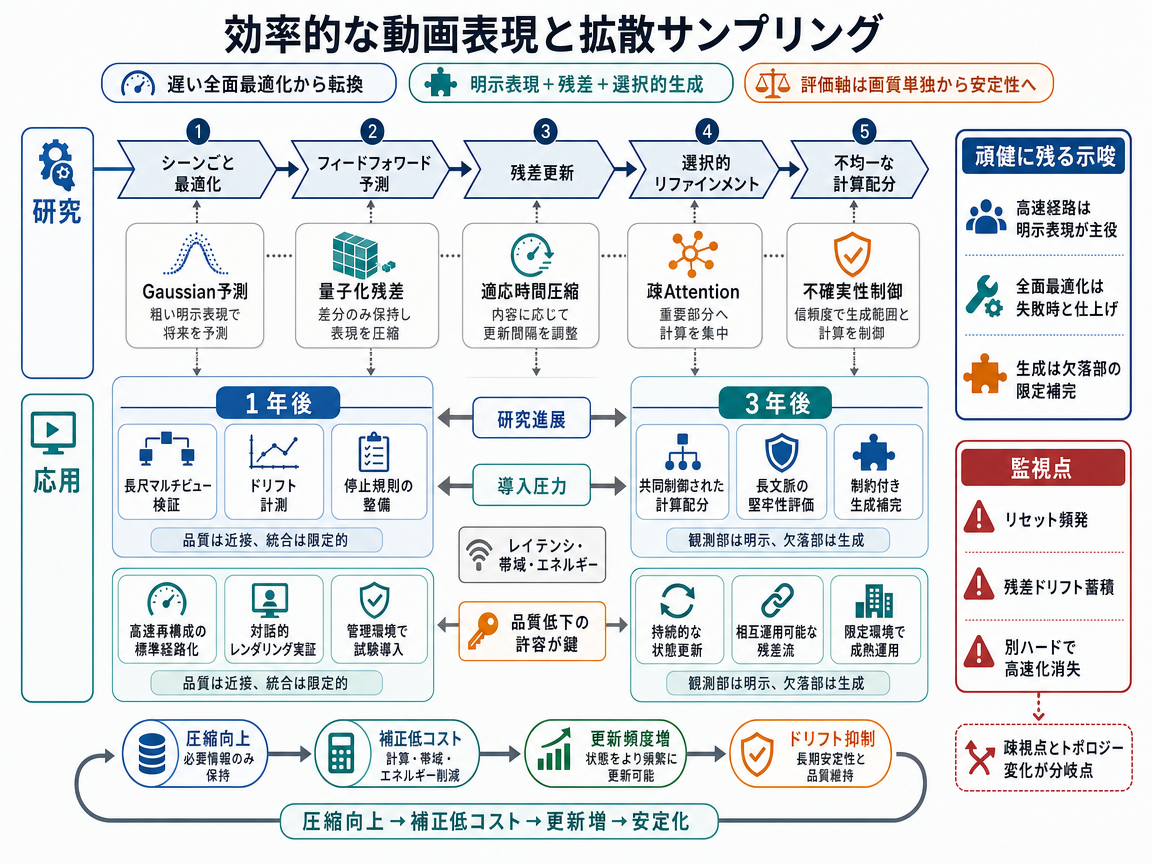
標準シナリオでは、映像の各場面で繰り返していた最適化の多くが、フィードフォワード型モデルに置き換わる。明示的なガウシアン表現が高速な基礎状態を作り、軽量な残差更新がフレーム間の変化を記録する。これは、まず高速に推定し、その後に小さな修正を加える仕組みに近い。動きや不確実性が大きい部分だけに、追加の計算を割り当てられる。初年度には、長い映像、適応的なキーフレーム、静的領域と動的領域の分離が検証される。準備時間やデータ量を大きく減らしつつ、遅い方式に近い画質を保てるかが成功の基準になる。
2年目には、より広い試験運用から、時間とともに生じるずれ、急な場面変化、リセット判断の記録が得られる。それらの記録により、ガウシアンの配置方法や新しいキーフレームが必要になる条件を改善できる。生成映像モデルの事前知識は、限られた欠測の復元にも使われるが、幾何学的な検査によって制約される。したがって、完全な多視点撮影から不完全な撮影条件へ段階的に進み、すぐに制約のない単一視点再構成へ到達するわけではない。重要な観測点は、長時間の映像を扱う共通ベンチマークと、難しい変化の後の回復を測る残差形式の登場である。
3年目ごろには、安定したシステムが処理全体で計算量を一様ではなく配分するようになる。場面の複雑さと確信度に応じて、表現密度、時間方向の圧縮率、補正の強さを変える。評価では、個々のフレームだけでなく、長期安定性、トポロジー変化、不完全な視点からの回復が重視される。主な注意点は、生成された細部が自然に見えても、幾何学的には誤っている可能性があることだ。全面的なリセットの多発、残差のずれの蓄積、ハードウェア変更による効率向上の消失が続けば、このシナリオは弱まる。これらの問題が減れば、観測済み部分は高速な明示的予測で処理し、変化は残差で表し、小さな欠測だけを生成的補正で埋める分業が定着する。
対抗シナリオでは、明示的な映像表現と、持続的な予測・修正ループを組み合わせる。ガウシアン表現や連続場が現在の場面を保持し、学習済みの映像モデルが変化を予測した後、少数の観測データで修正する。この仕組みは、気象予報で予測結果を新しい観測値によって定期的に調整するデータ同化に似ている。初年度には、不確実性に応じた更新と短い修正区間が検証される。判断基準は、一つの処理だけの高速化ではなく、同等の持続的な再現品質を保ちながら、システム全体の遅延や計算量を減らせるかである。
初期の応用は、予測の信頼性が低下した時点を判断しやすい管理された環境に限られる。計測可能な遠隔臨場システム、シミュレーション、範囲を限定したロボット環境が主な試験対象になる。最初に場面の状態を送り、その後は小さな残差だけを更新し、観測が欠けた場合に限って学習済みモデルを使う方式が考えられる。確信度のしきい値と予測可能時間の上限を設け、ずれが大きくなる前にキーフレーム更新や全面リセットを行う。2年目には、予測だけの状態と観測で修正した状態を分け、局所更新の条件を明確にする。
3年目ごろには、これは状態推定型の映像エンジンという独立した技術群になり得る。中心的な指標は同化可能な時間幅であり、センサーによる修正や強制リセットなしで場面をどれだけ進められるかを示す。特に出力が後続の自動処理に使われる場合、直接観測した形状と推定した部分を記録する必要がある。重要な観測点は、遮蔽中も状態を維持できるかを測り、通信量と遅延も報告する新しいベンチマークの登場である。修正が軽くなれば更新頻度を上げられ、頻繁な更新がずれを抑えるため、保持した状態を長く利用できる。最大の注意点は、学習済み映像モデルには物理方程式ほど強い制約がなく、自然に見える誤った形状を作り得ることだ。ほぼ完全な観測が依然として必要な場合や、急なトポロジー変化で単純な推定器の方が優れる場合は、このシナリオの根拠が弱まる。
可能性シナリオが成立するには、効率が論文上の成果にとどまらず、繰り返し確認されるシステム要件になる必要がある。フィードフォワード型のガウシアン再構成、圧縮された場面更新、拡散モデルの高速実行は、すでに測定可能な改善を示している。共通の試験サイクルでは、エネルギー使用量、通信量、出力品質を管理された条件で評価する。組織はその結果を試験導入の選定に使い、初年度にはハードウェア条件と出力品質を含む処理全体の負荷を報告する必要がある。
試験運用では、都合のよい短い映像だけでなく、長い映像や急な場面変化を扱う。低精度演算と疎な計算が、異なるアクセラレーターでも効果を保つかも調べる。初年度の重要な条件は、資源量の上限と品質の下限を数値で示した大規模な運用要件が現れることである。これが実現すれば、反復試験によって開発目標を共通の測定値へ近づけられる。2年目には、共通のガウシアン残差仕様と実用的なエネルギー試験が、実装間の相互運用性を支える可能性がある。研究の焦点は、非公開の試験内容によって明らかになるずれ、トポロジー変化、少数視点撮影の弱点へ移る。
3年目ごろには、システムが計算量を意図的に不均等配分するようになる。簡単なフレームでは表現量を抑え、難しい動きには不確実性に応じて計算を増やす。生成モデルの事前知識は限られた欠測を補えるが、品質検査と生成経路の記録によって、根拠のない細部を制限する必要がある。重要な観測点は、更新履歴のある試験群が非公開映像を定期的に入れ替え、最低品質を求めるようになることであり、試験だけを見分けて処理を軽くする行為も防げる。主な注意点は、ハードウェアが変化する中で、資源効率と視覚品質を一つの指標だけで一貫して評価するのが難しいことだ。共通仕様に相互運用性がなく、運用要件に数値上限がなく、別の試験結果を比較できなければ、このシナリオは弱まる。試験サイクルが最新かつ比較可能に保たれれば、36カ月後には予測可能なフィードフォワード処理がリアルタイム利用の中心となり、遅い場面別最適化は主にオフラインの比較基準として残る。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- Image-GS: Content-Adaptive Image Representation via 2D Gaussians - 著者: Yunxiang Zhang, Alexandr Kuznetsov, Akshay Jindal, Kenneth Chen, Anton Sochenov, Anton Kaplanyan, Qi Sun, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- QUEEN: QUantized Efficient ENcoding of Dynamic Gaussians for Streaming Free-viewpoint Videos - 著者: Sharath Girish, Tianye Li, Amrita Mazumdar, Abhinav Shrivastava, David Luebke, Shalini De Mello, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Self-Refining Video Sampling - 著者: Sangwon Jang, Taekyung Ki, Jaehyeong Jo, Saining Xie, Jaehong Yoon, Sung Ju Hwang, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0