サマリー
このテーマは、狭いベンチマークや最終出力指標を超えた、AIコーディングアシスタントおよびソフトウェア工学エージェントの評価に焦点を当てている。代表的な論文は、実環境でのデプロイ実績、エージェント障害のプロセスレベル分析、バグ修正・テスト生成・コードレビュー対応・スタイル適用といったタスクを網羅するより広範なベンチマークの重要性を強調している。
テーマの状況
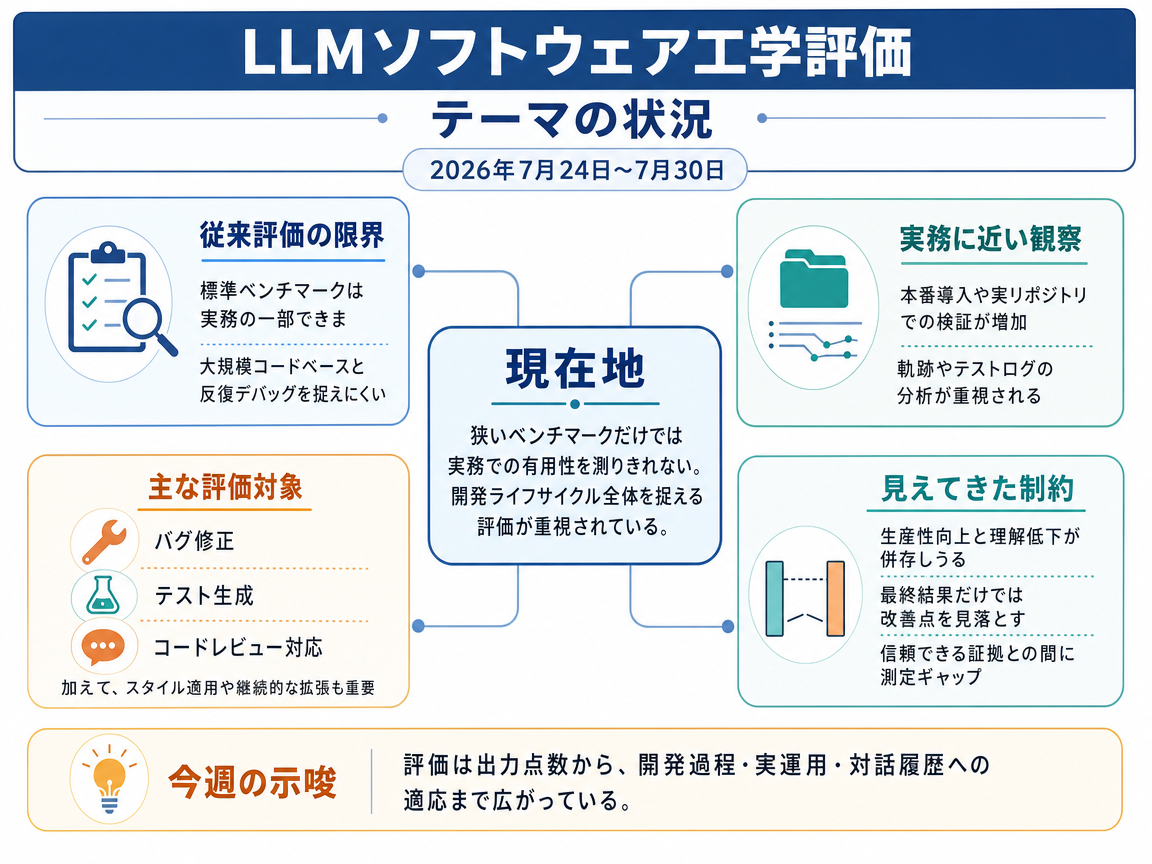
AIコーディングツールはソフトウェア開発全体に急速に普及しているが、HumanEval、MBPP、SWE-Benchなどの標準的な評価は実際の工学実務の一部しか捉えていない。日常の開発は大規模で進化し続けるコードベース、チームの慣習、ツールチェーン統合、反復的なデバッグを伴うため、ベンチマークでの成功が本番環境での有用性を直接保証するわけではない。
こうした背景の中、代表的な論文はより豊かな評価の視点を求めている。本番組織へのデプロイに関する大規模フィールドスタディ、最終パッチだけでなくエージェントの軌跡やテストログの分析、リポジトリレベルのより広範なタスクをカバーするベンチマークなどである。これらは総じて、LLMシステムがソフトウェア開発ライフサイクル全体で実際にどう機能するかについて、印象的なモデル能力と信頼に足るエビデンスとの間に測定ギャップが存在するという現状を描いている。
- Unveiling Pitfalls: Understanding Why AI-driven Code Agents Fail at GitHub Issue Resolution
- OmniCode: A Benchmark for Evaluating Software Engineering Agents
インフォグラフィクス(日本語)
今週の進展
(Im)Paired Programming: Coding Agents Improve Productivity but Harm Understanding <See Details on Fugu-MT>
制御されたユーザースタディにより、即時のタスク完了だけでなく、後続のコード拡張・理解タスクにおいてもコーディングエージェントを評価している。 ベンチマーク中心の評価とは異なり、生産性の向上がユーザーの理解度低下と共存し得ることを明らかにし、標準的な指標が見逃すギャップを浮き彫りにしている。
Do Context Files Help Coding Agents? A Two-Agent Ablation Study on Real Repositories <See Details on Fugu-MT>
制御されたアブレーション実験により、永続的なコンテキストファイルがコーディングエージェントの実リポジトリでの問題解決に実際に役立つかを検証している。 最終的なベンチマークスコアだけで判断するのではなく、2つの最先端エージェントにおける特定の広く使われているワークフロー慣行を評価している。
Learning from 53.6K Real-World Developer Edits of AI-Generated Code <See Details on Fugu-MT>
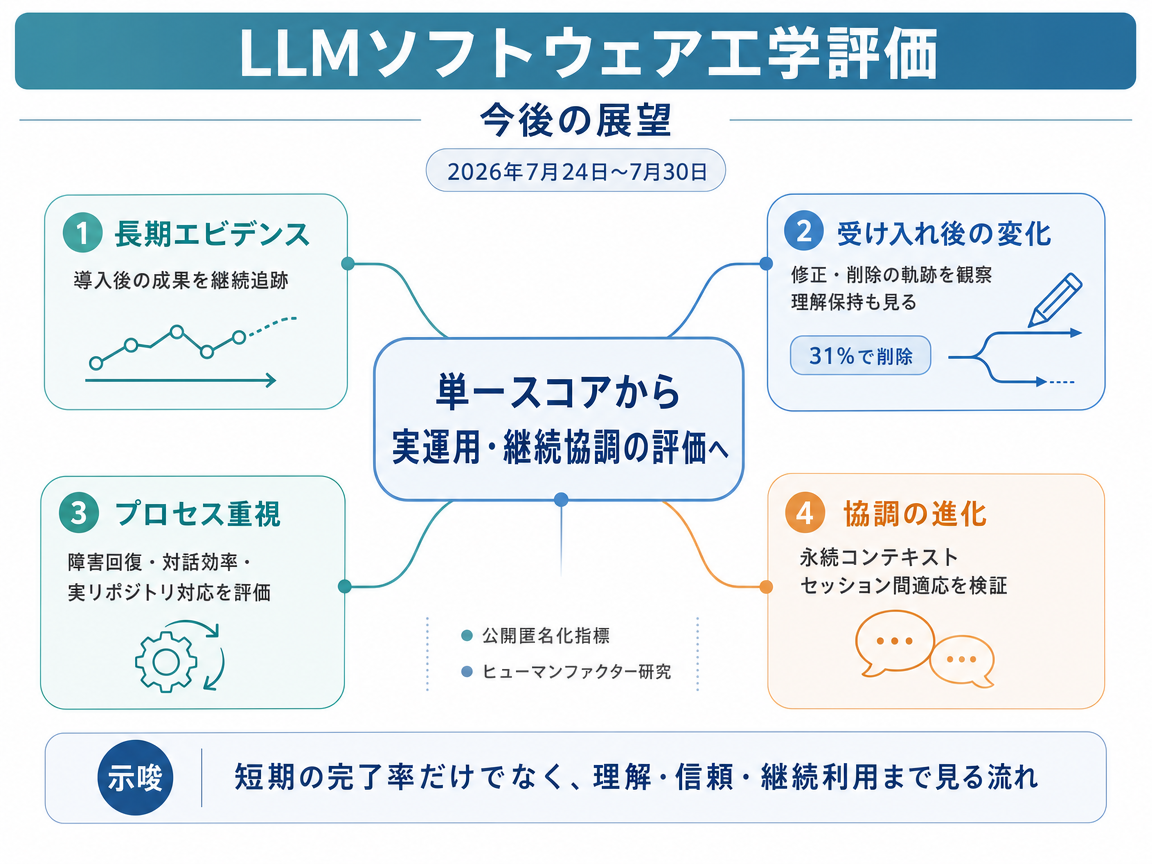
53,600件の実環境IDE編集データセットにより、開発者がAI生成コードを受け入れた後にどのように修正するかを追跡している。 最終出力に焦点を当てた評価と比較して、ほとんどの編集が受け入れ後15分以内に行われ、軌跡の31%でAI補完が削除されることを明らかにしている。
Fewer Clarifications, Better Code: Benchmarking Cross-Session Personalized Ambiguity Adaptation in Coding Assistants <See Details on Fugu-MT>
新しいベンチマークにより、セッション間のパーソナライズされた曖昧性処理についてコーディングアシスタントを評価し、タスク成功率と対話効率を測定している。 標準的なコーディングベンチマークとは異なり、モデルがユーザーの履歴に適応し、タスクを完了しつつ確認ターン数を削減できるかを検証している。
今後の展望
今後の展望(要約)
LLMによるソフトウェア開発の評価は、複数の組織でコーディングエージェントを長期間追跡する方向に進むと考えられる。研究では、タスクを完了できたかだけでなく、生成コードが導入後も使われ続けるか、開発者が内容を理解しているか、経験によって利用方法がどう変わるかを調べる。評価はリポジトリごとの作業手順やタスクの違いも重視するようになる。最終的な単一スコアに頼らず、継続的な文脈保持、セッションをまたぐ適応、効率的な対話などを測り、反復作業における失敗からの回復や利用者との協働も検証する。
インフォグラフィクス(日本語)
3年後を想定した動き
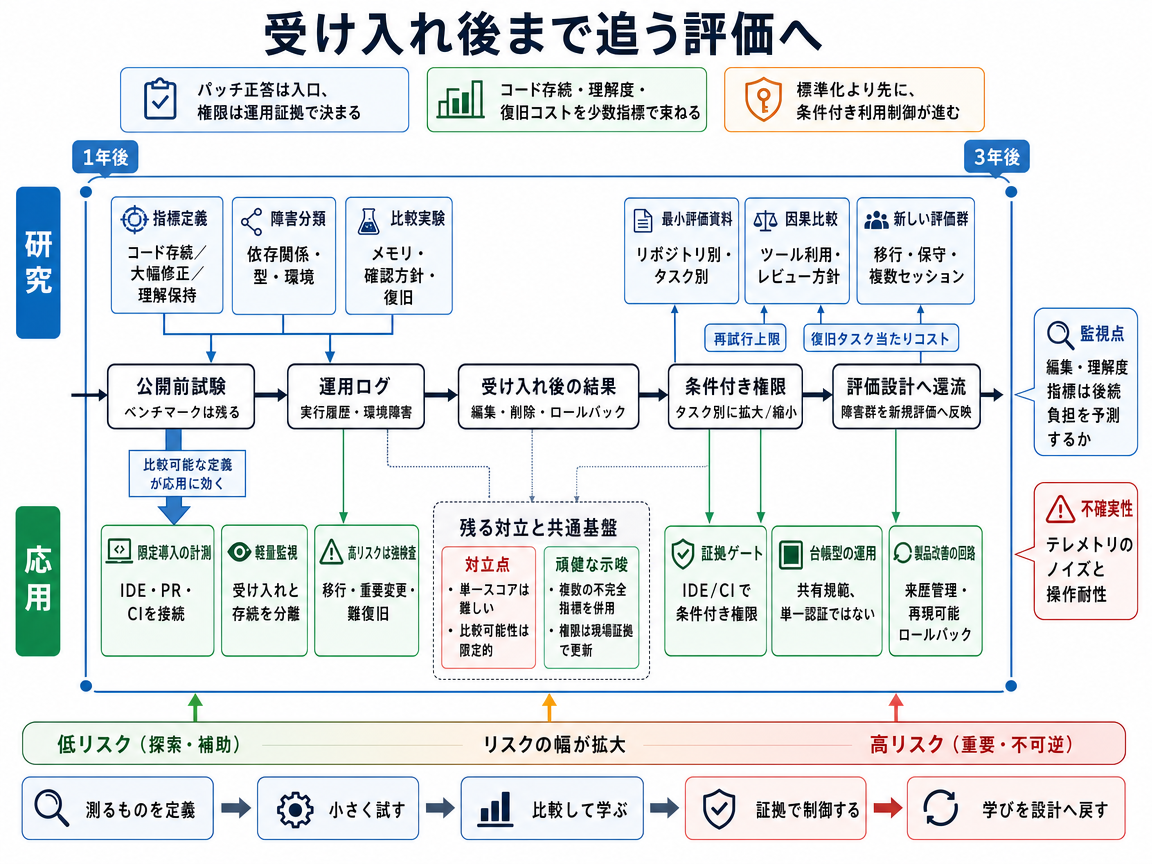
評価は、パッチが正常に作成された時点で終わらず、実際のリポジトリ作業を通じてコーディングエージェントを追跡する方向に進むと予想される。このシナリオは、医薬品の安全性監視に似た仕組みを採用する。ベンチマークで初期能力を確認し、導入後の修正、機能後退、理解の喪失から警告信号を見つける。ベンチマークは引き続き重要だが、長期的な問題が判明すれば評価は引き下げられる。
1年目には、コードが残る割合、大幅な書き直し、開発者の理解維持を測る方法が定められる。公開サンドボックスでは作業工程の一部を切り分け、文脈管理、記憶機能、回復処理を個別に試験する。複数組織の研究は、言語やリポジトリが異なっても指標が有効かを確認し、開発者の経験差も検討する。組織は限定的な試行を行い、最初に受け入れられたことと長く使えることを区別し、影響の大きい変更には長期観察と厳格なレビューを適用する。
2年目には、再現可能な指標が、組織間で利用できる簡潔な評価資料にまとめられる可能性がある。結果は一つの総合点に統合せず、タスクとリポジトリごとに分けて示される。研究者は記憶、確認質問、失敗回復の方針を比較し、理解を損なわずに作業を速める組み合わせを探る。組織は地域的な運用結果に応じて条件付き権限を与え、コードの継続利用と回復の成績が良ければ役割を広げ、手戻りが多ければ狭める。
3年目までには、実際のリポジトリから得た証拠が、新しい評価と製品側の制御へ直接反映される。繰り返される失敗は再現可能な試験事例になり、再試行回数を制限する指標によって、無制限のデバッグで信頼性を高く見せることを防ぐ。ツールには来歴記録、変更の取り消し、タスク段階別の制御が追加され、エージェントの活動範囲が調整される可能性がある。導入後の結果と標準化された工程ログを含むベンチマーク報告が監視の手掛かりになるが、指標が将来の不具合や保守負担を予測できない場合、この動きは弱まる。安全に比較可能なデータを共有できない場合も進展は難しく、リポジトリの差と開発者による継続的な編集を踏まえ、タスクの分類と事前に定めた観察期間が重要になる。
コーディングエージェントの評価は、狭いベンチマークから、実際のソフトウェア開発工程で集める証拠へ移りつつある。このシナリオでは段階的な検査を行い、すべてのAI支援変更には低コストの確認を適用し、影響が大きい変更には強力な試験や人間のレビューを加える。その背景には、受け入れられたコードが短期間で修正または削除される可能性があり、完了が速くても理解が弱まる場合があるという証拠がある。
1年目には、研究者がベンチマーク結果を開発環境の操作記録、変更提案の履歴、自動テスト結果と結び付ける。組織はAI支援による変更に信頼できる来歴情報を付け、最初の受け入れと後の手戻りを別々に測る。定型的な変更は統計的に監視し、安全性に関わるコードや大規模な構造変更には、より厳しい検査を行う。重要な分岐点は、現場の証拠が十分に信頼でき、エージェントの順位やリポジトリ内の権限を変更できる段階に達するかどうかである。
2年目には、共通のイベント定義により、ソースコードや開発者の完全な操作履歴を公開せずに結果を比較しやすくなる。記録は文脈の利用と回復行動を示し、より広い成果指標は後の修正やレビュー負担を捉える。現場の失敗もベンチマークに反映され、何度も試して合格するだけでなく、問題を認識して効率よく回復できるかが試される。組織の承認手続きでは、公開ベンチマークに加えて、タスク固有の証拠が求められるようになる可能性がある。
3年目までには、評価そのものが作業工程を制御する仕組みとして機能し得る。影響の小さい変更は自動検査と統計的監視を通過させ、影響の大きい変更には再実行、追加試験、人間の承認を求める。記憶機能とツール利用は、基盤モデルが同じでも手戻りや回復結果を変えるため、エージェント構成全体の一部として評価される。最終的には、ベンチマーク、工程記録、導入後の結果を組み合わせたリポジトリ別の評価表が使われ、単一の万能スコアへの依存は弱まるだろう。社内試験と公開順位でエージェントの順序が異なる事例は重要な監視材料になるが、記録データが不正確または過度に侵襲的なら、この動きは弱まる。リポジトリ間の差が大きく、理解の喪失も直接測りにくいため、複数の不完全な指標を組み合わせて解釈する必要がある。
評価は、ベンチマーク結果に工程記録、実運用後の成果、開発者の理解度を組み合わせる可能性がある。このシナリオも、医薬品の安全性監視に似た証拠の積み上げ方を採用する。統制された試験で初期能力を確認し、導入前には十分に推定できなかった問題を実利用から見つける。そのため、受け入れ後の修正や機能拡張は、評価の外にある活動ではなく、新たな証拠として扱われる。
1年目には、こうした出来事を一貫して測定し、通常のソフトウェア編集と区別できるかが試される。追試ではリポジトリ、言語、タスク種別を比較し、個人情報を保護した来歴記録によって、採用された提案と後の変更を結び付ける。研究は書き直しの時期、テストの機能後退、回復行動が、完成時の正確さより保守負担をよく予測するかを調べる。組織は限定されたリポジトリに計測機能を導入し、イベント記録と保存期間を定め、来歴情報の信頼度も管理する。主要な利用組織が互換性のある証拠を求め、継続利用やリポジトリ権限を成果基準に結び付けた場合に、実用化の条件が整う。
2年目には、匿名化されたイベント統計から、組織をまたぐ基準値を作れる可能性がある。現場で繰り返された失敗は再現可能なサンドボックス課題となり、早期の警告信号が後の不具合や機能拡張の負担を予測できるかが試される。権限も細分化され、あるリポジトリでは日常的な変更を許可し、別の影響の大きいタスクには強いレビューを求める運用が考えられる。したがって承認はモデル名だけではなく、エージェントと作業工程を合わせた構成全体に対して与えられる。
3年目までには、予測能力が確認された指標を使い、監査可能なタスク区分、不確実性の推定、定期的な再評価を実施できるようになる。開発ツールや自動統合システムは、この証拠に基づいて、エージェントが作業できる範囲と必要な制御を決める可能性がある。この評価層はベンチマークの広さ、回復行動、導入後の結果を組み合わせ、万能な単一スコアは作らない。互換性のある記録出力がツール評価や継続利用の条件になれば、重要な監視材料となる。一方、大規模な追試で受け入れ後の指標が保守負担や工程全体の費用を予測できなければ、このシナリオの可能性は下がる。個人情報の審査で変更との対応付けが認められない場合や、計測が数値合わせを促す場合も進展は止まり得る。ソフトウェア変更は元に戻せることが多く、開発者も編集を続けるため、因果関係の判断には医薬品の安全性監視以上の不確実性が残る。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- Unveiling Pitfalls: Understanding Why AI-driven Code Agents Fail at GitHub Issue Resolution - 著者: Zhi Chen, Wei Ma, Lingxiao Jiang, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- OmniCode: A Benchmark for Evaluating Software Engineering Agents - 著者: Atharv Sonwane, Eng-Shen Tu, Wei-Chung Lu, Claas Beger, Carter Larsen, Debjit Dhar, Rachel Chen, Ronit Pattanayak, Tuan Anh Dang, Guohao Chen, Gloria Geng, Kevin Ellis, Saikat Dutta, / <See Details on Fugu-MT> / ライセンス: CC-BY-SA-4.0