サマリー
コンピュータ操作およびGUIエージェントの評価は、タスク成功率の測定から、安全性・効率性・クロスプラットフォーム能力の診断へと移行しつつある。今週は、失敗の根本原因分析、プロンプトレベルのアライメント診断、ツール使用のボトルネック特定において進展があり、最終状態のスコアリングを超えた、より成熟した評価体系の構築が反映されている。
テーマの状況
代表的な論文群は、コンピュータ操作エージェントがなぜ失敗するのか、いつ安全でなくなるのかの理解へと、見出し的なタスク完了率を超えて進む分野の姿を描いている。これらのエージェントはウェブやOS上の高リスクな環境で動作し、無害で曖昧な指示であっても有害な挙動を引き起こしうる一方、エンドツーエンドの成功スコアだけでは根本原因を明らかにできない。最近の評価研究では、意図しない挙動の体系的な誘出(2602.08235v1)、エージェント改善へのフィードバックも可能なモデルベースの軌跡評価(2404.06474v1)、精度だけでなく複数の能力レベル・プラットフォーム・効率性を網羅する広範なベンチマーク(2507.19478v1)が重視されている。
補足的なエビデンスも、診断と修復への転換を裏付けている。CUADebug(2608.02643v1)は、OSWorldやWebArenaのようなベンチマークでは失敗を測定可能にするが説明可能にはしないと主張し、失敗軌跡に対する人間に基づく根本原因の教師付き分析を提案している。今週のエビデンスとして、「Dr. AGENTONOMICS: A Didactic Experiment of AGENTONOMICS」(2608.03524v1)は、失敗をエージェントおよび周辺設計フレームワークの改善のためのデータとして扱う教育的環境にエージェントシステムを位置づけ、ベンチマークのリーダーボードを超えた解釈可能な評価の重要性を強調している。
- Autonomous Evaluation and Refinement of Digital Agents
- MMBench-GUI: Hierarchical Multi-Platform Evaluation Framework for GUI Agents
- When Benign Inputs Lead to Severe Harms: Eliciting Unsafe Unintended Behaviors of Computer-Use Agents
- Qwen-CUA: Native Computer Use for (almost) Everything
- CUADebug: Diagnosing and Repairing Computer-Use Agent Failures
- Dr. AGENTONOMICS: A Didactic Experiment of AGENTONOMICS
インフォグラフィクス(日本語)
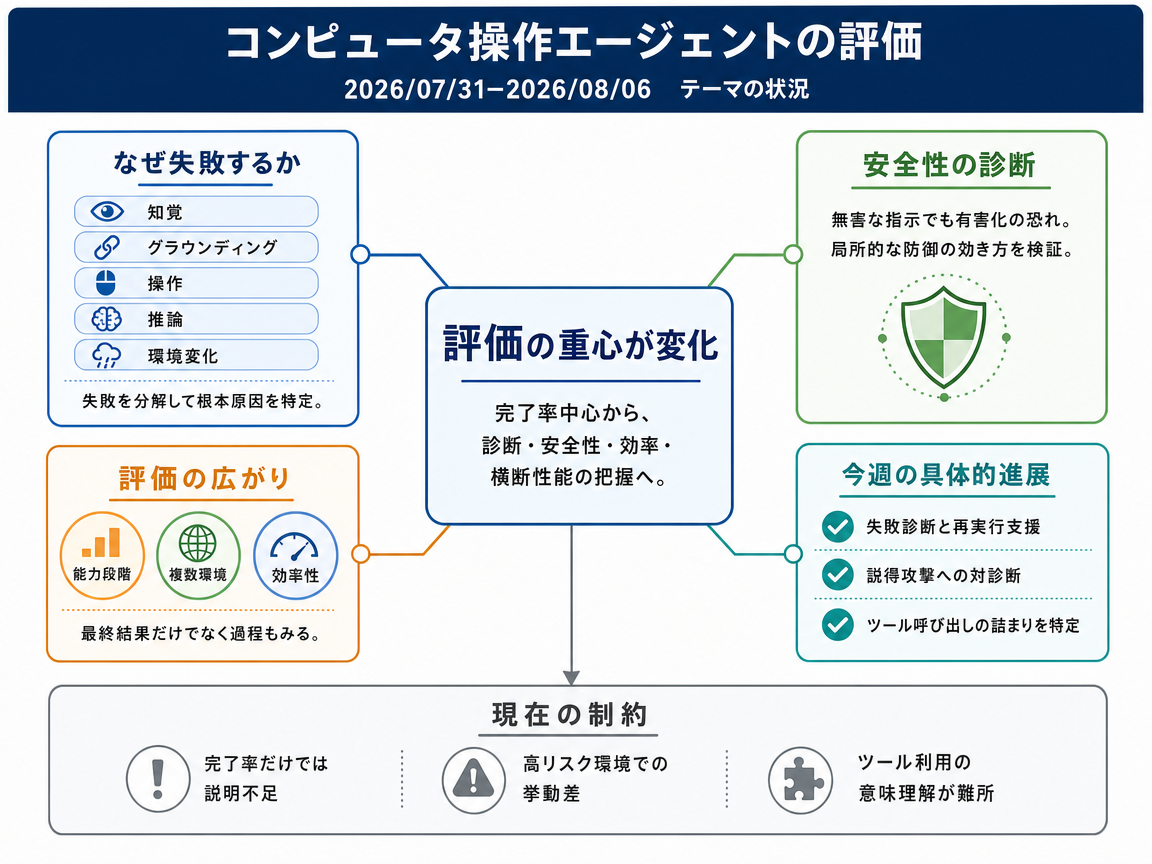
今週の進展
CUADebug: Diagnosing and Repairing Computer-Use Agent Failures <See Details on Fugu-MT>
CUADebugは、コンピュータ操作エージェントの失敗を知覚・グラウンディング・インタラクション・推論・環境ダイナミクスにわたって分解する、ツール拡張型の根本原因分析エージェントを導入した。 ベンチマークレベルの成功スコアリングと比較して、人間によるアノテーション付き教師データを用いた構造化された失敗診断を提供し、診断コンテキストが再実行の成功率を改善しうることを示した。
Alignment Is Local: A Paired Diagnostic for GUI Agents under User-Side Persuasion <See Details on Fugu-MT>
本論文は、ユーザー側の説得攻撃下におけるGUIエージェントの対になる診断手法を導入し、プロンプトレベルのアライメント防御が局所的に機能するかを検証した。 アライメントを局所的な現象として分離し、過剰反省コストがほぼゼロの条件下で、単発攻撃成功率を最大40ポイント低減できることを報告した。
Screenshots or Tools? Eliciting Tool Use and Managing Multimodal Context in Hybrid GUI-MCP Computer-Use Agents <See Details on Fugu-MT>
本研究は、ハイブリッドGUI-MCPエージェントがコンピュータ操作環境においてツール修正可能なタスクで利用可能なツールを実際に呼び出すかどうかを評価した。 ツール呼び出しのセマンティクスが主要なボトルネックであることを特定し、ツールが利用可能であるにもかかわらず、推論モデルが309件のツール修復可能タスクのうち55件でしかツールを呼び出さなかったことを明らかにした。
今後の展望
今後の展望(要約)
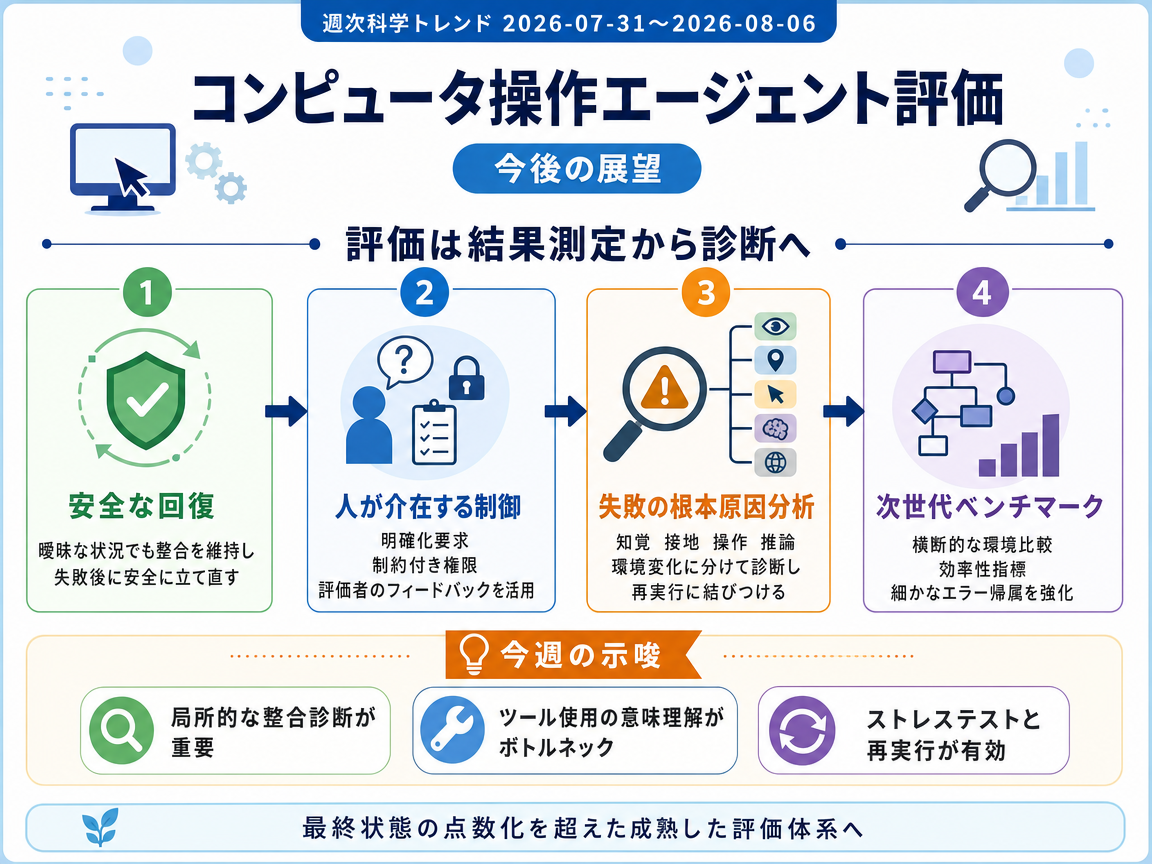
短期的な研究の焦点は、コンピューター操作エージェントがタスクを完了できるかだけでなく、曖昧な状況でも意図に沿って行動し、ツールを正しく使い、失敗から安全に回復できるかへ移る。確認を求める仕組みや権限の制限といった人間側の制御に加え、失敗時の行動履歴や評価者のフィードバックを使う安全重視の訓練が進むだろう。評価も最終結果だけでなく、一連の操作とその説明を調べる方向へ広がる。ベンチマークでは対応環境を増やし、効率を測るとともに、詳しい原因分析が再実行による修復につながるかを確かめる必要がある。プロンプトへのストレステストとデバッグ情報の改善は、導入前にまれな失敗を見つける助けになる。
インフォグラフィクス(日本語)
3年後を想定した動き
コンピューター操作エージェントの評価は、単純なタスク完了から、安全性と原因診断、回復能力を重視する方向へ移っている。1年目には、曖昧さを与えるストレステストと、操作の全過程を調べる評価器が組み合わされるだろう。ベンチマークでは、対象との対応付けの誤りや計画の失敗、記憶の問題など、能力不足の種類も分けて扱うようになる。
診断は、未知のタスクを再試行したときに改善をもたらして初めて意味を持つ。そのため研究者は、実行時の助言、不良な行動履歴の除外、訓練時のフィードバック利用を比較する。応用チームは、行動履歴と原因タグ、制御された再試行テストを検証環境へ追加するだろう。評価器同士の判定が一致しても正しさは保証されないため、重大な結果を伴う操作では人間の確認が引き続き必要になる。
2年目までに、診断結果が異なる環境にも通用すれば、再利用可能なログと複数の観点を持つ評価表が普及するはずだ。その中心となるのは、失敗記録が評価器を改善し、評価器が修復を導き、修復後のエージェントがより良い記録を残す循環である。同じ記録は、障害の検証や回帰テスト、権限制御にも使えるため、監査可能性が日常運用に役立つようになる。
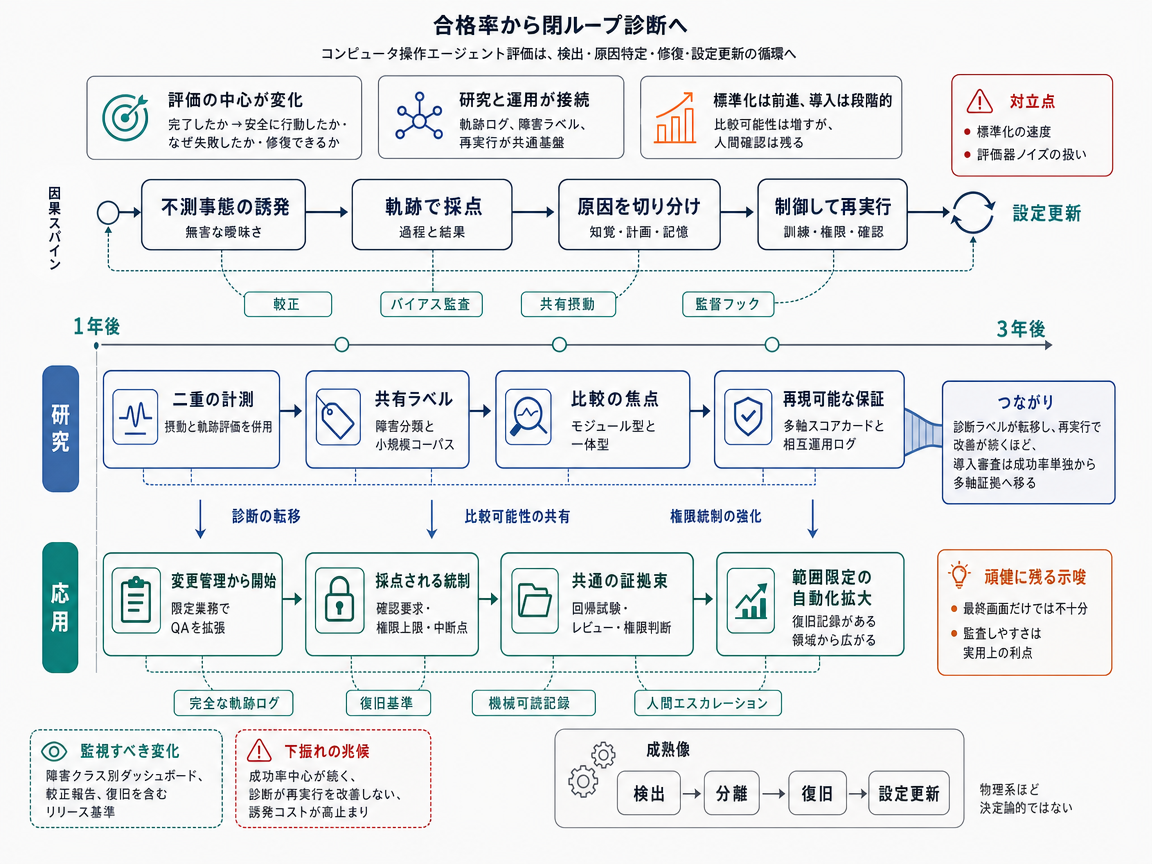
3年目ごろには、これは工学システムにおける障害の検出・切り分け・復旧に似た、閉ループ型の保証プロセスへ発展する。システムは現実的な失敗を検出して原因を特定し、条件を制御したうえで再試行する。その結果に応じて、プロンプトや権限、訓練用の証拠を調整する。成熟した組織では、権限の上限と人間への引き継ぎ経路を保ちながら、範囲を限定した自動化を広げられるだろう。共通の失敗分類や信頼度を調整した評価報告が広がり、回復試験が公開前の判定条件になれば、進展を示す強い兆候となる。一方、最終的な成功率しか報告されない場合や、診断が再試行を改善しない場合、評価器が行動を悪化させ続ける場合には、この道筋を見直す必要がある。
このシナリオでは、診断重視の評価を、範囲の限定されたデジタル作業のための局所的な保証システムへ発展させる。1年目には、研究者が危害を生みやすい重要地点を監視する「危害分析・重要管理点」の考え方を応用するだろう。エージェントの作業では、権限変更やアプリ間の情報移動、取り消せない送信などが重要地点になり得る。
操作履歴を監視記録として使い、確認要求や巻き戻しを是正手段として利用する。研究者は、重要地点を一貫して特定できるか、評価器の不一致が判断の不確かさを示すかを検証する。応用チームは、テスト環境と明確な承認段階をすでに備えた反復的な作業から始めるだろう。モデルや画面、権限方針が変わった場合は、権限を戻す前に影響範囲を絞った回帰テストを実行できる。
2年目までに、こうした確認段階が実際の運用上の障害を予測できれば、手法は異なる環境にも移しやすくなる。共通の履歴形式とプライバシーを守る分析により、元データをすべて公開せずに証拠を比較できるようになる。依存関係を考慮したテストは、変更の影響を受ける検査だけを実行し、局所的な制御を保ちながら費用を減らす。一つの確認地点で失敗しても、無関係な用途まで停止せず、影響を受ける作業だけを一時停止できる。
3年目ごろには、組織は一度限りの認定に頼らず、エージェントの権限を継続的に更新できるようになる。診断された失敗を修復し、再実行の成功を確認してから権限を慎重に広げ、その履歴を次のテスト改善に使う。研究では、組織間での判定調整や固定テストへの抜け道対策、自動評価器に対する独立監査も扱われるだろう。危険な操作や回復失敗に明確な上限を定める運用合意が現れれば、有力な進展の兆候となる。このシナリオは、再実行の費用が高すぎる場合や有用な操作履歴を取得できない場合、テスト結果が実際の障害と結び付かない場合に弱まる。画面仕様の変化や誤りの連鎖も制約として残り、評価器が判定対象のエージェントと同じ誤った前提を持つ可能性がある。
このシナリオでは、エージェントの診断テストを、製品の破壊試験を手本にした独立評価制度へ広げる。1年目には、現実的なプロンプトの変形と操作全体の評価を組み合わせ、複数環境に対応するベンチマークを整備するだろう。変化する画面上でも比較できるように、回復能力や対象との対応付けの正確さ、操作効率の共通指標を定める。
初期の研究では、再利用できる入力変形や選択的な再実行、結果の再利用によってテスト費用を抑える。その後は、失敗時の操作履歴や評価器の説明を訓練に使い、修復効果が未知のアプリにも移るかを調べる。公開済みの手順だけを覚えて安全になったように見せることを防ぐため、非公開テストは定期的に入れ替える必要がある。最初の導入は、万能な評価制度ではなく、対象を絞った保証実験になる可能性が高い。
試験機関や大規模な利用組織は、曖昧さのテストと回復訓練、権限上のわなをまとめた「エージェント衝突試験室」を構築できる。複数の主要な採用組織が、導入前に最低限の診断スコアを求め始めることが重要な転換点になる。2年目までに制度が成功すれば、評価は継続的に行われ、主要な更新ごとに試験手順の版と回帰テストが結び付けられる。スコアや操作履歴、原因分類の共通形式が整えば、再実行と判定調整を支えるツール群も発展するだろう。
3年目ごろには、開発者は主要機能を個別に評価して修復できるよう、エージェントを設計するようになる。曖昧な状況での安全性や回復性能が基準を下回れば、導入工程が公開を止める仕組みも実現できる。評価表の利用拡大がテスト範囲を広げ、新しい失敗の種類を発見し、それを修復用の証拠に変える循環が生まれる。主要な採用組織が、完了率の高いエージェントより、回復しやすく原因を診断しやすいエージェントを選べば、強い進展の兆候となる。一方、組織が実演だけに依存する場合や提供者が有用な履歴を開示しない場合、新しいシステムで評価器の一致度が崩れる場合には、この道筋を下方修正すべきである。エージェントと操作環境は物理製品より速く変化するため、継続的な再試験が欠かせない。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- Autonomous Evaluation and Refinement of Digital Agents - 著者: Jiayi Pan, Yichi Zhang, Nicholas Tomlin, Yifei Zhou, Sergey Levine, Alane Suhr, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- MMBench-GUI: Hierarchical Multi-Platform Evaluation Framework for GUI Agents - 著者: Xuehui Wang, Zhenyu Wu, JingJing Xie, Zichen Ding, Bowen Yang, Zehao Li, Zhaoyang Liu, Qingyun Li, Xuan Dong, Zhe Chen, Weiyun Wang, Xiangyu Zhao, Jixuan Chen, Haodong Duan, Tianbao Xie, Chenyu Yang, Shiqian Su, Yue Yu, Yuan Huang, Yiqian Liu, Xiao Zhang, Yanting Zhang, Xiangyu Yue, Weijie Su, Xizhou Zhu, Wei Shen, Jifeng Dai, Wenhai Wang, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- When Benign Inputs Lead to Severe Harms: Eliciting Unsafe Unintended Behaviors of Computer-Use Agents - 著者: Jaylen Jones, Zhehao Zhang, Yuting Ning, Eric Fosler-Lussier, Pierre-Luc St-Charles, Yoshua Bengio, Dawn Song, Yu Su, Huan Sun, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Qwen-CUA: Native Computer Use for (almost) Everything - 著者: Dunjie Lu, Shuai Bai, Tianyi Bai, Sicheng Fan, Chang Gao, Jian Guan, Feng Hu, Mianqiu Huang, Xingyang Huang, Yizhen Jiang, Yuheng Jing, Dehui Kong, Ning Li, Dayiheng Liu, Shixuan Liu, Zheng Liu, Que Shen, Bowen Wang, Junli Wang, Chencan Wu, Rui Xie, Tianbao Xie, Zhihui Xie, Haiyang Xu, An Yang, Tao Yu, Wenzhen Yuan, Xi Zhang, Zhenru Zhang, Mingkang Zhu, Zhaoqing Zhu, Yizhong Cao, Kai Dang, Binyuan Hui, Kaixin Li, Junyang Lin, Haiquan Wang, Zekun Wang, Yiheng Xu, Fan Yan, Mengqi Yuan, Danyang Zhang, Jiajun Zhang, Zhipeng Zhang, Fan Zhou, Fan Zhou / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- CUADebug: Diagnosing and Repairing Computer-Use Agent Failures - 著者: Weijia Zhang, Kunlun Zhu, Zeyi Liu, Yinting Chen, Tianyi Ma, Jiateng Liu, Jiaxun Zhang, Bingxuan Li, Xiangru Tang, Heng Ji, Jiaxuan You / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- Dr. AGENTONOMICS: A Didactic Experiment of AGENTONOMICS - 著者: Fengjunjie Pan, Alois Knoll / <See Details on Fugu-MT> / ライセンス: CC BY 4.0