サマリー
本テーマは、視覚的品質のみならず、物体の同一性の保持、複数物体の動きの制御、空間的一貫性の評価を中心としている。今週の成果は、これらの課題をマルチショットの演出やインタラクティブな世界モデルへと拡張しており、そこでは生成される事象が行動に視覚的に応答するだけでなく、明示的なルールと持続的な隠れ状態に従う必要がある。
テーマの状況
代表的な序論では、物体レベルの一貫性が有用な生成における中心的な制約であるとされている。ObjectMoverは動画拡散の事前知識を単一画像での物体移動に転用し、同一性の保持、視点の変化、照明と影の一貫性を目標とするとともに、ペアデータの不足にはゲームエンジンによる合成データと補助的な実動画学習で対処している。LayerT2Vは、衝突する複数物体の軌跡の問題に対し、後のレイヤーが前のレイヤーを遮蔽する形で動画をレイヤー単位で生成することで対処している。MVGBenchは、生成された各視点を単一の正解と個別に比較する方法では3Dの不整合を見逃すと主張する。同研究は正解不要の3D一貫性指標を提案し、3D一貫性と画像品質のトレードオフ、合成データと実データの間に残るギャップ、入力摂動に対する頑健性の限界を報告している。
今週の「State World Models: Execute the Rules, Generate the Pixels」(2610.26811v1)の成果は、一貫性の問題をインタラクションの結果へと拡張している。すなわち、同一の視点と行動であっても、隠れ状態に応じて異なる結果が求められうる。そのStateful Harnessは、ルールの実行を凍結された動画モデルによるレンダリングから分離し、空間的ガイダンスには3Dシーンプレビューを、生成クリップからの状態更新には視覚言語モデルを用いる。これらの研究を合わせると、制御可能性は軌跡への追従以上のものとして捉えられる。生成コンテンツは空間的関係を保持し、持続的な世界状態が要求する結果を忠実に描写する必要もある。
- ObjectMover: Generative Object Movement with Video Prior
- MVGBench: Comprehensive Benchmark for Multi-view Generation Models
- LayerT2V: Interactive Multi-Object Trajectory Layering for Video Generation
- PVBench: Quantifying Physical Plausibility in Video Generation with Object-Level Physical Measurements
- Mise-en-Video: Fine-Grained 3D Control for Multi-Shot Video Generation
- State World Models: Execute the Rules, Generate the Pixels
インフォグラフィクス(日本語)
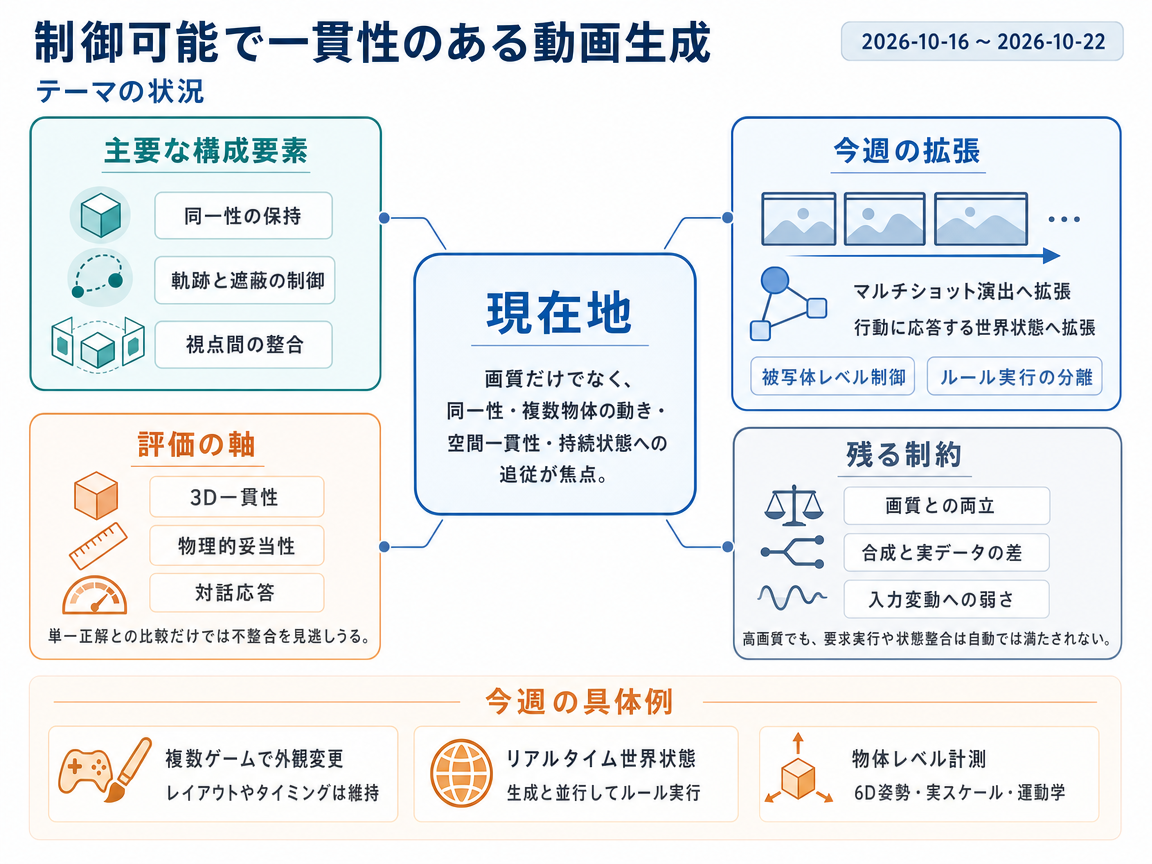
今週の進展
AnyGameRenderer: Entity-Consistent Generative Rendering Across Games and an Entity-Level Benchmark <See Details on Fugu-MT>
AnyGameRendererは、複数のゲームの映像に対してエンティティ一貫性のある生成的レンダリングを適用する。 レイアウト、カメラ、エンティティ、タイミングを固定したまま視覚的外観を変更する。
Matrix-Game 4.0: Harnessing Video Models for Real-Time Playable Game Worlds <See Details on Fugu-MT>
Matrix-Game 4.0は、動画モデル上にリアルタイムでプレイ可能なゲーム世界を構築する。 軽量なゲームエンジンが動画生成と並行して世界状態を維持し、インタラクションのルールを実行する。
StreamEval: Evaluating Interactive Streaming Video Generation Models <See Details on Fugu-MT>
StreamEvalは、5つのタスクにわたるインタラクティブなストリーミング動画生成のための統一ベンチマークを導入する。 高い視覚的品質や同一性の保持が、リクエストの確実な実行や持続的状態の一貫性を保証しないことを見出している。
Mise-en-Video: Fine-Grained 3D Control for Multi-Shot Video Generation <See Details on Fugu-MT>
Mise-en-Videoは、3Dで演出された被写体レベルの制御をマルチショット動画生成にもたらす。 動画品質、ショット間の一貫性、被写体レベルの制御性においてベースラインを上回る改善を報告している。
State World Models: Execute the Rules, Generate the Pixels <See Details on Fugu-MT>
Stateful Harnessは、ルールに支配される世界の発展を凍結された動画レンダリングから分離する。 ターンをまたいで持続的状態を引き継ぎ、反事実的なテストペアにおいてルールに準拠した結果で大幅な改善を示している。
PVBench: Quantifying Physical Plausibility in Video Generation with Object-Level Physical Measurements <See Details on Fugu-MT>
PVBenchは、46の評価次元にわたって生成動画の物理的妥当性を定量化する。 外観や二値的な意味判断ではなく、6D姿勢、実スケール、運動学といった物体レベルの測定を用いる。
今後の展望
今後の展望(要約)
生成技術は、物体や場面をより厳密に制御しながら、複数ショットの映像や状態が持続する対話型環境へ進む可能性が高い。ObjectMoverは姿勢を条件とする学習と物体が交差する事例を提案し、蒸留による推論コストの削減も目指している。LayerT2Vは新しい基盤モデルの採用を計画しているが、軌道制御を背景の意味と整合させる課題は残る。明示的な3D配置と、エンジンによる状態管理は、互いを補う手法になり得る。評価では見た目だけでなく、空間関係や物理法則、状態の一貫性を重視すべきである。少数の視点からでも信頼できる採点を行い、多様な場面条件に対応することが優先課題となる。PVBenchは、評価器の各要素の検証や追跡性能の改善に加え、物理エンジンの参照データを使い、正確な制御と持続する結果を、単に自然に見える出力から区別することを提案している。
インフォグラフィクス(日本語)
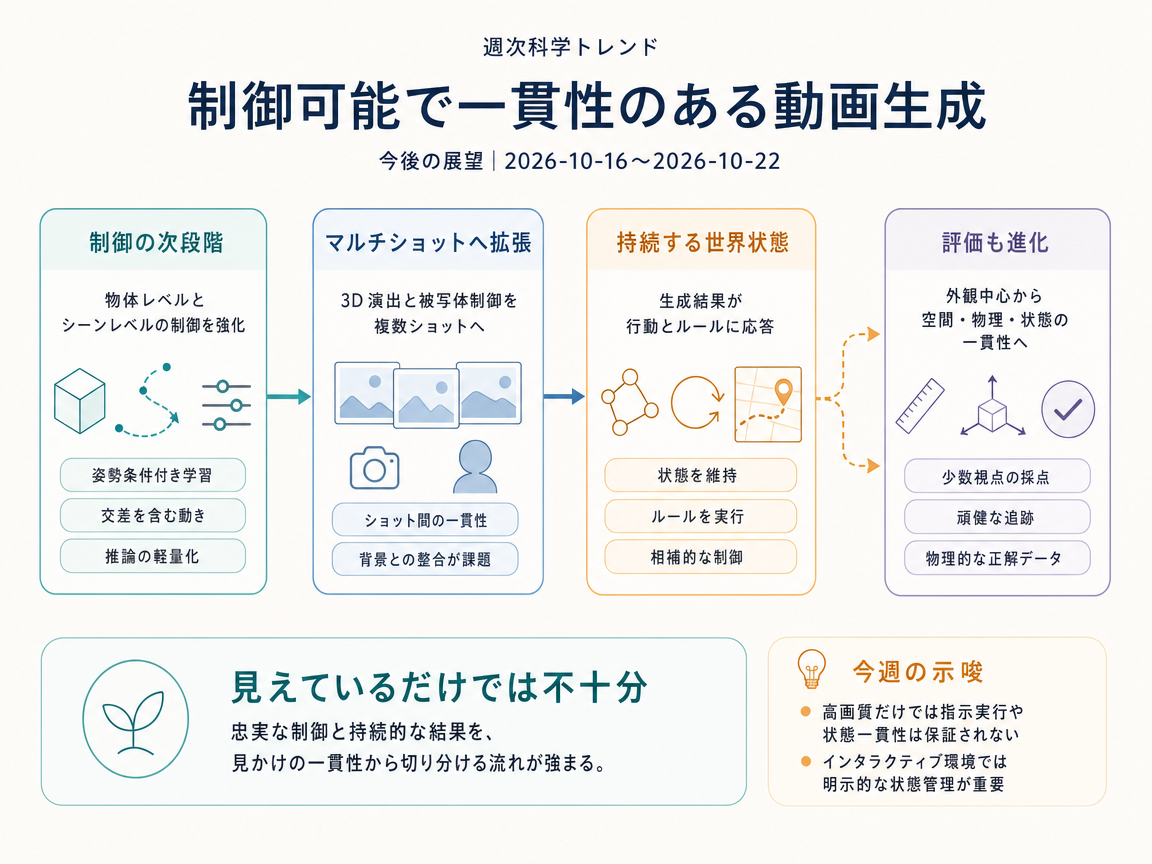
3年後を想定した動き
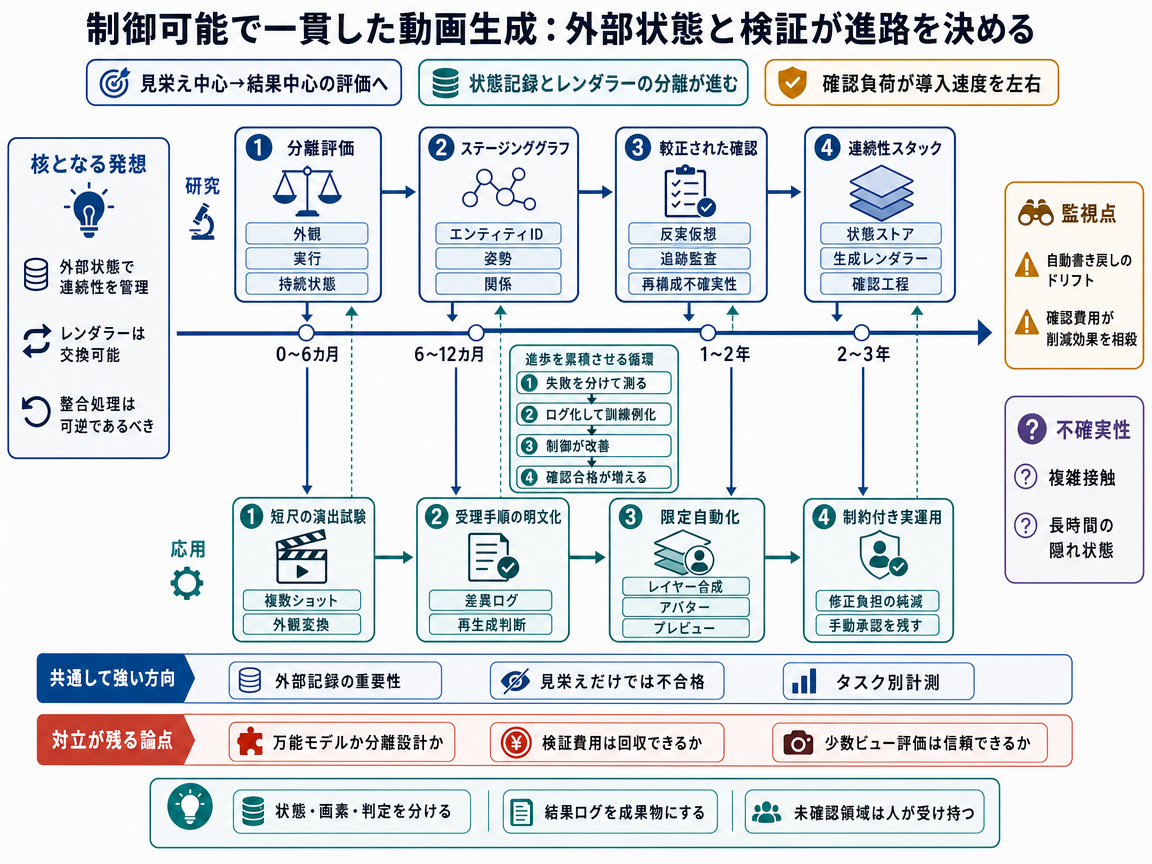
今後3年間でこの方向が進めば、明示的なシーン記録が映像生成を導き、確認担当者が連続性の破綻を見つけやすくなる作業工程が実現し得る。出発点は物体制御の改善だが、今週の報告は、シーン構造や相互作用の規則を生成器の外部に置けることも示している。1年目には、直ちに統合モデルを構築するのではなく、既存の編集システムを小規模なシーン記述や規則実行ソフトウェアに接続するだろう。初期試験では、要求された動きを保ちながら手作業による修正を減らせるかを調べ、特に物体が交差したり一時的に画面外へ消えたりする場合を確かめる。
2年目には、共有されたシーン記述が簡単な相互作用規則とともに複数ショットの生成をつなぎ、まずは少数の実体だけを含む試作映像で使われる可能性がある。この記述は、どの実体が存在し、互いにどう関係するかを記録するため、チームは意図したシーンを作り直さずに失敗を調査したり描画器を変更したりできる。評価では生成器の誤りと測定の誤りを分ける必要があり、追跡器が隠れた物体を見失っただけでは、生成された場面からその物体が消えたとは判断できない。3年目までに、成果を上げた試行は、明示的な舞台構造と持続的な状態保存機構を描画器に組み合わせ、出力を別工程で検査する形へ進むだろう。中心的な研究課題は、保存された記録と画像が食い違う場合に、再生成と人による承認のどちらを選ぶかを含め、その不一致をどう解決するかになる。
検査が具体的な失敗を明らかにし、その記録を新たな学習例へ変換できれば、後の出力は制御しやすく検証もしやすくなり、進歩が積み重なる。重要な観測指標は、条件をそろえた作業工程の比較で修正の手間が減ることであり、シーン記録と描画結果の不一致箇所を説明する報告も必要になる。長い系列の試験では、小さな誤りが蓄積するにつれて、自動更新が実体を勝手に追加したり消したりしないかも確認すべきである。これは範囲を限定した制作作業で成立し得る条件付きの道筋であり、3年以内に汎用的で信頼できるシミュレーションが実現する証拠ではない。外部記録に測定可能な利点がない場合や、検査に生成時の節約分を上回る手間がかかる場合、この道筋の実現性は低下する。
今後3年間でこのシナリオが進めば、評価では正しい動作とその後も残る結果が重視され、研究者が選ぶシステム設計も変わり得る。この方向は物体制御の改善と明示的なシーン配置に基づくが、最近報告された知見の信頼性を判断するには、まず独立した再現実験が必要である。1年目には、研究者は見た目に基づく順位と、指示への適合や状態の保持を調べる試験を比較するだろう。ここでの状態保持とは、前に起きた出来事が後の場面にも影響し続けることを意味する。追跡の失敗を生成映像の失敗と取り違えないよう、結果が既知のシーンを使って試験を調整する必要もある。
実用的な試行では、こうした検査が修正を減らせるかを測り、描画時間と結果の確認時間を分けて記録する。2年目の決定的な変化は、最低限の視覚品質を条件としつつ、正しい結果を主な基準としてシステムを順位付けする有力なベンチマークの登場である。これは、相互作用の要件を画像とは別に保存し、意図した動作を調査しやすい明示的な状態エンジンに有利に働く可能性がある。ベンチマークの利用が広がると参加システムが増え、難しい事例から測定上の弱点が見つかり、評価方法の改善につながるという循環が生まれる。制作チームは、よく理解された作業に対して文書化された誤差限界を設け、不確実な結果には人の確認を残しながら、一部を自動化できるようになる。
3年目には、視認性や表現様式の変化が評価器の有効性を損なうため、難しい視覚条件をまたぐ調整が中心的な研究課題になる。すべての用途や表現に同じ基準を課すのではなく、評価は物理的な妥当性を重視する系統と、見た目を優先する創作系統に分かれるかもしれない。物理的な妥当性を重視する系統では、一部の研究チームが持続的な状態管理と段階的な描画を接続し、複数の実体の相互作用やショット間の移行まで検証範囲を広げる可能性がある。重要な観測指標は、単独のベンチマーク成績ではなく、結果に関する独立した報告が広まり、実際の修正作業も減ることである。順位差が評価器の誤差範囲に収まる場合や、統合型モデルが同等の品質と応答時間を達成する場合、この道筋の優位性は弱まる。
今後3年間でこのシナリオが進めば、研究の焦点は、より多くの映像を生成することから、無理のない費用と手間で正しさを確認できる映像を作ることへ移る可能性がある。より厳密な制御と充実した評価が出発点になるが、転機となるのは、出力確認が深刻なボトルネックになっているという証拠である。1年目には、研究者は低コストの予備検査と詳細な試験を比較し、既知の状態を持つエンジン生成シーンで測定方法を調整するだろう。予備検査は問題の可能性を示すだけで、正しさを保証するものではない。制作向けの試作システムはシーン構造を確認可能にし、担当者が具体的な失敗箇所を見つけられるようにする。初期の有用な試行では、生成速度だけで進歩を判断せず、修正の手間と確認済み出力の割合を報告する必要がある。
2年目には、ベンチマークの運営者が、どの出力に完全な検査を行ったか、予備検査がその結果とどの程度一致したかの開示を求める可能性がある。意図した出来事の記録と抽出した画像の検査を組み合わせて確認作業を減らせるなら、構造化されたシステムが有利になる。確認の低コスト化が明示的なシーン記録の採用を促し、利用の拡大によって、後の受け入れ手順を改善する再利用可能な証拠が蓄積される。この循環は共有型の評価サービスによって支えられる可能性がある一方、その運営者が信頼性の基準に強い影響を持つおそれもある。
3年目には、複数ショットの配置や階層的な合成など、範囲を限定した作業で再現可能な受け入れ工程が日常的に使われる可能性がある。研究者は参照シーンをより難しい条件へ広げ、制作チームはショットごとの修正作業を記録し、互換性のあるツール間で検査記録を再利用するだろう。一貫性を確認済みと主張できるシステムと、確認に高い手間がかかる探索的システムに分かれる可能性もあるが、これは画像品質の優劣を直接示すものではない。最も明確な観測指標は、確認待ちが長く続く一方で、構造化された記録を使うと、正しく受け入れられた出力当たりの総作業量が減るという比較結果である。完全な評価が安価になった場合や、画像の不一致を見つけるために非常に細かな検査が必要で、正確な出来事の記録を使っても手間がほとんど減らない場合、このシナリオの可能性は低下する。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- ObjectMover: Generative Object Movement with Video Prior - 著者: Xin Yu, Tianyu Wang, Soo Ye Kim, Paul Guerrero, Xi Chen, Qing Liu, Zhe Lin, Xiaojuan Qi / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- MVGBench: Comprehensive Benchmark for Multi-view Generation Models - 著者: Xianghui Xie, Chuhang Zou, Meher Gitika Karumuri, Jan Eric Lenssen, Gerard Pons-Moll / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- LayerT2V: Interactive Multi-Object Trajectory Layering for Video Generation - 著者: Kangrui Cen, Baixuan Zhao, Yi Xin, Siqi Luo, Guangtao Zhai, Xiaohong Liu / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- PVBench: Quantifying Physical Plausibility in Video Generation with Object-Level Physical Measurements - 著者: Kaiwei Chen, Moran Li, Zhenye Gan, Yabiao Wang, Chengjie Wang, Kexin Zhang, Yong Liu, Jiangning Zhang / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- Mise-en-Video: Fine-Grained 3D Control for Multi-Shot Video Generation - 著者: Yingshuang Zou, Xiaoyu Shi, Yawen Luo, Ziang Li, Qinghe Wang, Mengfei Li, Chengfeng Zhao, Xintao Wang, Pengfei Wan, Kun Gai, Yuan Liu / <See Details on Fugu-MT> / ライセンス: CC BY 4.0
- State World Models: Execute the Rules, Generate the Pixels - 著者: Chan Yan Ki, Yanran Zhang, Wenzhao Zheng, Xiaofeng Wang, Zheng Zhu, Lei Chen, Jie Zhou, Jiwen Lu / <See Details on Fugu-MT> / ライセンス: CC BY 4.0