サマリー
本テーマは、純粋な光度フィッティングを超え、スパースビューや単眼条件下での3D/4D再構成・レンダリングの実用化を目指すものである。代表的な論文では、3Dガウシアンスプラッティングに、より強力なモーション・物理・インタラクション事前知識を組み合わせることで、動的一貫性、物理的妥当性、レンダリング効率の向上を図っている。
テーマの状況
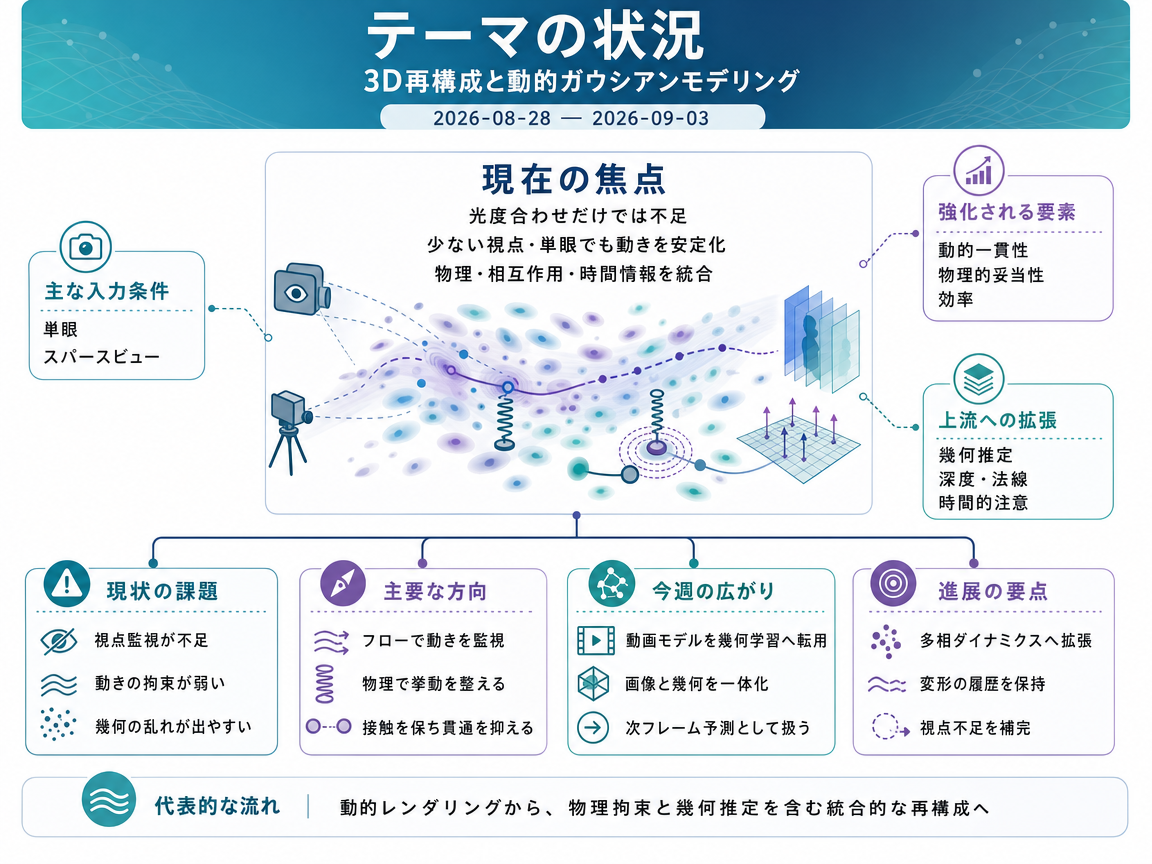
代表的な研究は、マルチビュー監視が不十分、高コスト、または利用不可能な状況における動的3Dコンテンツの再構成を中核的課題として位置づけている。GaussianFlowは、標準的な4D NeRFおよび4Dガウシアン手法は効率的であるが、主に光度損失で学習した場合、特に単眼やスパースビュー動画において動的挙動の制約が不十分であると主張し、ガウシアンの動きをピクセル速度に直接結びつけるオプティカルフローベースの監視を導入している。PhysMotionとHOGSは同じ方向をさらに推し進め、3Dガウシアンパイプラインをより物理的に基盤のあるものにしている。PhysMotionはシミュレータベースの3Dダイナミクスと拡散モデルによる精緻化を用いた単一画像からの動画生成を対象とし、HOGSはスパースビューでの人物・物体レンダリングにおいて妥当な接触を強制し相互貫通を低減している。
今週のエビデンスは、テーマを動的レンダリングから上流のジオメトリ推定へと拡張している。「Video Generative Models as Geometry Learner」(2608.28549v1)では、画像拡散モデルがジオメトリを画像とジオメトリの相互作用をモデル化せず特殊な画像として扱うことで単眼深度・法線予測に限界が生じると主張し、代わりに動画生成モデルを転用してジオメトリを次フレーム予測タスクとして扱い、時間的アテンション事前知識を活用した画像・ジオメトリの統合モデリングを実現している。
- GaussianFlow: Splatting Gaussian Dynamics for 4D Content Creation
- PhysMotion: Physics-Grounded Dynamics From a Single Image
- Physics-Aware Human-Object Rendering from Sparse Views via 3D Gaussian Splatting
- Video Generative Models as Geometry Learner
インフォグラフィクス(日本語)
今週の進展
VersaGauss: A Versatile Framework for Generating Multiphase Dynamics with 3D Gaussians <See Details on Fugu-MT>
VersaGaussは、多相相互作用を含む物理ベースダイナミクスの生成・シミュレーション・レンダリングのための統一的なガウシアンベースフレームワークを提供する。 物理的に基盤のあるガウシアンパイプラインを、単一物体やペアワイズの設定を超えて多相ダイナミクスへと拡張している。
EvoGS: Modeling Deformation Evolution for Dynamic Gaussian Splatting <See Details on Fugu-MT>
EvoGSはガウシアンの変形を時間的進化プロセスとしてモデル化し、持続的な変形状態を維持しつつ、各原点の観測による予測補正を行う。 フレームごとの変形アプローチとは異なり、履歴状態を引き継ぐことで、動的な新視点合成の品質を向上させている。
GSPotential: Camera Potential Field for Sparse-View 3D Gaussian Splatting <See Details on Fugu-MT>
GSPotentialは、ビュー監視の不均衡を定量化するカメラポテンシャル場を導入し、スパースビュー3DGSの課題に取り組んでいる。 限られたビュー下でのガウシアン最適化を導く明示的メカニズムを提供し、過学習や幾何学的アーティファクトを低減する。
SMG: Semantic Motion Graph for Monocular Dynamic Gaussian Splatting <See Details on Fugu-MT>
SMGはセマンティックモーショングラフを用いてガウシアンの動きを低ランクのセマンティックモーションとしてモデル化し、単眼動的シーンを対象としている。 構造化されたセマンティック事前知識を導入し、実世界ベンチマークにおいて最先端の単眼動的ガウシアンスプラッティング性能を達成している。
InceptionGS: Generative Bootstrapping for Large-Scale Gaussian Splatting under Unstructured View Sampling <See Details on Fugu-MT>
InceptionGSは、非構造的なビューサンプリング下での大規模ガウシアン再構成に取り組み、生成によって再構成をブートストラップする。 他の領域の品質を保ちつつ、観測不足の領域を選択的に修復し、シーンスケールでの弱ビューカバレッジの問題に対処している。
今後の展望
今後の展望(要約)
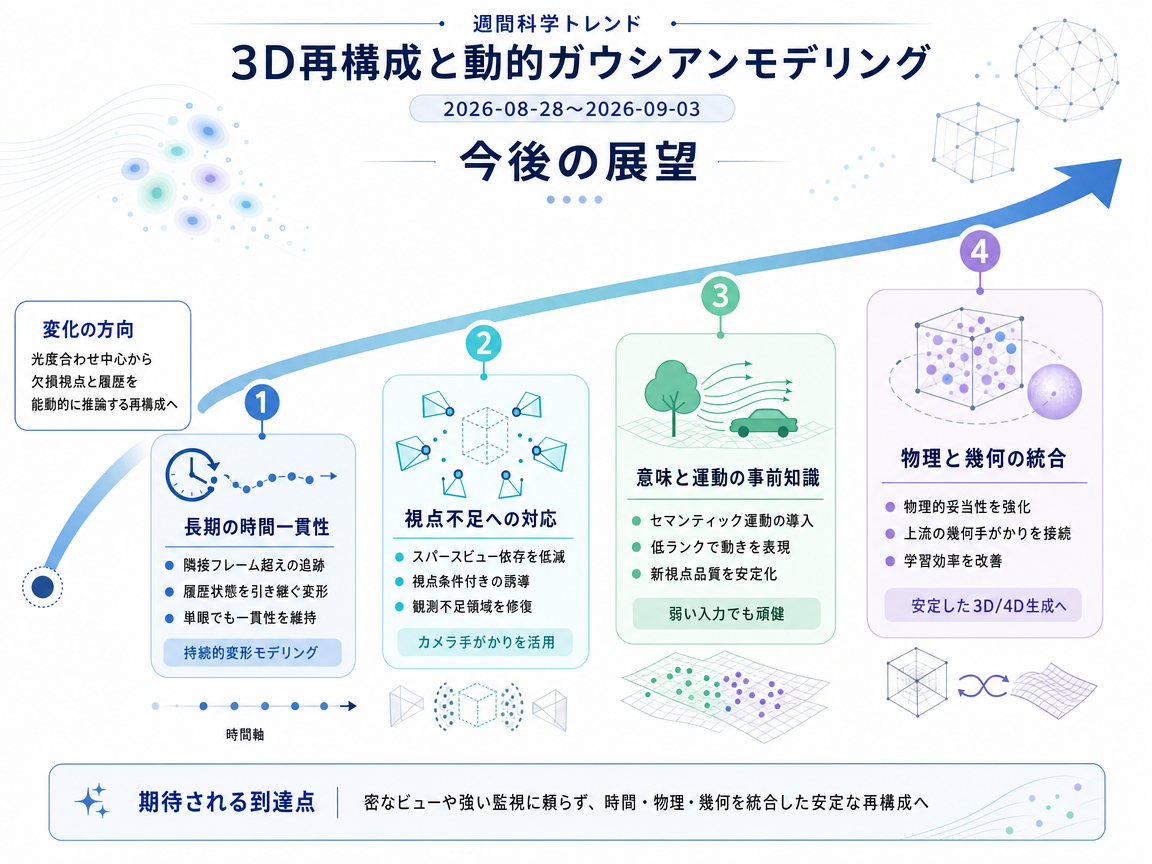
動的ガウシアン再構成は、より長い動きの履歴を扱い、単眼映像や少数視点の入力で欠けた視点を補う方向へ進んでいる。長期的な動きの監督と視点に応じたガイダンスを組み合わせれば、観測が不十分な領域だけを補修しながら、シーンの変形を一貫させられる可能性がある。もう一つの方向は、精度の高い形状推定に物理的制約と効率的な学習を組み合わせることだ。PhysMotionとHOGSは、見た目を改善するときに色を保つこと、多段階処理を減らすこと、単純な相互作用を超えることの重要性を示している。これらが進展すれば、少ない観測からでも、より安定して物理的に自然な3D・4Dシーンを生成できる可能性がある。ただし、追加のガイダンスが計算量を増やしすぎず、時間方向の一貫性を実際に高めることが条件となる。
インフォグラフィクス(日本語)
3年後を想定した動き
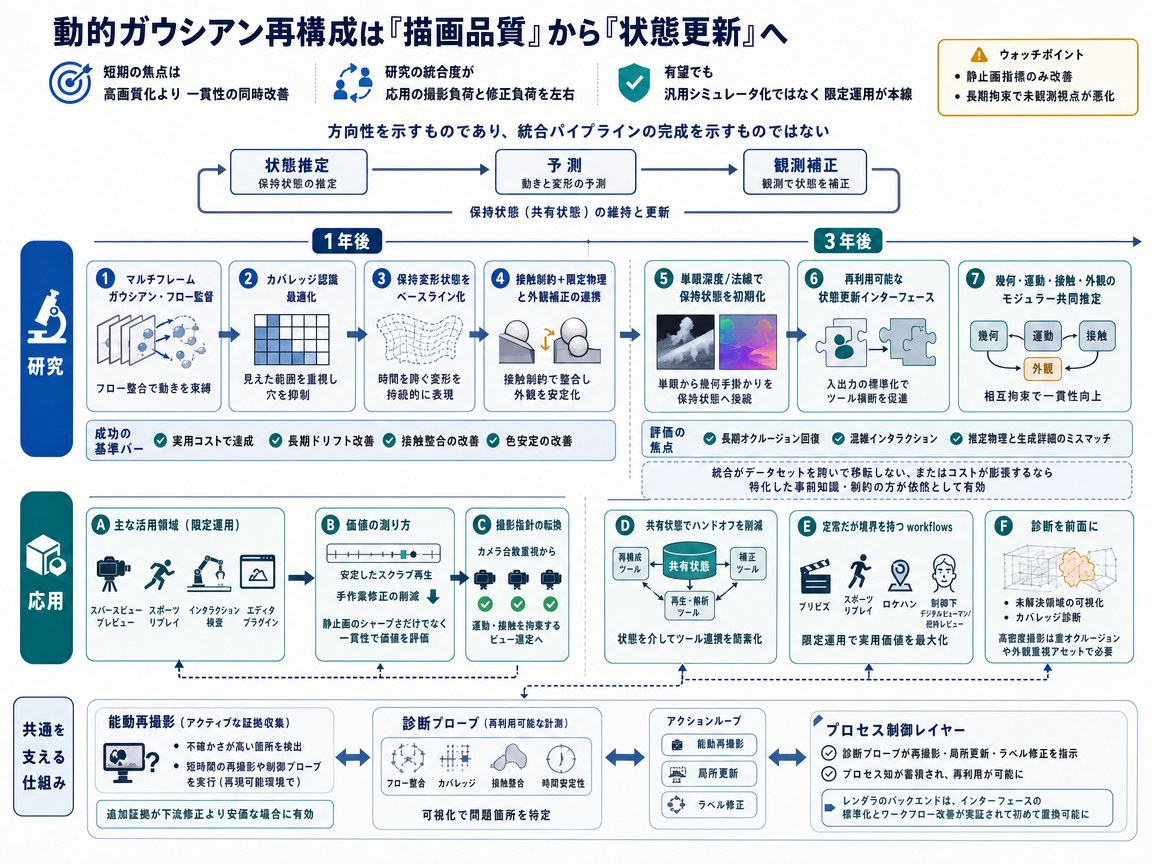
今後およそ3年で、動的ガウシアン再構成の個別技術が統合され、画像ごとにモデルを当てはめ直すのではなく、時間を通じて一つのシーン推定を維持するモジュール型の処理手順へ発展する可能性がある。その仕組みは気象データ同化に似ており、シーンの変化を予測した後、不完全なカメラ観測で予測を修正しつつ、過去の動きを保持する。初年度には、動きの検査を複数フレームに広げ、記憶した変形がカメラで十分に見えない領域の一貫性を改善するかを調べる。見た目の調整では、シミュレーションされた動きと色を保つ必要があり、静止画の鮮明さだけでなく、再生の安定性や手作業による修正の減少も評価基準になる。
2年目には、単眼映像から得た初期深度と表面方向の推定を使い、ガウシアン最適化の前に、継続的なシーンモデルへより良い幾何学的な出発点を与えられる可能性がある。研究者は、共有モデルへの更新が、限られた範囲の複数物体の相互作用を扱えるかを検証する。その際、誤った接触関係や材質の仮定によって再構成が崩れないことが重要になる。一部のコンテンツ制作ツールでは、人物や物体の同一性のちらつきを抑えながら、少ない映像からシーンを作れるようになるかもしれない。ただし、人による修正手段を残し、見た目の自然さと物理的な正確さを区別する必要がある。
3年目までには、有効な構成要素が共通のシーン表現を利用し、生成による補修と見た目の調整を別々に制御できるようになる可能性がある。これにより、問題が起きたときに原因を切り分けやすくなる。事前可視化やスポーツ映像の再現など、用途を限定した利用はより一般的になり、撮影支援や要確認領域の明示も組み込まれるだろう。一貫したシーンが後段の動きと接触の推定を改善し、その推定が次の修正を助けるという有益な循環も生まれ得るが、独立した検査は引き続き必要である。重要な観測指標は、実用的な総処理コストと安定した色を保ちながら、長時間の動きのずれと接触誤りが減ることだ。静止画だけが改善して時間方向の品質が向上しない場合や、撮影と修正の負担が変わらない場合、このシナリオの実現性は低下する。
今後およそ3年で、再構成は固定された記録を処理する方式から、シーンの不確実性を解消するために必要な観測の収集を案内する方式へ移る可能性がある。その仕組みはロボティクスに由来し、複数の説明を見分けられる行動を選ぶ。たとえば短くカメラを動かし、見かけ上の接触が実在するかを確認する。初年度には、再構成候補間の不一致が、単なる模様の乏しさや照明変化ではなく、未観測視点での誤りを予測できるかを検証する。決定的な観測指標は、時間と移動量を同じにした二つの制御環境で、推奨された撮影が無作為な撮影や単純な範囲重視の案内を上回ることである。
初期のツールは不確実な領域を示し、人の承認を得たうえで追加撮影を提案するだろう。最初は、再現可能な卓上での相互作用や、人と物体を含む管理された撮影が対象になる。2年目には、継続的なシーン記録に新しい観測を加え、シーンの同一性を失ったり、モデル当てはめを最初からやり直したりせずに再構成を更新できるようになる可能性がある。物体の回転や把持の解除といった制御された行動は、別のカメラ角度だけでは判別できない接触状態を見分ける助けになる。情報量の多い観測がシーン推定を改善し、改善された推定が次の撮影提案を良くするという循環が生まれる。無駄な撮影が減れば、作業者も案内に従いやすくなる。
約36カ月後には、再利用可能な撮影モジュールが、追加観測を求めるべき時点と、定められた品質目標に対して証拠が十分になった時点を判断できるかもしれない。ツールは、追加撮影と制約付きの再調整、明示された生成補完の中から適切な処理を選び、区別できない解釈は複数のまま保持する。受け入れ検査は指定された視点と相互作用を対象とし、実測領域と生成領域を区別して、シーン全体が検証済みであるかのような印象を避ける必要がある。単純な撮影範囲の案内でも同等の結果が得られる場合や、追加映像の取り込みにほぼ全面的な再学習が必要な場合、この道筋は弱まる。この方式が適するのは、観測を追加できる反復可能で制御された撮影であり、再現できない出来事の既存映像には適用しにくい。
より長期的には、個別の再構成手法を並べる段階から、完成画像だけでなく中間のシーン推定を検査する共通の工程制御層へ移る可能性がある。現在の研究は、動きの監督と接触制約、持続的な変形表現を通じて、この方向に必要な要素を提供している。しかし、提示された証拠からは、それらを統合したシステムが成立するとはまだ確認できない。その仕組みは半導体の工程制御に似ている。処理中に測定を行うことで、最終出力が完成する前に誤りの位置を特定し、修正を導ける。
再構成における「プローブ」は、支えのない形状や一貫しない動きなど、疑われる不具合を検出する再利用可能なモジュールである。これは単に完成結果の品質を採点するのではなく、処理途中でどこが崩れたかを示す。3年程度の時点で中心となる可能性は、こうしたプローブが個別論文専用の検査ではなく、共通基盤の構成要素として使われ始めることだ。複数の再構成方式で同じ検査を利用できれば、失敗原因の比較や修正方法の共有が容易になる。
最も明確な観測指標は、共有された再構成処理の中でプローブが繰り返し再利用され、中間測定が実際の修正を導くことである。また、異なる手法でも同じ種類の不具合を検出できるかが重要になる。ただし、この見通しは条件付きである。報告されている進展の一部は方向性を示す信号にとどまり、共通の制御層が有効に機能することを詳しく実証したものではない。
1年後・3年後の研究/応用インフォグラフィクス
参照論文
- GaussianFlow: Splatting Gaussian Dynamics for 4D Content Creation - 著者: Quankai Gao, Qiangeng Xu, Zhe Cao, Ben Mildenhall, Wenchao Ma, Le Chen, Danhang Tang, Ulrich Neumann, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- PhysMotion: Physics-Grounded Dynamics From a Single Image - 著者: Xiyang Tan, Ying Jiang, Xuan Li, Zeshun Zong, Tianyi Xie, Yin Yang, Chenfanfu Jiang, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Physics-Aware Human-Object Rendering from Sparse Views via 3D Gaussian Splatting - 著者: Weiquan Wang, Jun Xiao, Yueting Zhuang, Long Chen, / <See Details on Fugu-MT> / ライセンス: CC-BY-4.0
- Video Generative Models as Geometry Learner - 著者: Haosen Yang, Jifei Song, Zhensong Zhang, Xiatian Zhu, Jiankang Deng / <See Details on Fugu-MT> / ライセンス: CC BY 4.0